Skild AIが、ロボット向け基盤モデル「S1」の成果を公開しました。やってほしい作業を撮った動画を1本見せるだけで、学習し直すことなくその作業を実行します。訓練データに含まれていない10分級の長い手順でも動くとされ、産業用ロボットにつきものだった「新しい仕事を覚えさせるたびにデータを集めて再訓練する」という前提を外しにきたモデルです[1][2]。
動画を1本見せるだけ、重みは書き換えない
工場や倉庫の現場は、扱う製品もレイアウトも頻繁に変わります。ところが多くの産業用ロボットは決まった作業に合わせて作り込まれているため、工程が1つ増えるたびにデータ収集と再訓練、そして検証のやり直しが発生します[1]。
S1がとったのは別の道です。作業者が手本の動画を撮り、それをそのままモデルへのプロンプトとして渡します。S1は映像から意図と対象物、手順の並びを読み取り、目の前のロボットの動作に置き換えます。このときモデルの重みは一切更新しません。大規模言語モデルで言うところの文脈内学習(in-context learning)を、ロボットの操作に持ち込んだ格好です[1][2]。
ロボット学習はこれまで、言語で指示を出す方式(VLA)が主流でした。ただ「マグカップを取って」のような単純な動作なら言葉で足りても、布を畳む、卵白を泡立てる、紐を結ぶといった作業は、人間同士でも言葉ではなく手本を見せて教えます。S1はその「見せて教える」をそのまま設計思想にしています[2]。
未経験の10分作業で、成功率は7倍以上
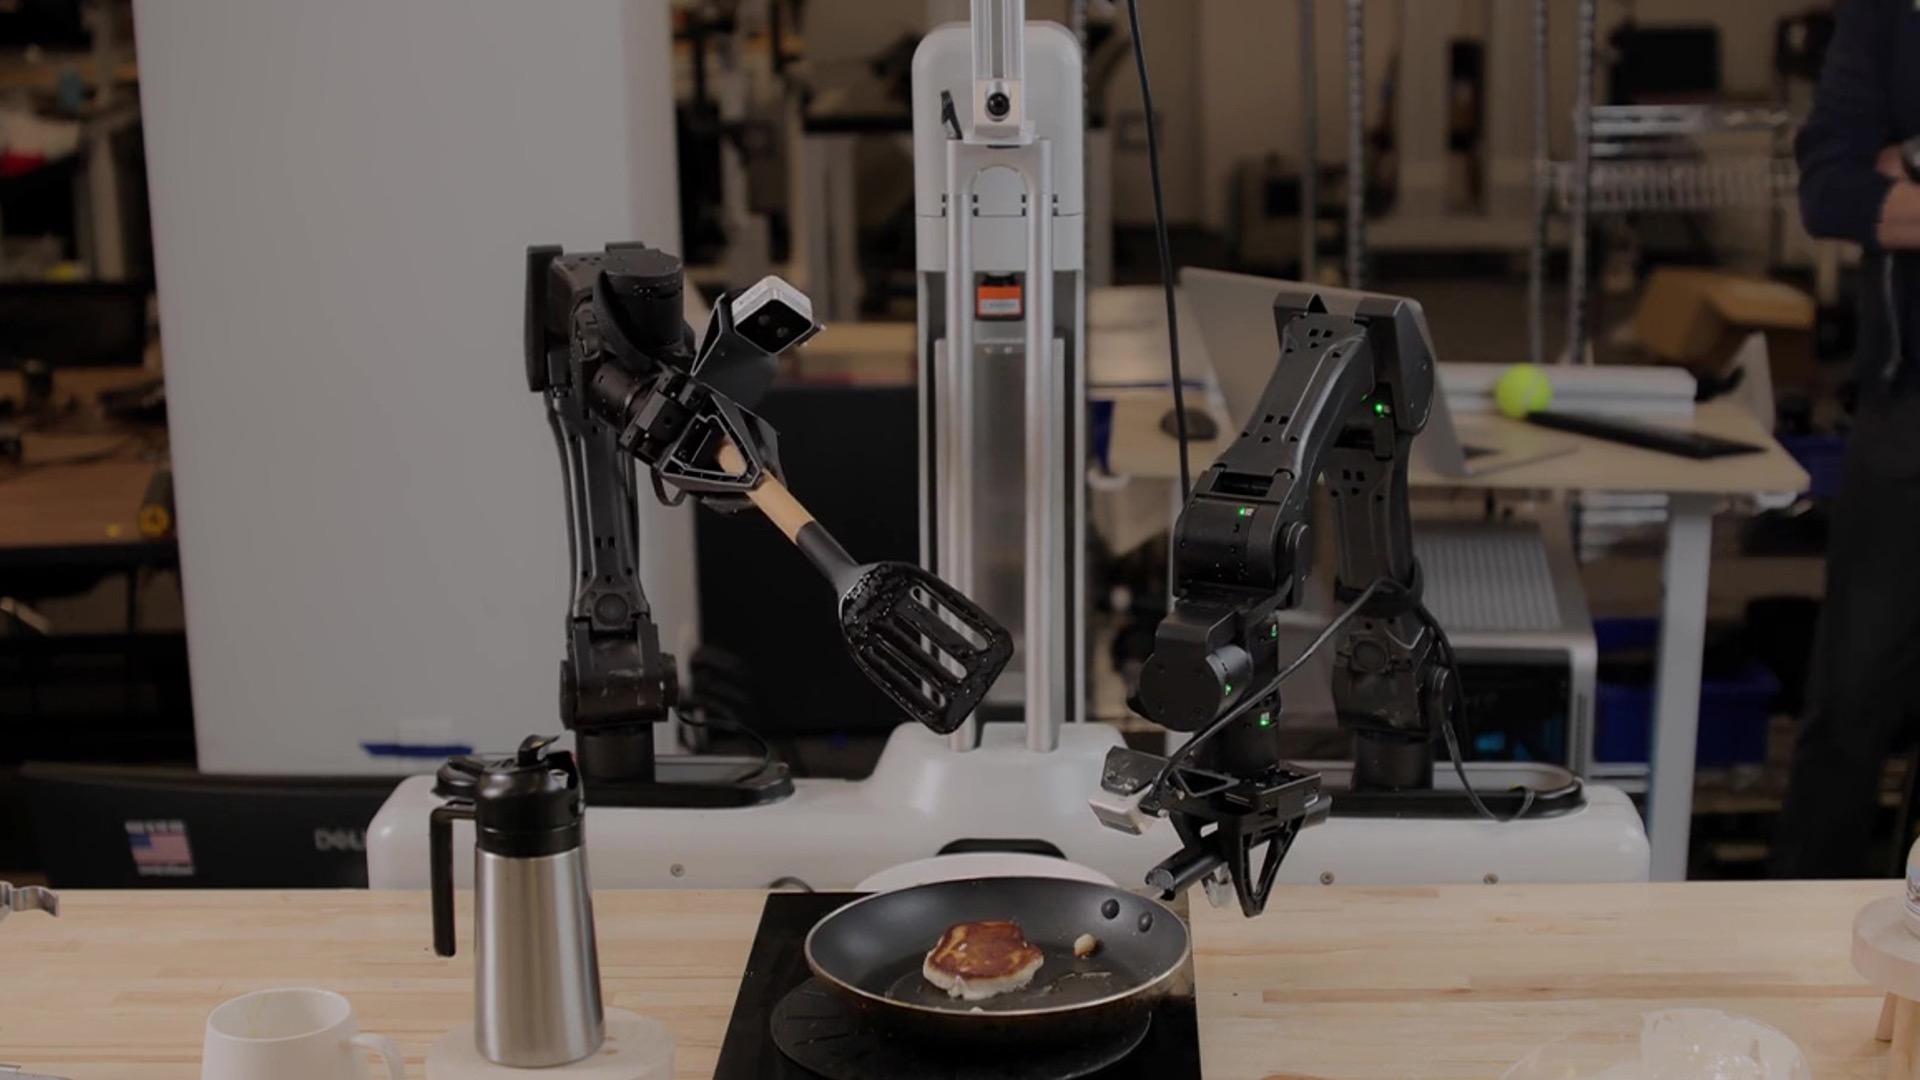
Skild AIが示したのは、事前学習に含まれていない4つの作業です。植木鉢への植え替え、パンケーキ作り、ハンドドリップのコーヒー、部品のキット組み立て。いずれも最長10分、数十工程に及びます[1][2]。
数字ははっきり出ています。未経験の作業では、S1の工程ごとの累積成功率が66パーセントだったのに対し、同じデータで訓練した言語プロンプト型の方式は9パーセントにとどまりました。7倍以上の開きです。しかも事前学習データを増やすほど両者の差が広がったとされ、この方式には伸びしろがあるという見方につながっています[2]。
事前学習で見た作業に限っても、S1の成功率は約96パーセントに達します。興味深いのは1,000時間規模の少ないデータでは言語プロンプト型が53パーセント、S1側が43パーセントと逆転していた点です。データが少ないうちは言葉に圧縮した指示のほうが有利で、規模が効いてくると映像の情報量が効いてくる、という構図が見えてきます[2]。
作業の途中で物をずらす、別の物に入れ替える、照明を変えるといった妨害を加えても、S1は作業を完了したとされています。手本では如雨露で水をやっていたのにコップしか無ければコップを使う、といった常識的な振る舞いも観測されました。手本を「なぞるべき軌跡」ではなく「達成すべきゴール」として扱っているわけです[2]。
動画1本が、テレオペ380回分の価値を持つ
導入の手間という観点で、いちばん実務に響くのはこの比較でしょう。従来方式で同じ水準に到達させるには、遠隔操作による手本収集がおよそ380回必要になると見積もられています。4分から10分かかる長い作業を380回集めるとなると、実作業時間で50時間から100時間です。それが動画1本で置き換わります[1][2]。
実際、植木鉢の植え替えでは、手本の撮影を終えてから11分後にロボットが自律実行を始めたとSkild AIは記録しています。土や鉢がオフィスに届いてから実行開始まで含めても、かかった時間の大半は家具を動かして現場を作る作業でした[1][2]。
もっとも、従来方式が永久に追いつけないわけではありません。手本を2,000回まで積み上げれば成功率は86パーセントに届き、S1の66パーセントを上回ります[2]。動画1本で66パーセントという値をどう読むかは、現場が許容できる失敗率と、手本を集めるコストの兼ね合い次第です。
訓練はNVIDIAの基盤、現場ではFoxconnと組む
S1の訓練と検証はNVIDIAのAIインフラ上で行われています。世界基盤モデル群のNVIDIA Cosmosで訓練データを多様化し、映像を構造化した記述へ変換。Cosmos Curatorで大量データの選別と整理を進めます。実機投入前の検証にはNVIDIA OmniverseのライブラリとIsaac Simを使い、物理法則に沿った仮想環境でデータ生成とエッジケースの試験を回しています[1]。
力の加わり方や接触、衝突、圧力といった物理パラメータの再現には、Newton物理エンジンで動くIsaac Labでの強化学習を充てています。両社はさらに、ロボットが物体に触れて掴んで動かす挙動を高速かつ正確に解くGPU向けシミュレーションソルバーを共同開発中で、Newtonの一部として開発者に提供される予定です[1]。
現場側の話も具体的です。Skild AI、NVIDIA、Foxconnの3社は、両腕型マニピュレーターにSkild Brainを載せ、NVIDIA Blackwellシステムの高精度な組み立てに投入しています。公開されたワークフローでは、ロボットがブスバーとリミットブロックを取り付け、16本のネジを締め、想定と違う状況にも対応しました[1]。
事業面では、最初の商用導入から10か月で年間売上高のランレートが1億ドル(約153億円)に達し、製造、物流、検査、警備、調理といった領域で60件を超える導入パートナーシップを結んでいるとされています[1]。
※1ドル153円換算(2026年9月12日時点)
まとめ
S1は、手本の動画1本を文脈として与えるだけで、訓練していない10分級の作業を実行するロボット基盤モデルです。未経験作業での成功率は66パーセントと、言語指示型の9パーセントを7倍以上引き離しました。動画1本がテレオペ380回分に相当するという見積もりは、ロボット導入のコスト構造そのものを組み替えかねない数字です。S1は現時点で重みやAPIが一般公開されているわけではなく、商用パートナーとの現場運用が先行している段階ですが、ロボットに仕事を教える手段が「プログラムを書く」から「やって見せる」へ移りつつあることは、はっきり見えてきました。