

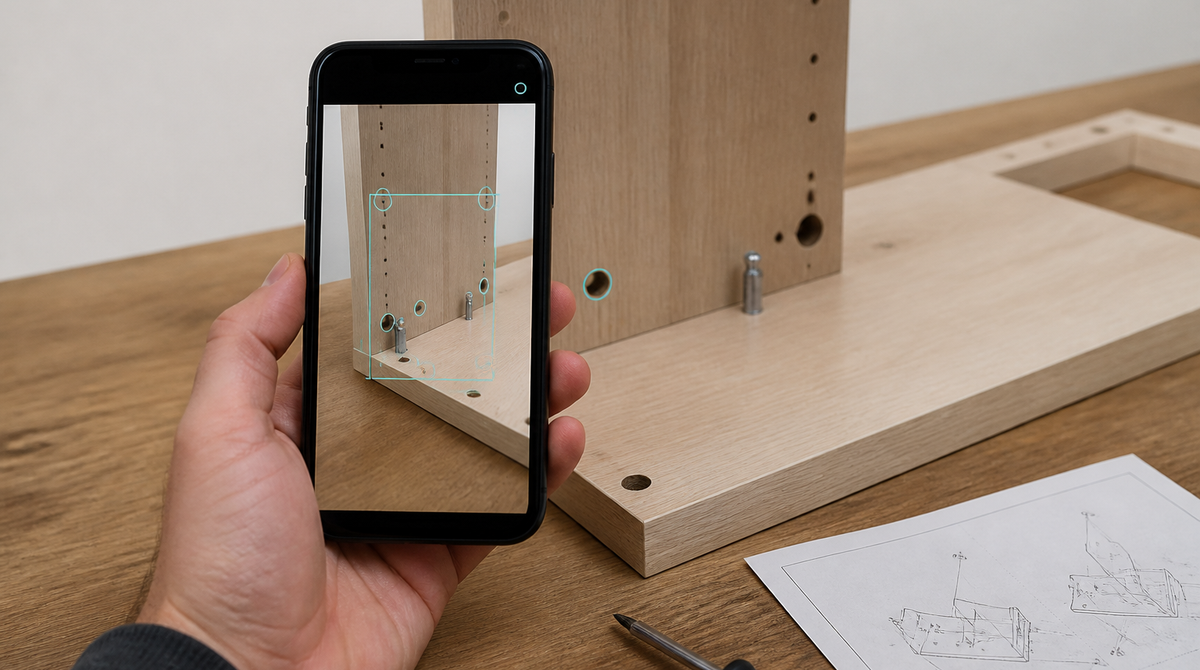
AI開発企業各社が競い合う画像認識モデルの実力を測る新しいテストとして、家具の組み立てミスを写真から見抜く専用ベンチマークが注目を集めています。このテストでOpenAIの最新モデル「GPT-6 Astra」が従来モデルを大きく上回るスコアを記録し、AIモデルの視覚的な空間認識能力がわずか1年足らずで急速に進歩していることが浮かび上がりました。
家具の組み立てミスを判定する新テストとは
このベンチマークは、家具の組み立て中に撮影した写真をAIモデルに読み取らせ、組み立て手順のどこに誤りがあるかを指摘させるというものです。対象となったのは複雑さの異なる3種類の家具で、いずれも複数の工程を含む組み立てキットが使われました。モデルには組み立て説明書の画像と、写真を拡大して確認できる機能、さらに計算のためのプログラム実行環境が与えられ、各工程の写真を手順書と照らし合わせながら誤りを一つひとつ特定し、間違いの内容を言葉で説明することが求められます。判定は「誤りの発見」「正しい工程の確認」「回答内容の検証」という3段階のプロセスを経て採点される仕組みです。
単純に見えるテストですが、部品の向きや位置関係、ネジの締め忘れといった細部を写真から正確に読み取る能力が必要になるため、AIモデルにとっては視覚と空間認識の両方が試される難易度の高い課題とされています。人間であれば説明書と見比べればすぐに気づけるような間違いでも、AIモデルにとっては画像の中から該当する部品や向きを正しく認識し、それを文章として言語化するという複数の工程を同時にこなす必要があり、単純な画像分類とは異なる能力が問われます。
GPT-6 Astraが80%を記録、わずか10か月で急上昇
このテストでGPT-6 Astraは80%という高い正答率を記録しました。1回あたりの判定にかかった時間は約3分で、他社の主要モデルに比べても処理速度が優れています。比較対象となったAnthropicのClaude Fable 5.1は70%、Claude Opus 5は61%を記録しており、複数の企業が同時に高い水準へ達していることがわかります。
注目すべきは進歩のスピードです。同じテストで最高スコアを記録したのは、10か月前の時点ではAnthropicのClaude Opus 4.5でしたが、当時の正答率は28%にとどまっていました。この期間でスコアが3倍近くに伸びたことになり、AIモデルの画像理解能力がここ1年で急速に向上していることを示す結果といえます。一方で、中国の主要企業が公開しているオープンウェイトモデルは、最先端のモデルに比べて約7か月出遅れているとの分析もあり、開発競争の中でも技術力の差が出やすい分野であることがうかがえます。
実用化への課題と広がる可能性
現時点でのGPT-6 Astraの回答速度は1枚の写真に約3分かかるため、組み立て作業をリアルタイムで補助するにはまだ速度が足りないとされています。とはいえ、この種の視覚的・空間的な推論能力は、自動車の修理や家電製品の故障箇所の特定といった、家具の組み立てと似た構造を持つ作業にも応用できる可能性があると指摘されています。実際、GPT-6 Astraはロボットの視覚タスクにも強いとされ、単なる画像認識にとどまらない汎用的な空間理解の能力が評価されています。
GPT-6 Astraは2026年9月にOpenAIが投入した最新の主力モデルで、音声対応や金融データの標準搭載など、これまでにも複数の分野で機能拡張が進められてきました。今回のベンチマーク結果は、そうした実用面での強化に加えて、写実的な画像を細部まで読み取る基礎的な視覚能力そのものも着実に向上していることを示すものといえます。
まとめ
家具の組み立てミスを写真から検出する専用ベンチマークで、OpenAIの最新モデル「GPT-6 Astra」が80%という高い正答率を記録しました。同じテストの最高スコアは10か月前の28%から大きく伸びており、AIモデルの視覚的な空間認識能力が急速に進化していることが示されています。実用化にはまだ速度面の課題が残るものの、自動車修理や家電の故障診断など、組み立て作業以外への応用も期待される分野です。



























