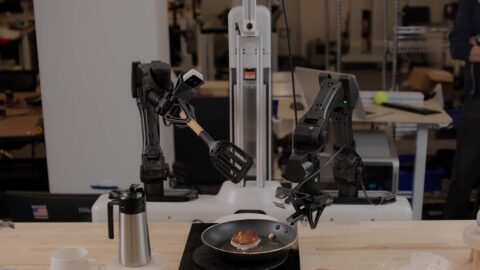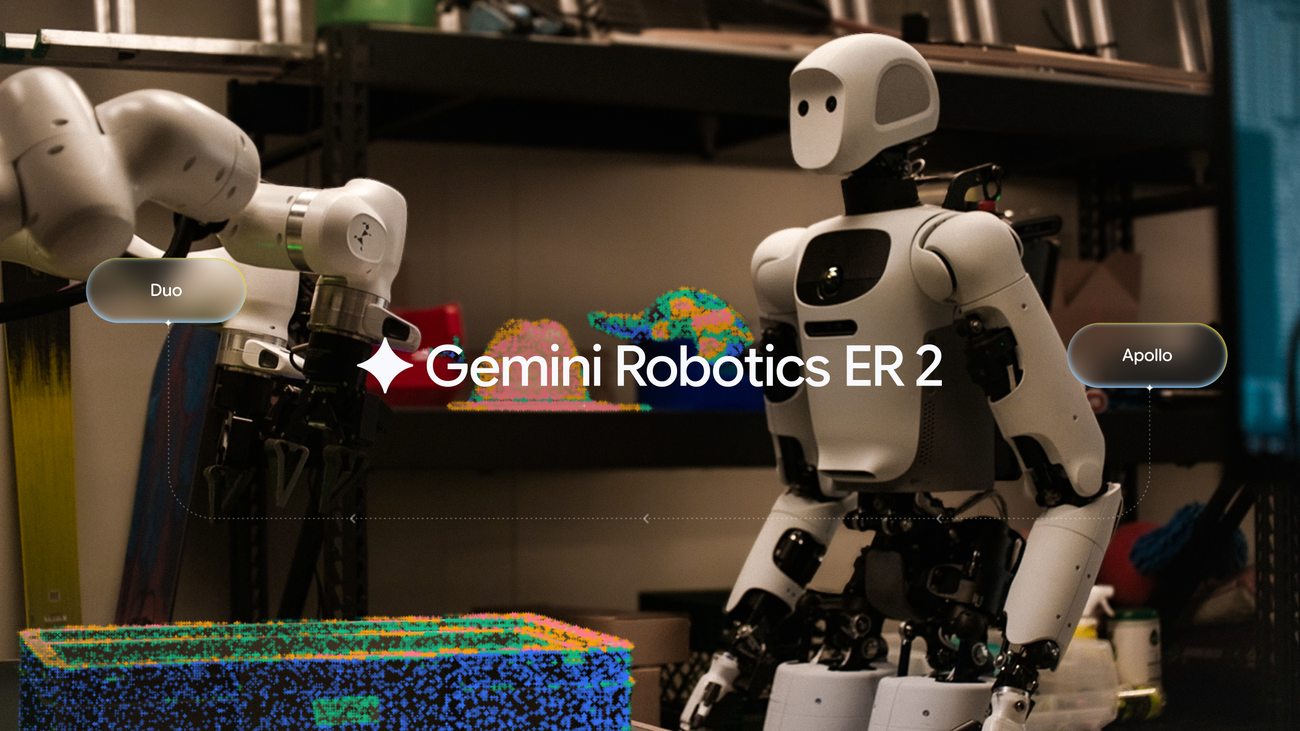
Google DeepMindは7月30日、ロボット向けの推論モデル「Gemini Robotics ER 2」を公開しました[1]。ロボットの高次の脳として複数手順の作業を組み立て、実際の動作は別のモデルへ渡す役割を担います。映像を見続けて自分の進み具合を測れるようになった点と、種類の違うロボット同士が手分けできるようになった点が今回の柱です。開発者はGemini APIとGoogle AI Studioから利用できます[1]。
考え込んで止まらないための作り
ロボットが人の生活する場所で役に立つには、空間を正確に捉えるだけでは足りません。物理世界の速さに合わせて、判断そのものを間に合わせる必要があります[1]。
Gemini Robotics ER 2は、この間に合わせる側に寄せた設計です。人と言葉でやり取りし、周囲の状況を理解し、複数手順の計画を立てるところまでを担当し、実際にモーターを動かす部分は下位のVLA(視覚言語行動)モデルへ引き渡します[1]。Google検索の呼び出しや、開発者が定義した任意の関数を、モデルが自分で呼ぶこともできます[1]。
遅延を詰めるために、ER 2はGemini Live APIの双方向ストリーミング接続を使います[1]。開発者はVLAモデルやナビゲーションAPIといった低レベルの制御インターフェースを道具として宣言し、映像や音声、テキストをそのままモデルへ流し込む形で組み立てます[1]。この結果、次の手順を考えるたびに動作が止まる、いわゆる考え込みの間が消えます[1]。道具の呼び分けの精度は、実機のVLA、シミュレーション上のVLA、人が遠隔操作する場合という3つの制御方式すべてで、前世代のER 1.6を上回ったとしています[1]。
実演としては、Boston DynamicsのSpotにER 2からナビゲーションやマニピュレーターのAPIを呼ばせ、話しかけると物を取ってくるデモが公開されています。コードはGitHubに置かれています[1]。
「終わったかどうか」を映像から測る
ロボットにとって難しいのは、作業が終わったかどうかを自分で判断することです[1]。ER 2はここに2つの物差しを持ち込みました。
1つは進捗の分類です。映像の各フレームを0〜20パーセント、20〜40パーセントというように5段階へ割り当て、いまどのくらい進んだかを数値にします[1]。途中で失敗しても、工程全体をやり直さずにその手順だけを繰り返せます[1]。この課題での正確性は57.4パーセントで、前世代や競合の最先端モデルを上回ったとしています[1]。
もう1つは瞬間の特定です。カップにコーヒーを注ぎ終える瞬間のように、重要な出来事が起きたフレームを言い当てる能力を指します[1]。ER 2の正確性は91.3パーセント、ずれの平均は0.96秒でした[1]。Google DeepMindは、はるかに大きなモデル群と競り合う水準を、計算コストの一部と4倍の実行速度で出していると説明しています[1]。電球を締める、ゴミ袋を縛るといった作業が仕様どおり仕上がったかを確かめてから次へ移れる、というのがこの2つの狙いです[1]。
種類の違うロボットが手分けする
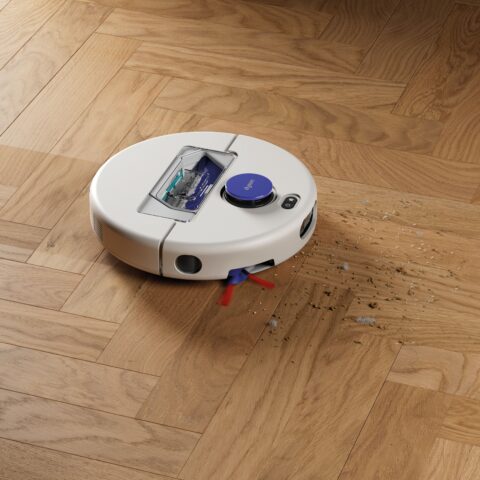
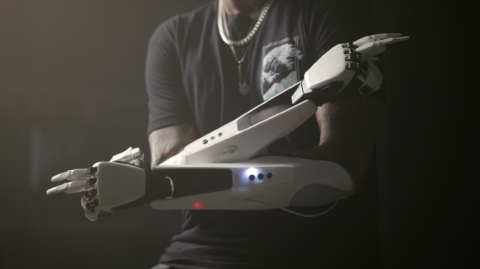
車輪型は屋内が得意で、人型は不整地に強いというように、あらゆる作業に向く単一のロボットは存在しません[1]。ER 2はここに複数ロボットの協調を持ち込み、異なる機械が共通の意味理解を介してやり取りし、受け渡しをしながら作業を完了できるようにしました[1]。具体例として、Apptronikの人型ロボットApollo 2とFrankaのF3 Duoを協調させる様子が示されています[1]。
空間理解そのものも更新されています。成功と失敗の検知は静止画ではなく生の映像に対して働くようになり、こぼれ、滑り、位置ずれといった実行中の失敗を捉えます[1]。計器の読み取りは円形の文字盤や覗き窓に加えて、デジタル表示、直線目盛り、定規、液体温度計まで広がり、10種類の計器で検証されています[1]。
人が近づいたら止まる
安全面では、物理的な制約への追従を測るSafety Instruction Followingと、人の接近を測るHuman Proximityという2つのベンチマークで、これまでで最も良い成績だとしています[1]。人が近くにいると人型ロボットを停止させ、その場が空いてから自律的に作業を再開する挙動が確認されたということです[1]。
あわせて、VLAの統括役として安全に振る舞えるかを測る新しいベンチマークも用意されました。安全上の制約を守らせること、周囲を監視すること、物理的に実行可能かを判断すること、迷ったときに人の判断を仰ぐことが評価項目です[1]。Google DeepMind側の発表では、この枠組みはASIMOV-Agenticという名前で公開されており、VLAからの危険な道具呼び出しを拒めるかどうかも測られます[2]。
3モデル構成のうちの1つ
ER 2は単体の発表ではなく、Gemini Robotics 2という3モデル構成の一角です[2]。残る2つは、人型ロボットを足先から指先まで制御するVLAモデルのGemini Robotics 2と、ロボット本体で動かす軽量版のGemini Robotics On-Device 2です[2]。On-Device 2は、形状もセンサーも自由度も異なる新しい両腕ロボットへ、数時間、多くの場合200例未満のデータで適応できるとしています[2]。
提供状況には差があります。ER 2はGemini APIとGoogle AI Studioで公開済みで、Gemini Enterprise Agent Platformでは限定プレビューの扱いです[1][2]。一方、VLAとOn-Device版は早期アクセスのパートナー向けにとどまります[2]。実際に手足を動かす部分ほど閉じている構図で、当面、外部の開発者が触れるのは計画と監督を担うER 2の側になります。
まとめ
Gemini Robotics ER 2は、ロボットの計画と監督を担う推論モデルです。映像から進捗を測り、重要な瞬間を平均0.96秒のずれで言い当て、種類の違うロボット同士の手分けまで扱えるようになりました。Gemini Live APIを介した低遅延の接続により、考えるたびに動作が止まる挙動も解消されています。開発者向けにはGemini APIとGoogle AI Studioで公開済みですが、実際に手足を動かすVLAモデルは早期アクセスの段階にとどまっています。
出典[1]:https://blog.google/innovation-and-ai/models-and-research/google-deepmind/gemini-robotics-er-2/
出典[2]:https://deepmind.google/blog/gemini-robotics-2-brings-whole-body-intelligence-to-robots/