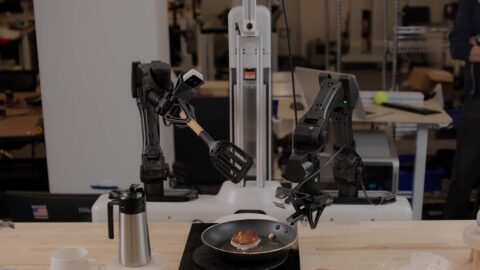
Google DeepMind 於 7 月 30 日發表了機器人用的推理模型「Gemini Robotics ER 2」[1]。它擔任機器人的高層大腦,負責安排多步驟的作業,實際的動作執行則交由另一個模型負責。這次的兩大重點,一是能持續觀看影片來掌握自己的完成進度,二是讓不同類型的機器人分工合作。開發者可透過 Gemini API 與 Google AI Studio 使用[1]。
為了不因思考而停頓
機器人要在人們生活的場所派上用場,光有準確的空間理解並不夠。判斷本身必須跟上實體世界的即時速度[1]。
Gemini Robotics ER 2 正是針對這個時間問題而設計。它負責與人對話、理解周遭環境、擬定多步驟計畫,而真正驅動馬達的部分則交給下層的 VLA(視覺語言動作)模型[1]。模型也能自行呼叫 Google 搜尋,或是開發者自行定義的任意函式[1]。
為了壓低延遲,ER 2 透過 Gemini Live API 的雙向串流端點連線[1]。開發者把 VLA 模型、導航 API 等低階控制介面宣告為工具,再將影像、音訊或文字直接串流進模型[1]。如此一來,機器人每次推算下一步時出現的停頓感就消失了[1]。Google DeepMind 表示,在實機 VLA、模擬 VLA、真人遠端操作這三種控制方式下,工具編排的準確度都勝過上一代的 ER 1.6[1]。
作為示範,官方公開了讓 ER 2 呼叫 Boston Dynamics Spot 的導航與機械手臂 API 的案例,使用者開口就能請機器人把東西拿過來。相關程式碼已放在 GitHub 上[1]。
從影片判斷「是否已經完成」
對機器人而言,最困難的一點是自行判斷作業是否結束[1]。ER 2 為此帶進了兩把尺。
第一把是進度分類。系統把影片的每一格畫面歸入 0 至 20%、20 至 40%等 5 個級距,把目前的進度化為數值[1]。中途失敗時,機器人只需重做那一個步驟,不必把整個流程從頭來過[1]。ER 2 在這項課題上的準確度為 57.4%,勝過上一代與競爭對手的前沿模型[1]。
第二把是關鍵時刻定位,也就是指出重要事件發生在哪一格畫面,例如咖啡倒滿杯子的那一瞬間[1]。ER 2 的準確度為 91.3%,平均誤差為 0.96 秒[1]。Google DeepMind 說明,這個水準足以與規模大上許多的模型類別競爭,而運算成本只是其中一小部分,執行速度還快上 4 倍[1]。兩把尺合在一起,機器人就能確認鎖燈泡、綁垃圾袋這類工作是否依規格完成,再進入下一個步驟[1]。
不同種類的機器人分工合作
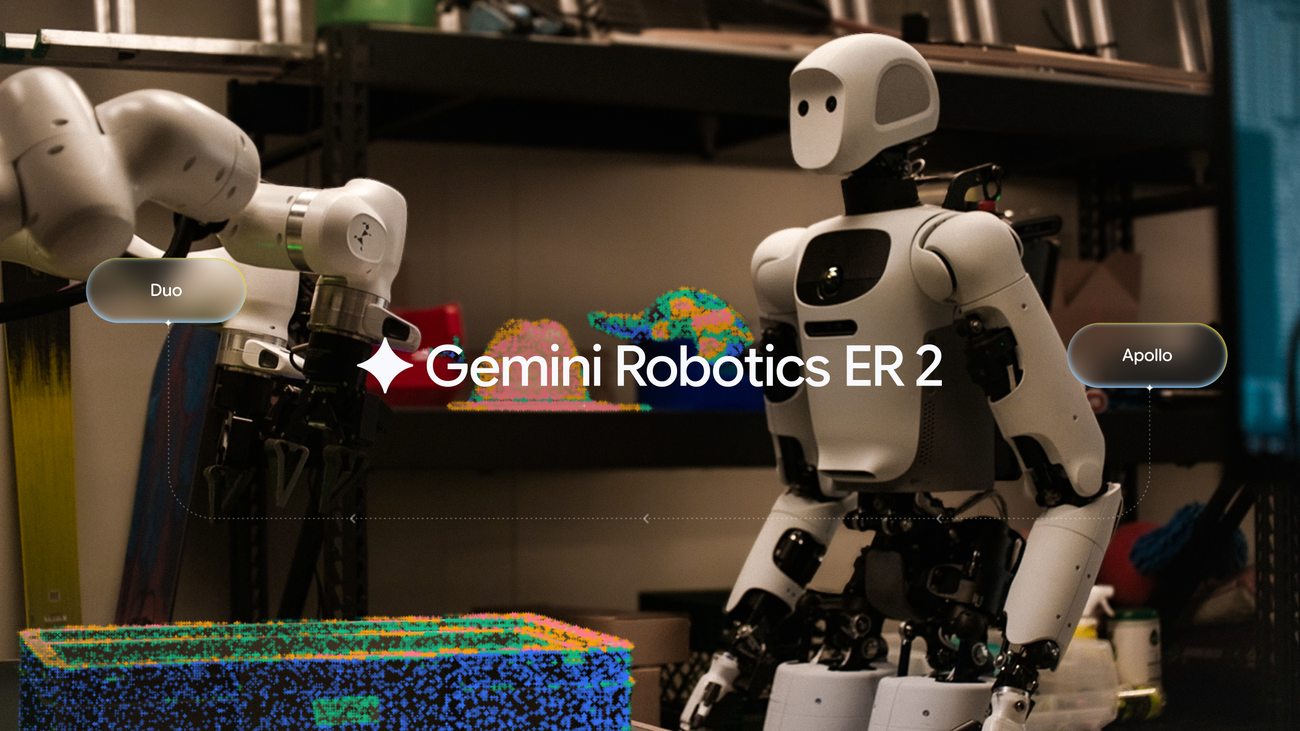
輪型機器人擅長室內,人型機器人則對崎嶇地面較有辦法,沒有哪一台機器人適合所有作業[1]。ER 2 因此帶進多機協作,讓不同的機器透過共通的語意理解互相溝通與交接,一起把工作做完[1]。官方展示了 Apptronik 的人型機器人 Apollo 2 與 Franka 的 F3 Duo 協同作業的例子[1]。
空間理解本身也有更新。成功與失敗的偵測不再以靜態截圖為基礎,而是直接作用於原始影像,可以捕捉潑灑、打滑、位置偏移等執行過程中的失誤[1]。儀器判讀從圓形錶盤與觀視鏡擴大到數位顯示器、直線刻度、直尺與液體溫度計,總共在 10 種儀器上完成驗證[1]。
有人靠近就停下
安全方面,Google DeepMind 表示,在衡量是否遵守實體限制的 Safety Instruction Following,以及衡量對人員接近的感知能力的 Human Proximity 這兩項基準上,該模型取得了至今最好的成績[1]。當有人靠近時,模型會讓人型機器人停下,等周圍淨空後才自主恢復作業[1]。
官方另外準備了一項新基準,用來衡量基礎模型能否安全地擔任 VLA 的統籌者,評估項目包括是否落實安全限制、是否監看環境、能否判斷任務在物理上是否可行,以及在不確定時是否主動請求人類介入[1]。在 Google DeepMind 的公告中,這套框架以 ASIMOV-Agentic 的名義公開,其中也會測試代理程式能否拒絕來自 VLA 的危險工具呼叫[2]。
三款模型中的一款
ER 2 並非單獨發表,而是 Gemini Robotics 2 這個三模型陣容中的一環[2]。另外兩款分別是能從腳尖控制到指尖的人型機器人用 VLA 模型 Gemini Robotics 2,以及可在機器人本體上執行的輕量版 Gemini Robotics On-Device 2[2]。On-Device 2 能在數小時內適應形狀、感測器與自由度都不同的新型雙臂機器人,多數情況下所需資料不到 200 個範例[2]。
三者的開放程度並不一致。ER 2 已在 Gemini API 與 Google AI Studio 上線,在 Gemini Enterprise Agent Platform 上則為私人預覽[1][2];而 VLA 與 On-Device 版本仍僅開放給早期存取的合作夥伴[2]。越是直接驅動肢體的部分,開放得越保守,因此外部開發者目前能接觸到的,主要是負責規劃與監督的 ER 2。
總結
Gemini Robotics ER 2 是負責機器人規劃與監督的推理模型。它能從影片判斷進度,以平均 0.96 秒的誤差指出關鍵瞬間,並支援不同類型機器人之間的分工。透過 Gemini Live API 的低延遲連線,過去每次思考都會中斷動作的問題也獲得解決。面向開發者的部分已經由 Gemini API 與 Google AI Studio 開放,而真正驅動肢體的 VLA 模型則仍停留在早期存取階段。
來源[1]:https://blog.google/innovation-and-ai/models-and-research/google-deepmind/gemini-robotics-er-2/
來源[2]:https://deepmind.google/blog/gemini-robotics-2-brings-whole-body-intelligence-to-robots/