

NVIDIAとMicrosoftは、開発者向けイベント「Microsoft Build」でエージェントAIの実行に必要な要素を一気通貫でそろえる協業の拡大を発表しました[1]。NVIDIAの創業者兼CEOであるJensen Huang氏が台北からSatya Nadella氏の基調講演に参加し、Windows端末からAzureクラウド、手元のローカル環境までを貫く統合スタックを示しました[1]。NVIDIAの開放モデルをMicrosoft Foundryで提供することや、開発支援ツールGitHub Copilotへ安全な実行環境を組み込むことが今回の柱です[1]。
Microsoft Buildで示された協業の全体像
NVIDIAは、エージェントAIは優れたモデルだけでは実現できず、高速なハードウェア、安全な実行環境(ランタイム)、応答性の高いデータ層、そして長時間の推論(学習済みのAIが答えを導く処理)に向けて調整したモデルがそろって初めて成り立つ、という見方を示しています[1]。今回の協業拡大は、この4要素をWindows端末・Azureクラウド・ローカルのいずれでも開発者が使えるようにする狙いです[1]。
基調講演で示された具体的なテーマは、Windows向けの「RTX Spark」と「DGX Station for Windows」、GPUで高速化したMicrosoft Fabric、Microsoft FoundryでのNVIDIA開放モデルの提供、GitHub Copilotへの「NVIDIA OpenShell」の統合、そして次世代のAIファクトリーです[1]。なかでも、企業や開発者がすぐ手を動かせるクラウド側の整備が大きく前進しました[1]。
NVIDIAの開放モデルがMicrosoft Foundryで利用可能に
Microsoft FoundryのエージェントサービスではNVIDIA、Anthropic、OpenAIのモデルに加え、特定タスク向けの「Hermes special agents」が利用できるようになり、企業はAzure上で本人確認やガバナンス(管理統制)を組み込んだエージェントを構築できます[1]。AnthropicのClaudeは、Azure上のNVIDIA GB300 Blackwell Ultraシステムでネイティブに動作するようになり、数週間のうちに顧客が利用できる見込みです[1]。
NVIDIAは、コーディングや調査、業務処理など長時間動くエージェント向けの新しいオープンな推論モデル「Nemotron 3 Ultra」を、今月Foundryのマネージドコンピュート上で提供します[1]。あわせて音声認識向けの「Nemotron 3.5 ASR」と、安全性を判定する「Nemotron 3.5 Content Safety」も用意されます[1]。開発者はNemotronをフロンティアモデルやローカルモデルと組み合わせ、処理ごとにコストと品質を最適化できるとしています[1]。
開放モデルの対象は物理AIや科学分野にも広がります[1]。物理AI向けの全面オープンなモデル「Cosmos 3」や、企業の予測・リスク分析に使えるAI気象モデル「Earth-2」がFoundryなどを通じて提供されます[1]。さらに、本番運用のエージェントを組み立てるためのオープンソース基盤「NVIDIA Agent Toolkit」と「NemoClaw」のブループリント(設計図)が用意され、cuDFやcuOpt、AI-Q、NeMoといったCUDA-Xライブラリをエージェントが専門スキルとして呼び出せるようになります[1]。
GitHub Copilotに安全な実行環境「OpenShell」
エージェントがコーディング支援から自律的な実行へと進むにつれ、本物の権限を渡さずに実際の作業をこなせる仕組みが求められます[1]。NVIDIAは、この課題に応える実行環境「NVIDIA OpenShell」をGitHub Copilotへ統合しました[1]。
OpenShellでは、各エージェントが隔離されたコンテナ(独立した実行領域)の中で動き、外部への通信はファイルやネットワーク、認証情報に届く前にポリシーで一つひとつ検査されます[1]。ポリシーはコードとして記述し、リポジトリでバージョン管理でき、稼働中でも更新できます[1]。OpenShellはApache 2.0のオープンソースで、特定モデルに依存せず、オンプレミス・ハイブリッド・クラウドのいずれの環境にも対応します[1]。
Microsoft FabricのデータウェアハウスをGPUで高速化
エージェントAIはデータを燃料にして動くため、データへの高速なアクセスが欠かせません[1]。NVIDIAのアクセラレーテッドコンピューティングがMicrosoft Fabricのデータウェアハウスに組み込まれ、Microsoft社内のベンチマークでは、高い同時実行性が求められる処理でSQLの実行がCPUベースの基準比で最大6倍、ほかの主要なクラウドデータウェアハウス3社と比べて最大7倍速くなったとしています[1]。
これにより、データを継続的に問い合わせて推論し続けるエージェントに、企業のデータ層が追従できるようになります[1]。NVIDIAは、研究から本番運用までを見据えた両社の長年の協業の成果だと説明しています[1]。
クラウドからローカル、Windows端末まで
協業はクラウドの外にも広がります[1]。Microsoftは、自社のローカル基盤「Azure Local」上の「Foundry Local」を、NVIDIA RTX PRO 6000 Blackwell Server Editionに対応させます[1]。Nemotronのオープンモデル群と組み合わせることで、オンプレミスやハイブリッド、各国の規制に対応するソブリン(自国内完結)な環境など、データのある場所で高性能なAI処理を動かせるとしています[1]。Azure Local上のFoundry Localは、複数ノードでの展開と推論基盤「vLLM」にも新たに対応しました[1]。
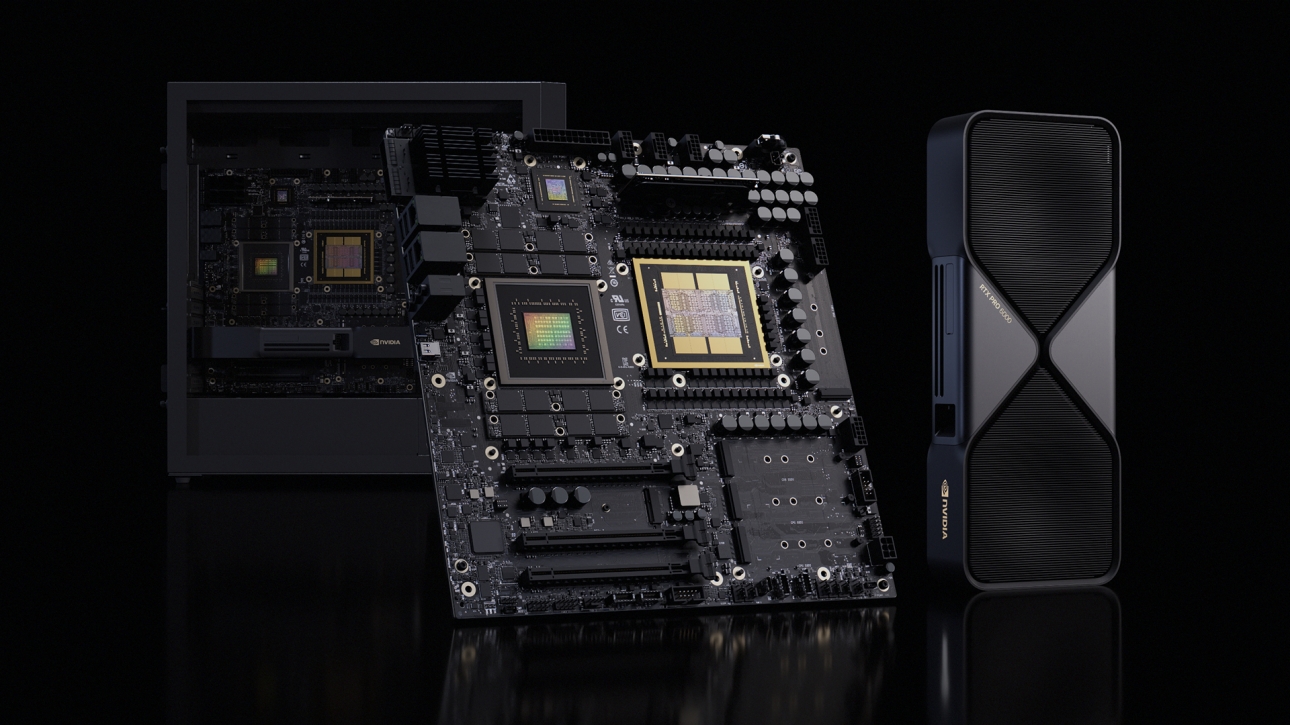
Windows端末側でも、個人向けエージェント特化PC「RTX Spark」と、デスクサイドのAIスーパーコンピューター「DGX Station for Windows」がいずれも前述のOpenShellを実行し、手元でエージェントを安全に動かせます[1]。物理AIの分野では、Microsoftがロボットや自動運転車などの開発に向け、NVIDIAのオープンソースの物理AIツールをAzureと「Physical AI Toolchain」に統合します[1]。
大規模な土台も動き始めています[1]。MicrosoftのAIファクトリー「Fairwater Wisconsin」が予定を前倒しして稼働し、次世代プラットフォーム「NVIDIA Vera Rubin」も本番投入されました[1]。NVIDIAによると、Vera RubinはBlackwellの隣に追加導入でき、1メガワットあたりの推論処理量を最大10倍に高め、エージェントが処理する1トークンあたりのコストを大幅に下げるとしています[1]。
まとめ
今回の発表は、エージェントAIを「動かす場所」を選ばないようにする協業だと言えます。Microsoft Foundryでの開放モデル提供とGitHub CopilotへのOpenShell統合により、開発者はクラウドでも手元でも、安全に管理されたエージェントを構築・運用しやすくなります。Fabricの高速化やAzure Localへの展開も加わり、NVIDIAとMicrosoftはモデル・実行環境・データ・インフラの各層をWindowsからクラウドまで一続きでそろえる方向を鮮明にしました。
出典:https://blogs.nvidia.com/blog/microsoft-build-windows-local-cloud-devices/



























