

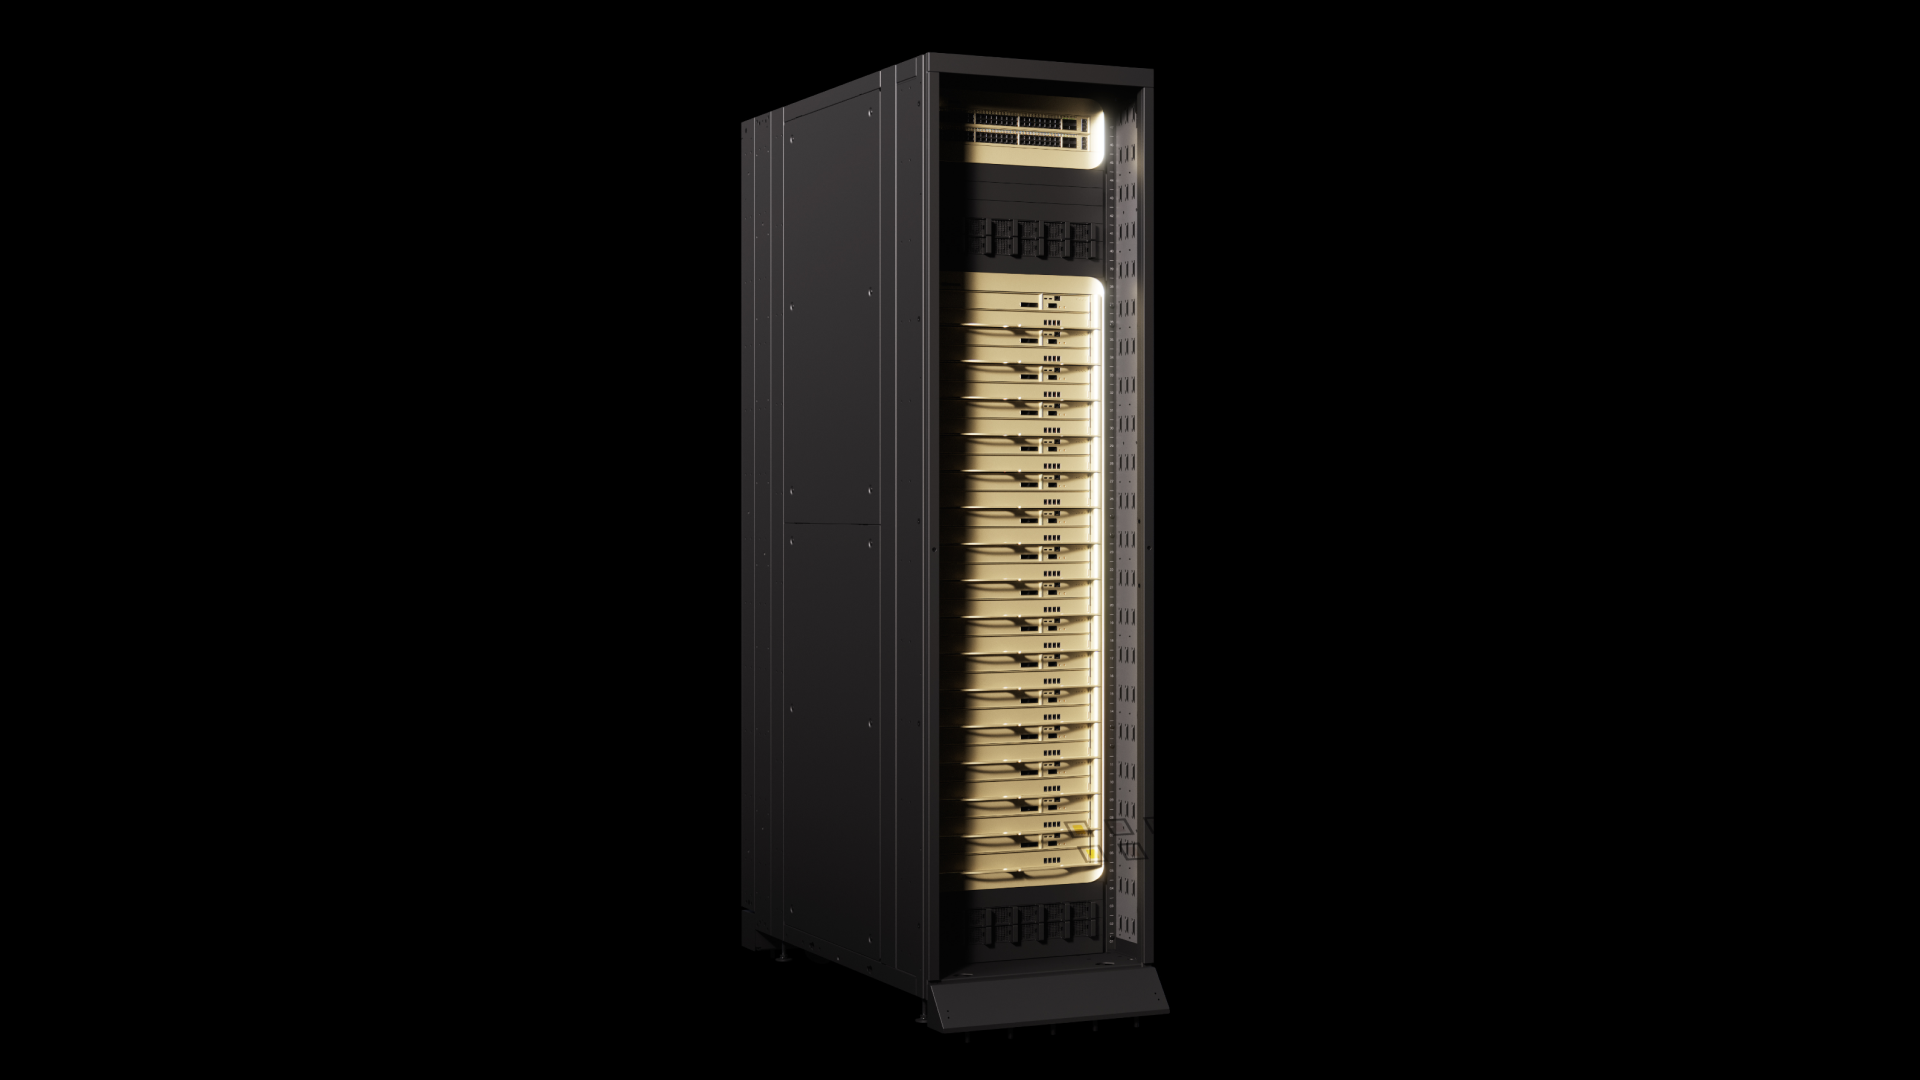
NVIDIAが、対話型の推論に振り切ったアクセラレーター「NVIDIA Groq 3 LPX」の量産開始を発表しました。Vera Rubinプラットフォームを拡張する位置付けの製品で、狙いはひとつ、トークンを吐き出す速度を上げることです。半導体学会Hot Chipsに合わせた発表で、最初の採用先としてAIクラウドのNebiusが名前を挙げています。
エージェントの体感速度は「生成の速さ」で決まる
AIエージェントは、ひとつの依頼をこなす間に数百から数千の推論ステップを踏みます。ファイルを読み、コードを書き、テストし、外部ツールを呼び、結果を確かめてまたやり直す。その一つひとつがトークンの生成で成り立っているため、生成が遅いとステップ数の多さがそのまま待ち時間になって返ってきます。
NVIDIAがGroq 3 LPXで手を付けたのは、この「1人のユーザーに対して毎秒何トークン返せるか」という指標です。同社はこれをインタラクティビティと呼び、エージェントが1ステップを終えるまでの所要時間を決めるものだと説明しています。生成が速くなるほど、エージェントは同じ待ち時間のなかでより多くの検証や修正を回せる、という理屈です。
エージェント型のワークロードには、性質の違う負荷が2つ同居しています。長大な文脈をまとめて読み込む処理と、そこから低遅延でトークンを吐き出す処理です。Groq 3 LPXは後者に専念する役割で置かれており、Vera Rubin NVL72の推論性能を生成側から押し上げる構成になっています。
Gemma 4 31Bで毎秒3,400トークン
数字として示されたのは、Artificial Analysisによるベンチマーク結果です。オープンソースのエージェント向けモデルであるGemma 4 31Bを、10万トークンという長い文脈条件で走らせ、出力側で毎秒3,400トークンを記録しました。NVIDIAは、このモデルでこれまでに計測されたなかで最速だとしています。
体感の話に落とすと、コーディングのようなエージェント作業が数時間ではなく数分で終わる水準になり、遅延に敏感なワークロードでは競合となるプラットフォームに対して4倍の応答性が得られる、というのが同社の主張です。
もっとも、比較対象の「代替プラットフォーム」が具体的にどの製品なのかは明かされていません。ベンチマーク自体は第三者であるArtificial Analysisのものですが、4倍という比較の中身については、公表された範囲だけでは追試が難しい状態です。
最初に載せるのはNebius
商用展開の口火を切るのはNebiusです。同社は推論基盤のNebius Token FactoryにGroq 3 LPXを投入する計画で、CTOのDanila Shtan氏は、生成フェーズこそがAIシステムの応答性を決める部分であり、開発者がすでに使っているAPIのまま、新しいスタックへの移行なしに速度を得られる点を強調しています。
続く採用先として、推論特化のAIクラウドであるGroqも早期導入組に名を連ねる予定です。なお製品名にあるGroqとLPUの呼称は、NVIDIAがGroq, Inc.からライセンスを受けて使っているものです。
7種類のチップと5種類のラックを束ねる
Groq 3 LPXは単体で完結する製品ではなく、Vera Rubin世代のラック群の一部として設計されています。NVIDIAは7種類のチップと5種類の専用ラックにまたがる作り込みを行ったとしており、Vera Rubin NVL72とGroq 3 LPXで役割を分ける形になります。前者が学習と推論の汎用的な土台を担い、後者が生成の速さを受け持つ、という分担です。
ラックにはBlueField-4 DPUが載り、Vera CPUラック、Vera BlueField-4 STXストレージ、Spectrum-6 SPXイーサネットと組み合わせて動きます。マルチエージェント構成でワットあたりのスループットを最大化し、推論の遅延を最小化する、というのが全体の設計思想です。
創業者兼CEOのJensen Huang氏は、推論こそがAIの成長エンジンであり、Vera RubinはエージェントAIの時代に向けてワークロード別に最適化した構成を用意するものだと述べています。ここ数年、学習用の巨大クラスターに集まっていた注目が、実際にモデルを動かし続ける側へ移ってきていることを示す言い回しです。
まとめ
Groq 3 LPXは、演算能力の総量ではなく「1人あたりの生成速度」を正面から取りに行った製品です。Gemma 4 31Bで毎秒3,400トークンという数字は、エージェントの実用性がレイテンシーに強く縛られている現状に対する、わかりやすい回答になっています。まずはNebius、続いてGroqでの提供が予定されており、実際の運用でどこまで数字が再現されるかは、これから明らかになりそうです。



























