

NVIDIA は、コンピュータービジョンの国際会議「CVPR 2026」で、フィジカルAI(現実世界で動く機械のためのAI)に関する 3 本の研究論文を公開しました[1]。初めて触れる道具でも物をつかめるロボットの「掴む」基盤モデル、車載ハードでも素早く判断する自動運転モデル、そして 1,000 本を超えるゲームで鍛えたエージェントAIが柱です[1]。いずれも「大規模に学習させれば、見たことのない状況にも応用できる」という共通の発想で貫かれています[1]。
共通するのは「大規模学習による汎用化」
CVPR(Computer Vision and Pattern Recognition)は、コンピュータービジョン分野で最大級の国際会議で、今年は 6 月 3 日から 7 日まで米国デンバーで開催されます[1]。NVIDIA Research が発表した 3 本の論文は、ロボットの把持、自動運転、仮想エージェントの学習という別々の課題を扱いながら、「できるだけ多様な状況を大規模に学習させることで、見たことのない場面にも対応できるシステムを作る」という同じ考え方を共有しています[1]。
あらゆるグリッパーで使える初の「掴む」基盤モデル「GraspGen-X」
ロボットの把持AIの多くは「専用品」です[1]。2 本指のグリッパー(ロボットの手にあたる把持機構)向けに学習したAIはその 2 本指でしか掴めず、新しい手の形になるたびに、データ収集や微調整、検証をやり直す必要がありました[1]。このため多くのロボット企業は、一度決めた手の形に絞って開発を続けるのが一般的でした[1]。
GraspGen-X は、この制約をなくすことを狙った初の「掴む」ための基盤モデル(さまざまな用途に応用できる大規模モデル)です[1]。大規模言語モデルが追加学習なしに新しい作業へ言語理解を応用できるように、GraspGen-X は幾何形状と接触の理解を、出会ったことのないグリッパーにも当てはめます[1]。新しいグリッパーの形状と、見たことのない物体を与えると、確実につかむための持ち方の候補を生成します[1]。
その学習には、現実では集めきれない規模のデータが必要でした[1]。研究チームは、数千種類の物体形状と合成したグリッパー構成にまたがる 20 億回分の把持シミュレーションを生成し、実機が遭遇しうる多様な形状をカバーしました[1]。開発者にとっては、手の形ごとに学習し直す手間がなくなり、よく使われる複数のグリッパーではそのまま利用できます[1]。GraspGen-X は、新たに公開された CUDA 高速化対応の動作計画ライブラリ「curoboV2」と組み合わせ、未知の環境でも目的の持ち方を実現できるとしています[1]。さらに関連論文として、ICRA 2026 で発表された「Grasp-MPC」が、持ち方の生成から実際につかみ続ける閉ループ制御へと次の段階を進めています[1]。
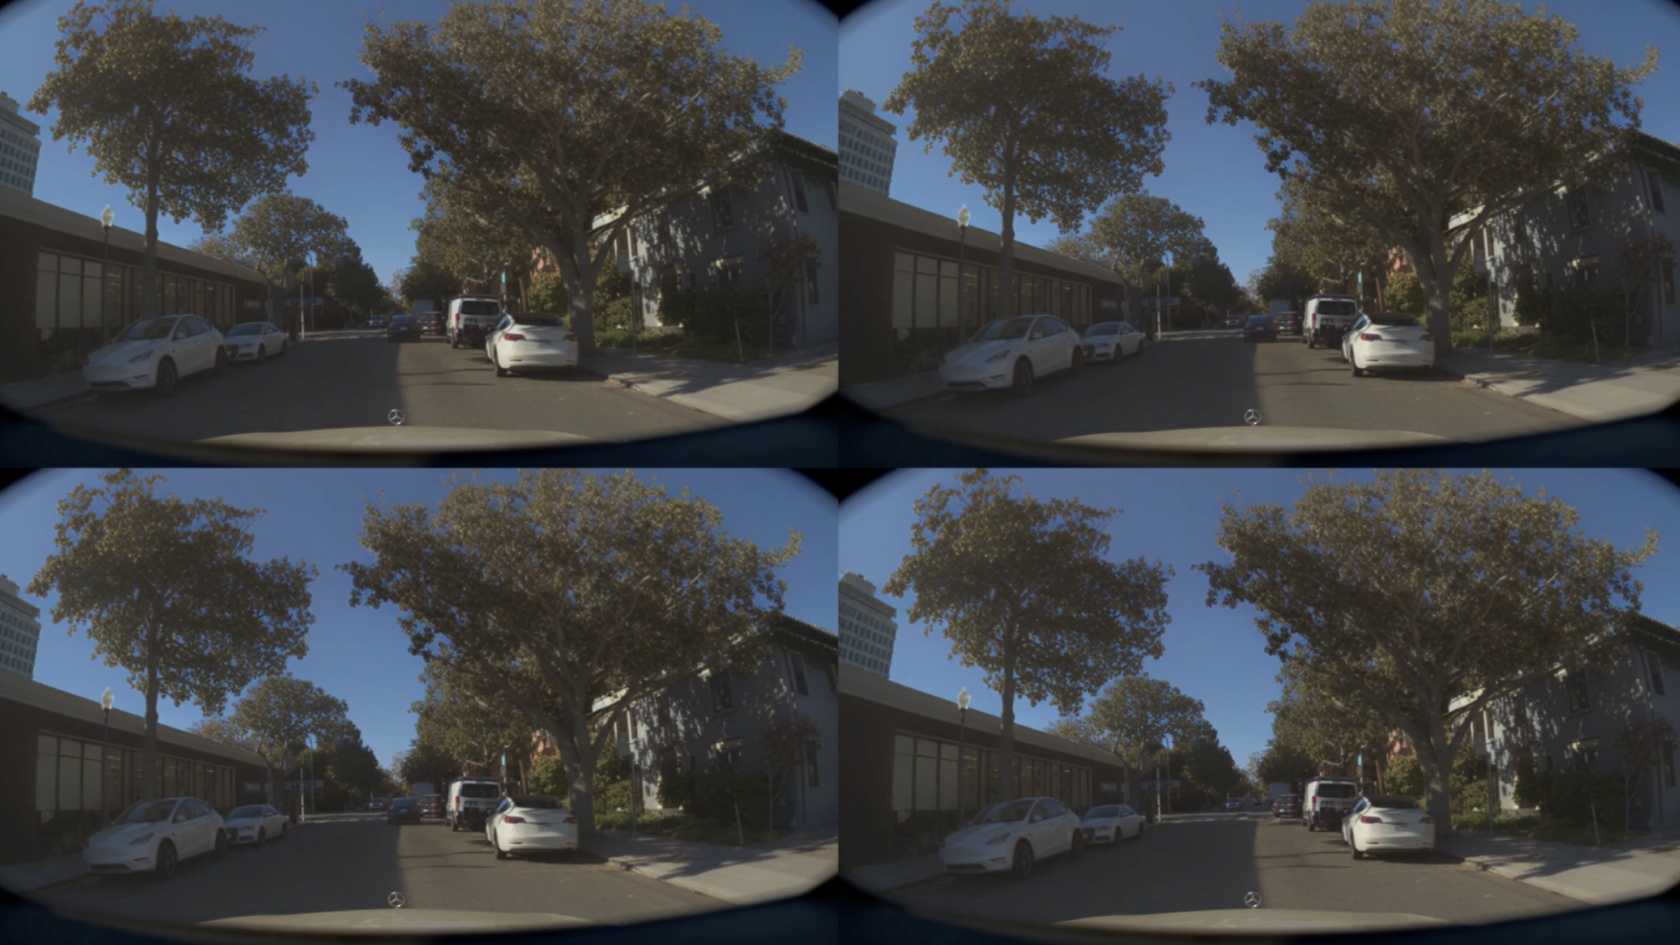
車載ハードで速く考える自動運転モデル「LCDrive」
近年の研究では、AIに答えを出す前の思考過程をたどらせる「推論(学習済みのAIが答えを導く処理)」が、判断の質を確実に高めることが分かってきました[1]。ただ自動運転車の場合、その思考を実際に車内のハードウェアで動かすのが難題です[1]。文章で思考を組み立てる方式では、単語の一つひとつがトークン(AIが処理する文章の最小単位)となり、生成に時間がかかります[1]。車内のプロセッサーでは、このトークン数が応答速度を左右する現実的な制約になります[1]。
LCDrive は、その単語を圧縮した潜在表現(内部的に圧縮した表現)に置き換えることでこの問題に対処します[1]。人が読める思考ステップを書き出す代わりに、空間情報を捉えた圧縮空間の中で考えます[1]。仕組みとしては、行動の候補を提案し、その行動を取ると世界がどう変わるかを予測する、という 2 種類の思考を交互に繰り返し、予測した状態をもとに次の一手を磨き込みます[1]。同じ推論ループを、自然言語よりも計算効率の高い形で回す発想です[1]。その結果、文章で思考する方式と同等の走行軌道の品質を、およそ半分のトークン数で実現したとしています[1]。このモデルは NVIDIA Alpamayo を土台に、既存の車両データから得た教師情報で学習されました[1]。
1,000本超のゲームで鍛える身体性AIエージェント「NitroGen」
NVIDIA のヒューマノイドロボット向けオープン基盤モデル「Isaac GR00T」は、十分に多様な状況に触れさせれば、見たことのない状況にも応用できるようになる、という単純な原則に基づいています[1]。NitroGen は、その原則を仮想環境へ広げ、GR00T のアーキテクチャを使って、幅広い仮想世界で動く身体性AIエージェント(現実世界での行動を学ぶAI)のための基盤モデルを学習させたものです[1]。
ビデオゲームは、明確な目標と達成条件を備えた、構造化された多様な世界を大規模に提供してくれます[1]。NitroGen はゲームを、いずれ現実や別のシミュレーション環境の新しい状況に対応するエージェントを育てる「訓練の場」として扱います[1]。たとえば「これらの物を食品庫に片づけて」といった大まかな指示で家事を手伝うロボットの基礎づくりにつながる発想です[1]。GR00T をベースにしたモデルを 1,000 本を超えるゲームと 4 万時間の操作で学習させた結果、生まれたエージェントは環境をまたいで汎用的に振る舞えるようになりました[1]。アクションRPGやプラットフォーマー、ローグライク、オープンワールドなど幅広いゲームで評価され、戦闘・移動・探索といった行動を示したとしています[1]。
同じ手法は、ゲーム内のより適応的なNPC(非プレイヤーキャラクター)やAIの相棒、ゲームシステムの実現、さらには複雑なゲーム環境の幅広いテストにも役立つ可能性があります[1]。新しい環境の例をわずかしか見ていない「少データ」の条件では、NitroGen から始めることでエージェントは大きく有利になり、従来の最先端手法に比べて性能が最大 52 パーセント向上したとしています[1]。このモデルはオープンソースとして、GitHub と Hugging Face で公開されています[1]。
研究を加速する物理AIの新スキル
NVIDIA は CVPR で、これら 3 本の論文に加えて、自動運転車やロボット、ビジョンAIシステムの開発を加速する新しいフィジカルAI向けのエージェントスキルも公開しました[1]。研究者や開発者が、モデルの能力を現実世界へ展開できる一連のワークフローへとつなげやすくする狙いです[1]。
まとめ
今回の 3 本の論文は、把持・自動運転・仮想エージェントという異なる課題を、「大規模な学習で汎用性を獲得する」という共通の発想で束ねた点が特徴です。あらゆるグリッパーに対応する GraspGen-X、車載ハードで速く判断する LCDrive、1,000 本超のゲームで鍛えた NitroGen はいずれも、特定の用途に縛られない応用力を重視しています。なかでも NitroGen はオープンソースとして GitHub などで公開されており、ロボティクスやゲームAIの開発者が自分たちの環境で試せる点も、研究の裾野を広げそうです。
出典:https://blogs.nvidia.com/blog/cvpr-research-grasping-driving-agent-training/



























