NVIDIAが公式ブログで、エージェントAI時代の新しい物差しとして「1ドルあたりの知能(intelligence per dollar)」という指標を打ち出しました[1]。モデルを一度学習して終わりにするのではなく、運用しながら賢さを磨き続ける「ポストトレーニング」が主役の時代に入ったとし、その継続的な負荷を効率よくさばく基盤として新プラットフォーム「Vera Rubin」を位置づけています。最大級のモデルを従来比4分の1のGPUで学習できると主張しており、AI基盤のコスト構造そのものを問い直す内容です。
ポストトレーニングは「一度きり」から「回し続ける」工程へ
NVIDIAはプロのアスリートを例えに挙げます。試合と試合の間に弱点を修正し、相手に合わせて技を磨き続けることが一流の条件であり、エージェントAIも同じだという見立てです[1]。生成AIがプロンプトに答えるだけなのに対し、エージェントは目標を与えられ、環境の変化やツールの入れ替わり、想定外の事例に対応しながら自分で計画を立て、途中の失敗から立て直す必要があります。
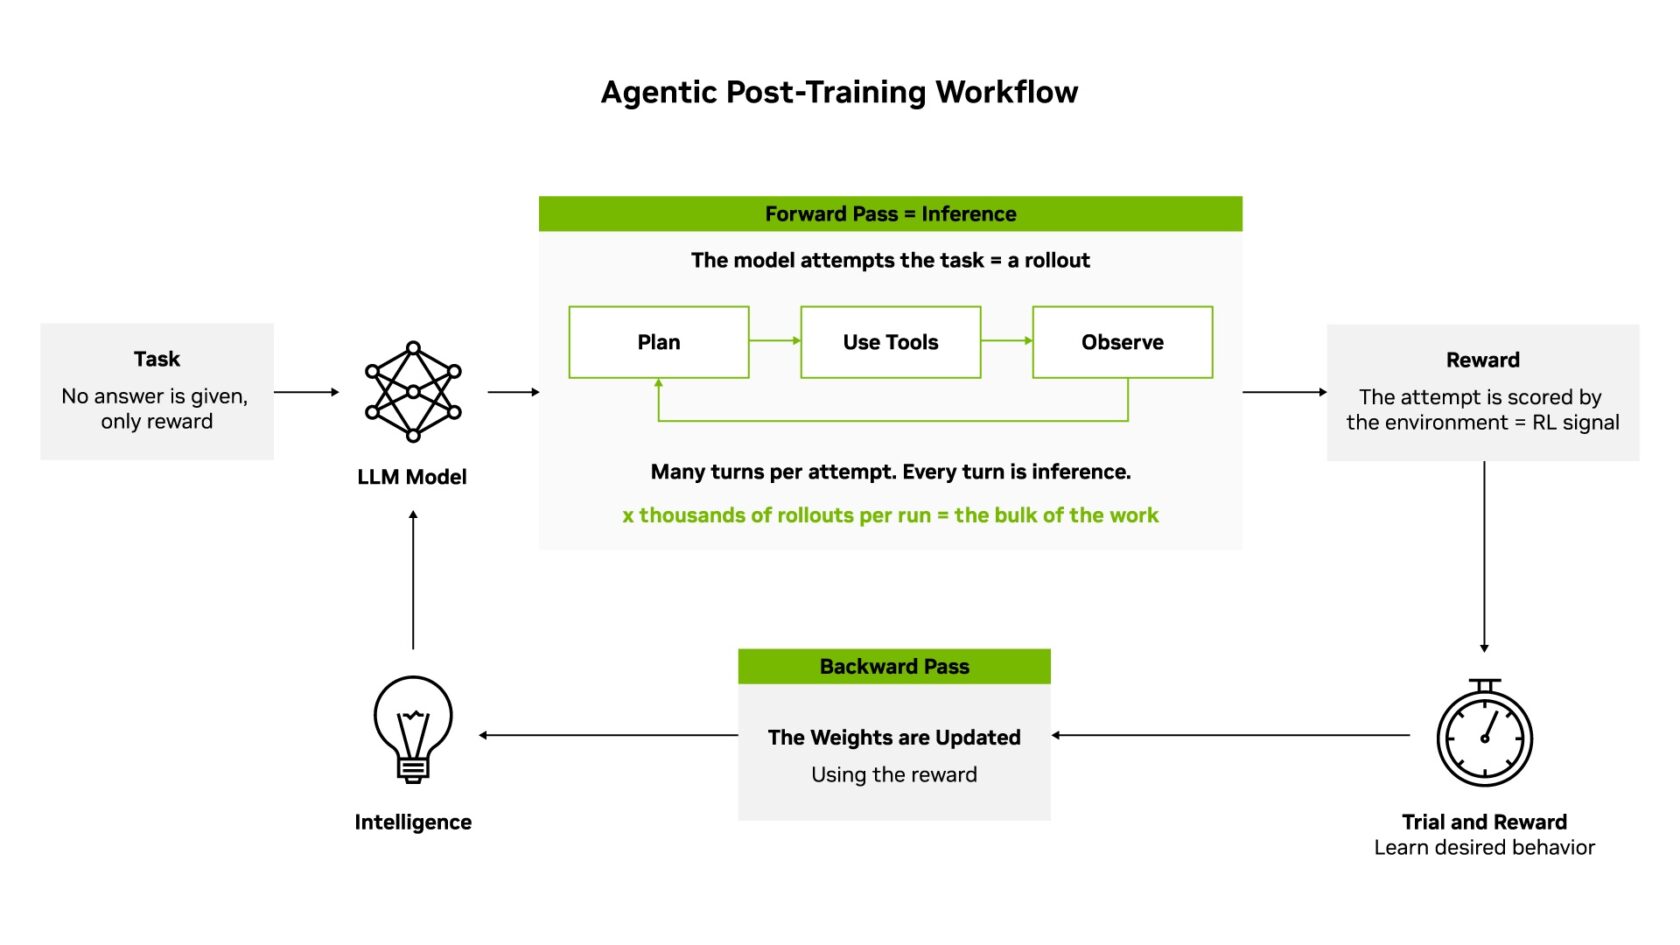
そのため、初期学習のあとにモデルを仕上げる「ポストトレーニング」は、もはや一度きりの最終工程ではなくなったとしています。エージェントが使うツールは週単位で変わり、本番環境では試験段階で想定しなかった事例が次々に表面化します。学習は本番から絶えずループして戻り、個々の実行が大きくなるわけではないのに、実行が止まらないことで計算負荷が積み上がっていく。NVIDIAはこれをエージェント時代の中心的なワークロードだと表現します[1]。
「1ドルあたりの知能」という新しい物差し
ポストトレーニングの目的は、学習ループを構成する順方向の処理(推論)と逆方向の処理(重み更新)の1回ごとの成果を最大化し、投じたコストに対して得られる知能を高めることにあります。ここで登場するのが「1ドルあたりの知能」という指標です[1]。
NVIDIAは、これを従来からある「トークンあたりのコスト(cost per token)」の1つ上の層に位置づけます。トークンあたりのコストが「100万トークンを届けるのにいくらかかるか」という運用効率を測るのに対し、1ドルあたりの知能は「サービスに値するモデルを作り、環境変化に合わせて価値を保ち続けるのにいくらかかるか」を問うものだと説明しています。両者は競合するのではなく入れ子の関係にあり、トークンあたりのコストを下げる基盤は、モデルに組み込む知能1単位あたりのコストも同時に下げるとしています[1]。
実例として挙がるのが、オープンな重みを持つ5,500億パラメータのモデル「Nemotron 3 Ultra」です。学習手順をすべて公開したうえで、実際のソフトウェアのバグ修正を評価する標準ベンチマーク「SWE-bench verified」で71.7パーセントを記録。オープンソースの実際の不具合のおよそ10件中7件で、プロジェクト自身のテストに通る修正を生成したとしています[1][2]。
Vera Rubinは学習用GPUを4分の1に
こうした継続的なポストトレーニングを経済的に成り立たせる基盤として、NVIDIAは現行の「Blackwell」プラットフォームが1回あたりの学習コストを下げ、頻繁な学習を現実的なものにしたと説明します。そのうえで次世代の「Vera Rubin」は、この流れをさらに推し進め、最大級のモデルをBlackwell世代の4分の1のGPU数で学習できるとしています[1]。
Vera Rubinは、より多くの試行(ロールアウト)を1回の実行で回し、より多くの環境を同時に動かし、止まらないポストトレーニングのサイクルを支えることを狙い、エージェント向けの継続学習に最適化して設計されたと位置づけられています。
実際の開発現場での使われ方
NVIDIAは複数の採用事例も紹介しています。フロンティアのオープンモデルを継続的にポストトレーニングするPrime Intellectは、現行のBlackwellで学習を回しつつ、Vera Rubinでは強化学習の環境を拡張し、1回の実行あたりの試行数を増やす計画だとしています。同社が現実的な強化学習の負荷を検証したところ、Vera CPUはx86系アーキテクチャーと比べてCPUあたり平均30パーセント高いスループットを示したとのことです[1]。
検索AIのPerplexityは、数百基のNVIDIA製GPUにまたがって非同期に強化学習のポストトレーニングを実行しています。RDMAを使った重み転送の仕組みにより、1兆パラメータ規模のモデルを学習側と推論側のノード間で2秒未満で同期できるといい、そうして仕上げた「Qwen3 235B」を「GB200 NVL72」システム上で提供しているとしています[1]。
ポストトレーニングをサービスとして提供するTogether AIも、教師ありの微調整や強化学習、選好最適化といった一連の工程をAPI経由で扱えるようにしており、次はVera Rubinの活用を見込んでいるとのことです。NVIDIAは、学習環境向けの「NeMo Gym」や分散ポストトレーニング向けの「NeMo RL」といったオープンなライブラリ群が、こうした作業を研究者だけの特注コードから再現可能な基盤へと変えると強調しています[1]。
まとめ
今回NVIDIAが打ち出した「1ドルあたりの知能」は、AIの評価軸を「1回の推論の安さ」から「賢いモデルを作り、賢いまま保ち続けるコスト」へと広げる考え方です。ポストトレーニングが止まらないループになるほど計算負荷は増え続けますが、Vera RubinはそれをBlackwell世代の4分の1のGPUでこなすとされます。Prime IntellectやPerplexityといった現場の数値がどこまで一般に再現されるのかを含め、エージェント時代のインフラ競争がコストの物差しごと変わりつつあることを示す発表と言えそうです。
出典:https://blogs.nvidia.com/blog/nvidia-vera-rubin-post-training-intelligence-per-dollar/