理化學研究所、Cleveland Clinic 與 IBM 組成的聯合團隊,以量子電腦計算 12,635 個原子的蛋白質複合體,入圍 2026 年 ACM 高登貝爾獎(Gordon Bell Prize)決選名單。這被視為目前以量子計算處理過、具有生物學意義的最大規模分子。得獎結果將於 11 月的 SC26 公布。
12,635 個原子從何而來
這次的計算對象是 T4 溶菌酶與胰蛋白酶這兩種蛋白質。前者是分解細菌膜成分的酵素,後者由胰臟製造並參與消化,兩者都是生物化學教科書裡的經典分子。
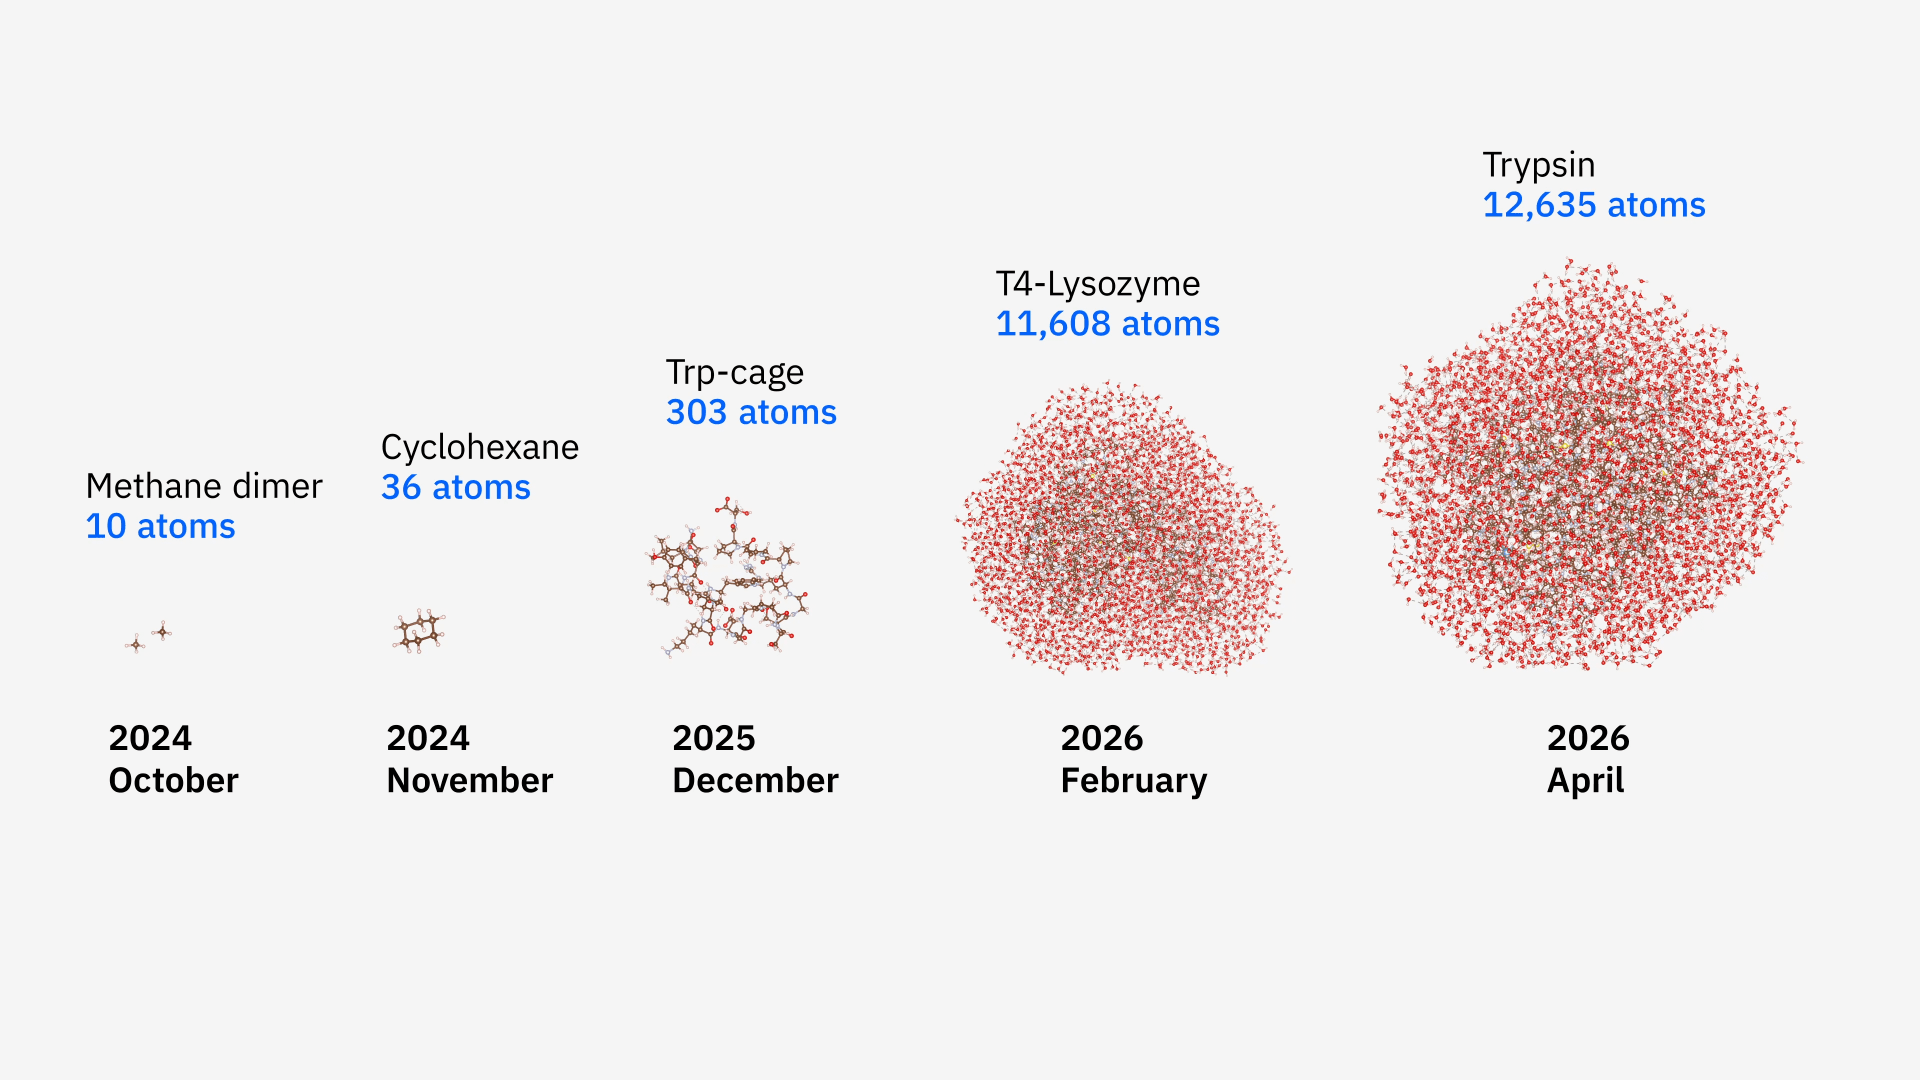
這次計算的特別之處,在於蛋白質並不是孤立地懸在真空中,而是與它在自然界實際結合的分子(配體)配成一組,並且浸在液態水的環境裡。在這樣的條件下,T4 溶菌酶的系統達到 11,608 個原子,胰蛋白酶則是 12,635 個原子。換句話說,電子結構是在更接近體內真實狀況的條件下算出來的。
作為對照的,是同一支團隊不久前處理過的 303 個原子迷你蛋白 Trp-cage。相較之下,系統規模擴大約 40 倍,在流程中的某個特定環節上精確度提升了 210 倍。量子計算在化學領域的應用,在很短的時間內完成了兩個數量級的跳躍。
讓量子與古典分工的思路
所採用的架構稱為以量子為中心的超級計算(QCSC)。它並非讓量子電腦獨力解出整個大分子,而是把計算拆成一個個較小的叢集:簡單的部分交給古典電腦,只有電子糾纏過強、古典方法難以處理的部分才交由量子電腦,最後再由古典端把分子重新拼回去。
拆解分子的步驟本身也做了改良。依照傳統做法,分子尺寸增為兩倍,所需的古典計算資源就會膨脹到 25 倍,因此在胰蛋白酶這種規模下,拆解本身就無法執行。團隊利用了一項性質:距離超過 7 到 10 埃以外的資訊在量子力學層次上幾乎不產生影響,於是把計算範圍收斂到以每個原子為中心的球體內部。
量子端的方法也有更新。在原有的取樣式量子對角化(SQD)之上,團隊導入名為 TrimSQD 的做法,先把搜尋空間切成多個子空間再逐一檢視,讓值得交給量子電腦處理的電子組態更容易被找出來。
156 量子位元的 Heron 與富岳、Miyabi-G
硬體組成同樣是這項研究的看點。量子取樣由兩台 156 量子位元的 IBM Quantum Heron r2 處理器分擔,一台設在 Cleveland Clinic,另一台設在理化學研究所,等於把美國與日本的量子電腦同時用在同一次計算上。實際動用的量子位元最多為 94 個,執行了 9,200 條線路、耗時超過 100 小時,蒐集到 13 億筆量測結果。
量子電腦回傳的子空間對角化,則由兩台古典超級電腦承擔:理化學研究所的富岳,以及由東京大學與筑波大學營運的 GPU 機種 Miyabi-G。QPU(量子處理器)、CPU 與 GPU 各自負責擅長的環節,可以看出量子計算正被納入更大的運算平台,而不再是一台孤立的裝置。
要說明的是,這套方法目前尚未超越最好的古典方法。IBM 也明白指出這一點,並把成果定位為:量子電腦已經成為今日科學研究中真正可用的工具。
9 月的追加成果:省去人工資料搬移
針對 5 月公開的初步結果,9 月又發布了後續進展。代表分子之間結合強度的結合能,其計算精確度進一步提升。在新藥開發的脈絡下,能否預測候選化合物與目標蛋白的結合強度是關鍵,因此這裡的精確度直接關係到實用性。
另一項進展,是在理化學研究所新的 GPU 超級電腦 ROQUO 上驗證了整套工作流程。過去在量子機與古典機之間仍留有以人工交接資料的環節,透過把 CPU、GPU、QPU 統一調度,這道人工工序被取消,傳輸造成的錯誤與等待時間也隨之減少。這是一項不顯眼卻分量很重的改良,讓流程更接近研究人員可以直接上手的狀態。
主導這項研究的 Cleveland Clinic 的 Kenneth Merz 把這個結果形容為夢寐以求的事。此次開發的方法據稱可以直接移植到 IBM 預計於 2029 年推出的容錯量子電腦 IBM Quantum Starling,因此即使硬體換代,累積下來的成果也不會白費。
總結
單看 12,635 這個數字,很容易被當成規模競賽,但其核心其實是如何在量子與古典之間分配工作的設計問題。日本這一側由理化學研究所的富岳與 ROQUO,以及東京大學與筑波大學的 Miyabi-G 承擔了計算的主要部分,這項研究同時也是 NEDO 與日本經濟產業省量子與超級電腦協同專案的成果。能否得獎,將在 11 月 15 日至 20 日於芝加哥舉行的 SC26 揭曉。