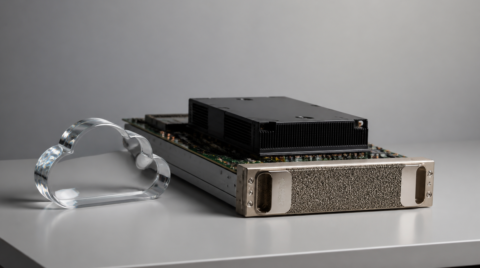
Meta證實已開始對自研AI推論晶片「Arke」(內部代號MTIA 450)進行實機測試,目標是在2027年上半年將其部署至資料中心。據悉,同樣以推論為主要用途的次世代晶片「Astrid」(MTIA 500)的設計也即將完成。這項雙線布局旨在降低對NVIDIA GPU的依賴,同時控制持續膨脹的AI基礎設施成本。
同樣圍繞推論打造的「Arke」與「Astrid」
Meta的自研AI晶片,是在先前MTIA 300等「MTIA系列」基礎上的延續。此次曝光的Arke(MTIA 450)是第三代推論晶片,專門用於執行支撐Facebook、Instagram與WhatsApp等自家服務的已訓練模型,設計目標是提升每瓦效能。它並非為需要極致即時反應的場景而生,而是把重心放在如何以更低成本處理大量推論工作上。
另一款晶片Astrid(MTIA 500)則是第四代產品,據稱距離設計完成僅剩約一個月,預計到2027年底前將實現更大規模的部署。據稱MTIA系列在設計上可勝任包含訓練在內的多種工作負載,但Meta表示短期內會將Arke與Astrid都主要用於生成式AI的推論處理。
9月1日交付的原型機,與模擬結果誤差僅2%至3%
12顆Arke原型晶片已於2026年9月1日交付,早期測試結果顯示與Meta先前的模擬預測相比,誤差僅為2%至3%。測試不僅使用了Meta自家的模型,還包括DeepSeek與Alibaba所開發的模型,據稱從第一天起就運作順利。連第三方模型的相容性都一併公開驗證,可以看出Meta希望將其打造成真正通用的推論平台。
晶片製造由TSMC負責,晶片設計方面則有Broadcom參與協作。據悉,Meta與Broadcom的設計合作將持續到2029年,意味著這是一項橫跨多個世代產品的長期布局,而非一次性專案。
兼顧訓練與推論的晶片「Olympus」遭喊停
與Arke及Astrid一同被揭露的,還有一款名為「Olympus」、原計畫同時兼顧訓練與推論功能的通用晶片已遭取消開發。根據Meta的估算,將兩種功能整合到單一晶片中,會使製造成本提高約30%,而在晶片部署達到吉瓦(gigawatt)級規模後,這樣的成本差距被認為難以接受。
負責Meta自研晶片專案的工程副總裁Yee Jiun Song表示,當企業開始累積起以吉瓦計的龐大運算規模時,對成本的敏感度會明顯提高。將Arke與Astrid都聚焦於推論、並針對這項單一用途進行最佳化的雙線布局,正是這項理念的直接體現。
12個月內部署逾1吉瓦,降低對NVIDIA的依賴
Meta已承諾在任意12個月週期內,透過自研晶片部署超過1吉瓦的運算能力,並表示此後將進一步加速這項進程。其目標是在訓練環節持續使用價格高昂的NVIDIA GPU,同時將推論工作轉移到自研晶片上,藉此降低整體AI基礎設施成本。隨著生成式AI服務的普及不斷推升資料中心的用電需求與資本支出,透過自研晶片來最佳化成本,正逐漸成為不只Meta一家、而是眾多主要AI企業共同面對的課題。
總結
Meta已開始對新一代推論AI晶片Arke(MTIA 450)進行實機測試,目標是在2027年上半年實現資料中心部署。同樣以推論為主要用途的姊妹晶片Astrid(MTIA 500)設計即將完成,預計將於2027年底前推出。儘管原型晶片與模擬結果的誤差僅為2%至3%,Meta仍因成本考量喊停了兼顧訓練與推論的晶片專案「Olympus」。Meta設定的目標是每12個月部署超過1吉瓦的自研晶片運算力,這項舉措被視為在降低對NVIDIA依賴的同時控制AI基礎設施成本的一次嘗試,值得持續關注。