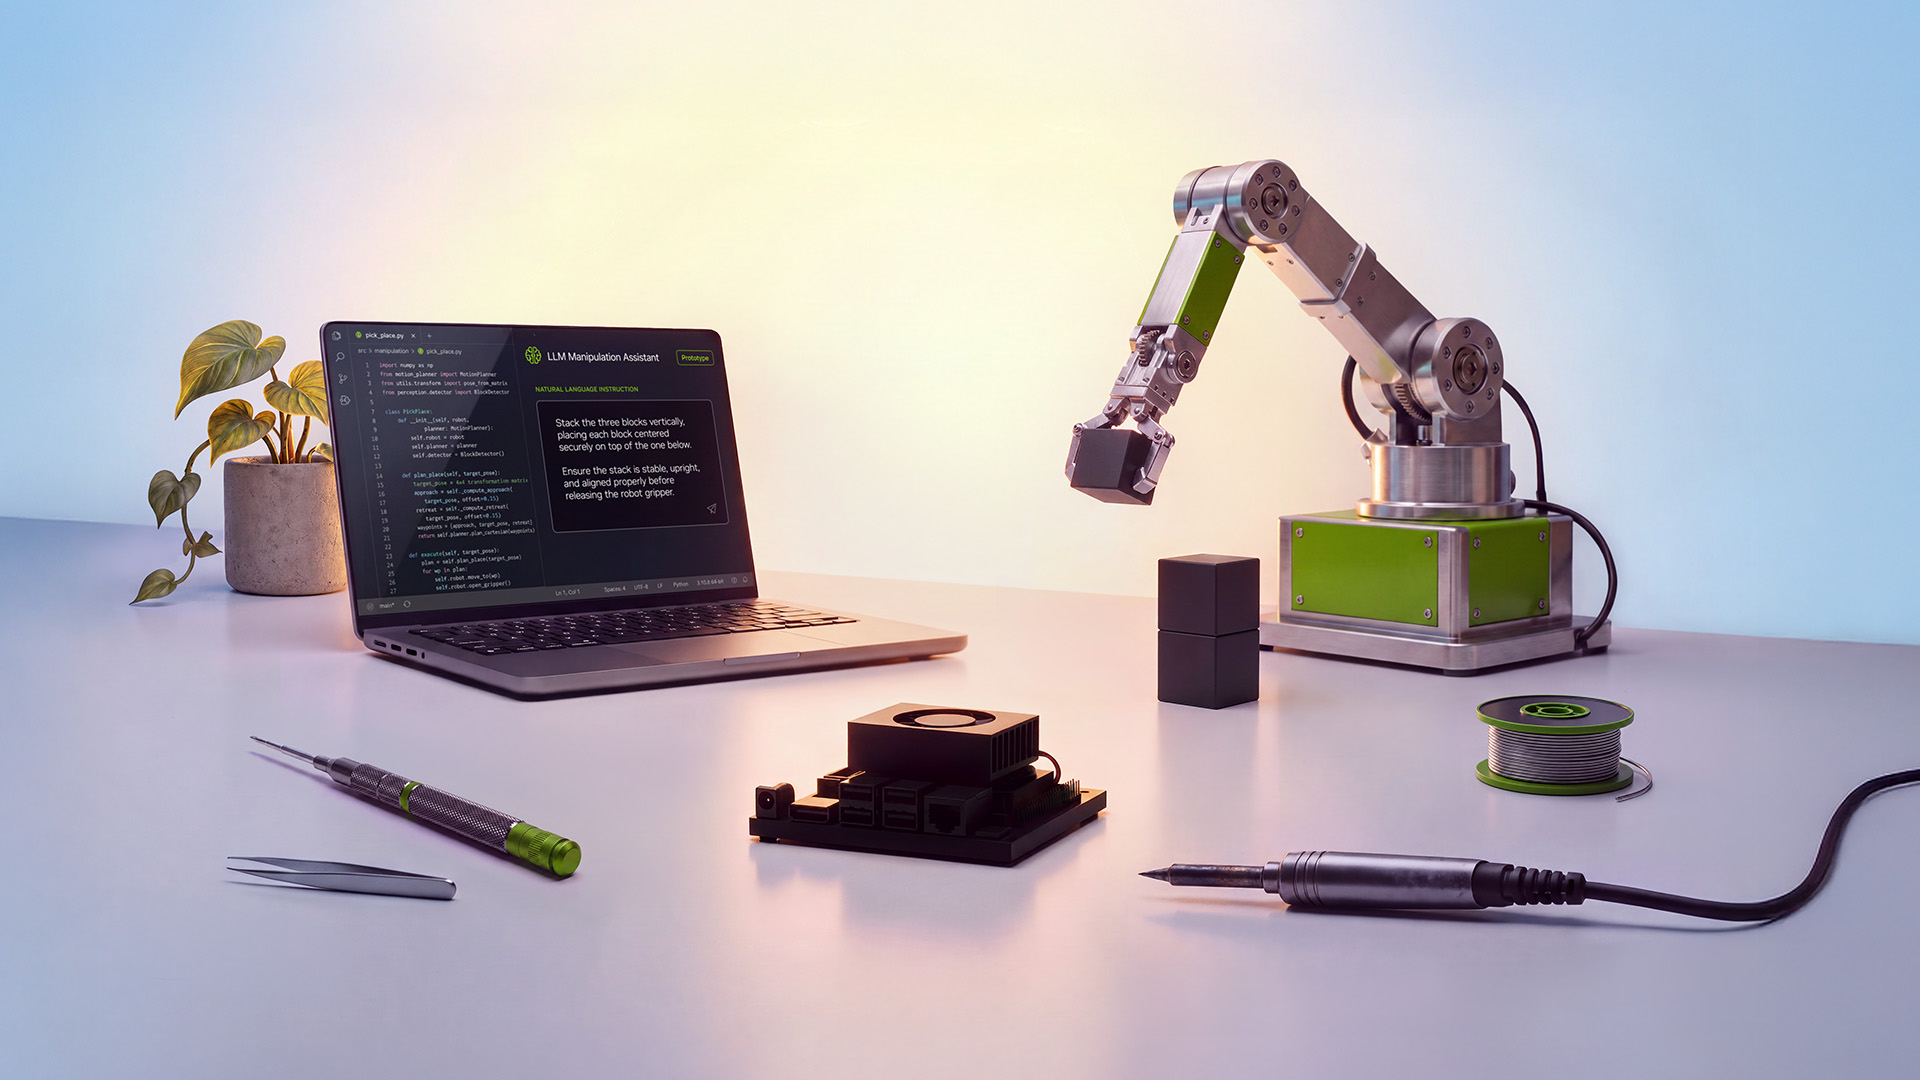
NVIDIA於2026年8月25日(當地時間)發表了面向嵌入式裝置的AI模組「Jetson Orin Nano 2」。AI運算效能達78TOPS,相較前一代「Jetson Orin Nano Super」的推論效能提升至2倍。電路板尺寸維持不變,在輸出同等效能時功耗降低40%。模組與開發者套件預計於2027年上半年上市。
尺寸不變,推論效能倍增
入門等級的嵌入式AI模組,一直是那些需要「小巧又省電的大腦」的機器所依賴的基礎,例如機器人、配送與巡檢無人機、影像辨識系統等。Jetson Orin Nano 2並未擴大這個框架,而是替換了內部規格。
處理器採用8核心的Arm Cortex-A78,記憶體為8GB LPDDR5X,頻寬最高120GB/s。GPU基於Ampere架構,配備1,536個CUDA核心與改良版Tensor核心。AI運算效能為78TOPS,高於前一代Jetson Orin Nano Super的67TOPS。
值得留意的是,實際推論速度的成長幅度大於運算效能數值的成長。NVIDIA表示,藉由Tensor核心的改良與記憶體頻寬的提升,AI模型的推論效能達到前一代的2倍。在嵌入式應用中,能多快讀取模型權重往往比原始運算能力更關鍵,因此採用LPDDR5X的效益相當直接。
15瓦模式即可達到前一代同等效能
功耗範圍為15瓦至40瓦。上限比前一代更高,但真正具實務意義的是下限。以15瓦模式運作時,Jetson Orin Nano 2能夠輸出與前一代相同的效能。換句話說,若現有效能已經足夠,功耗就可以減少40%。
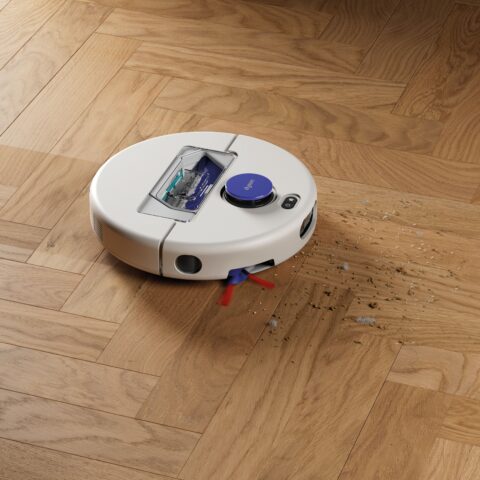
對於仰賴電池驅動的無人機與掃地機器人這類散熱與電力預算吃緊的裝置,這個差距會直接反映在續航時間與機身設計的自由度上。較貼近實務的理解是:設計者現在可以在「堆效能」與「省電」之間自行取捨。
NVIDIA負責機器人與邊緣AI的副總裁Deepu Talla表示,現今的中小型前沿模型已達到去年最大規模前沿模型的準確度,讓邊緣裝置上的即時推論成為可能。模型變小之後,硬體也隨之跟上。
以開放模型為前提,Gemma 4與Qwen 3同樣可運行
Jetson Orin Nano 2能夠運行針對記憶體效率最佳化的大型語言模型(LLM)與視覺語言模型(VLM)。除了NVIDIA自家的開放模型「NVIDIA Cosmos」與「NVIDIA Nemotron」之外,支援清單中還列出Google的「Gemma 4」以及Alibaba的「Qwen 3」等外部開放模型。
這背後反映的是邊緣AI開發方式的轉變。過去的慣例是搭載影像分類或物體偵測這類單一功能的模型,如今則傾向搭載能同時處理語言與影像的模型,先理解脈絡再行動。對機器下指令的方式,正從設定畫面轉向自然語言。
在軟體層面,NVIDIA提供開放的軟體堆疊以及「NVIDIA Jetson agent skills」。已有超過300萬名開發者在NVIDIA的機器人平台上進行開發,因此既有成果容易延續使用。
率先採用的企業與周邊生態夥伴
率先採用或評估的企業包括影像辨識設備廠商Cognex、工程機械廠商Doosan Bobcat,以及家用掃地機器人廠商Matic。
Matic計劃透過Jetson Orin Nano 2,讓使用者與掃地機器人之間的互動更為自然。共同創辦人暨執行長Navneet Dalal表示,家用機器人需要理解人、精確繪製空間地圖、掌握物體與空間的配置,並在不斷變動的環境中自主完成清潔。對話式AI、手勢偵測、精密建圖與語意理解等功能,都要在小型機身內完成。
Alphabet旗下的無人機配送企業Wing,目前在配送無人機上採用現行的Jetson Orin Nano Super,並計劃評估Jetson Orin Nano 2。其感知部門負責人Dinuka Abeywardena表示,無人機配送仰賴能夠快速且可靠地理解真實世界的AI。
除此之外,AAEON、ADLINK、Advantech、Aetina、Antmicro、Aptiv、AVerMedia、Connect Tech、Seeed Studio等眾多合作夥伴正在準備載板、硬體系統與參考設計。這一層生態的厚度,也是Jetson系列在嵌入式領域持續被選用的原因之一。
總結
Jetson Orin Nano 2是一款入門等級的嵌入式AI模組,在尺寸不變的前提下實現78TOPS與2倍推論效能,並且在15瓦模式下能以少40%的功耗輸出與前一代同等的效能。能在邊緣端運行包含Gemma 4與Qwen 3在內的開放LLM與VLM,是它與過去以單一功能模型為前提的設計最大的差異。模組與開發者套件預計於2027年上半年提供,實機上市還有一段時間。在此之前,哪些開放模型會成為這個等級的標準配置,將是下一個值得觀察的重點。