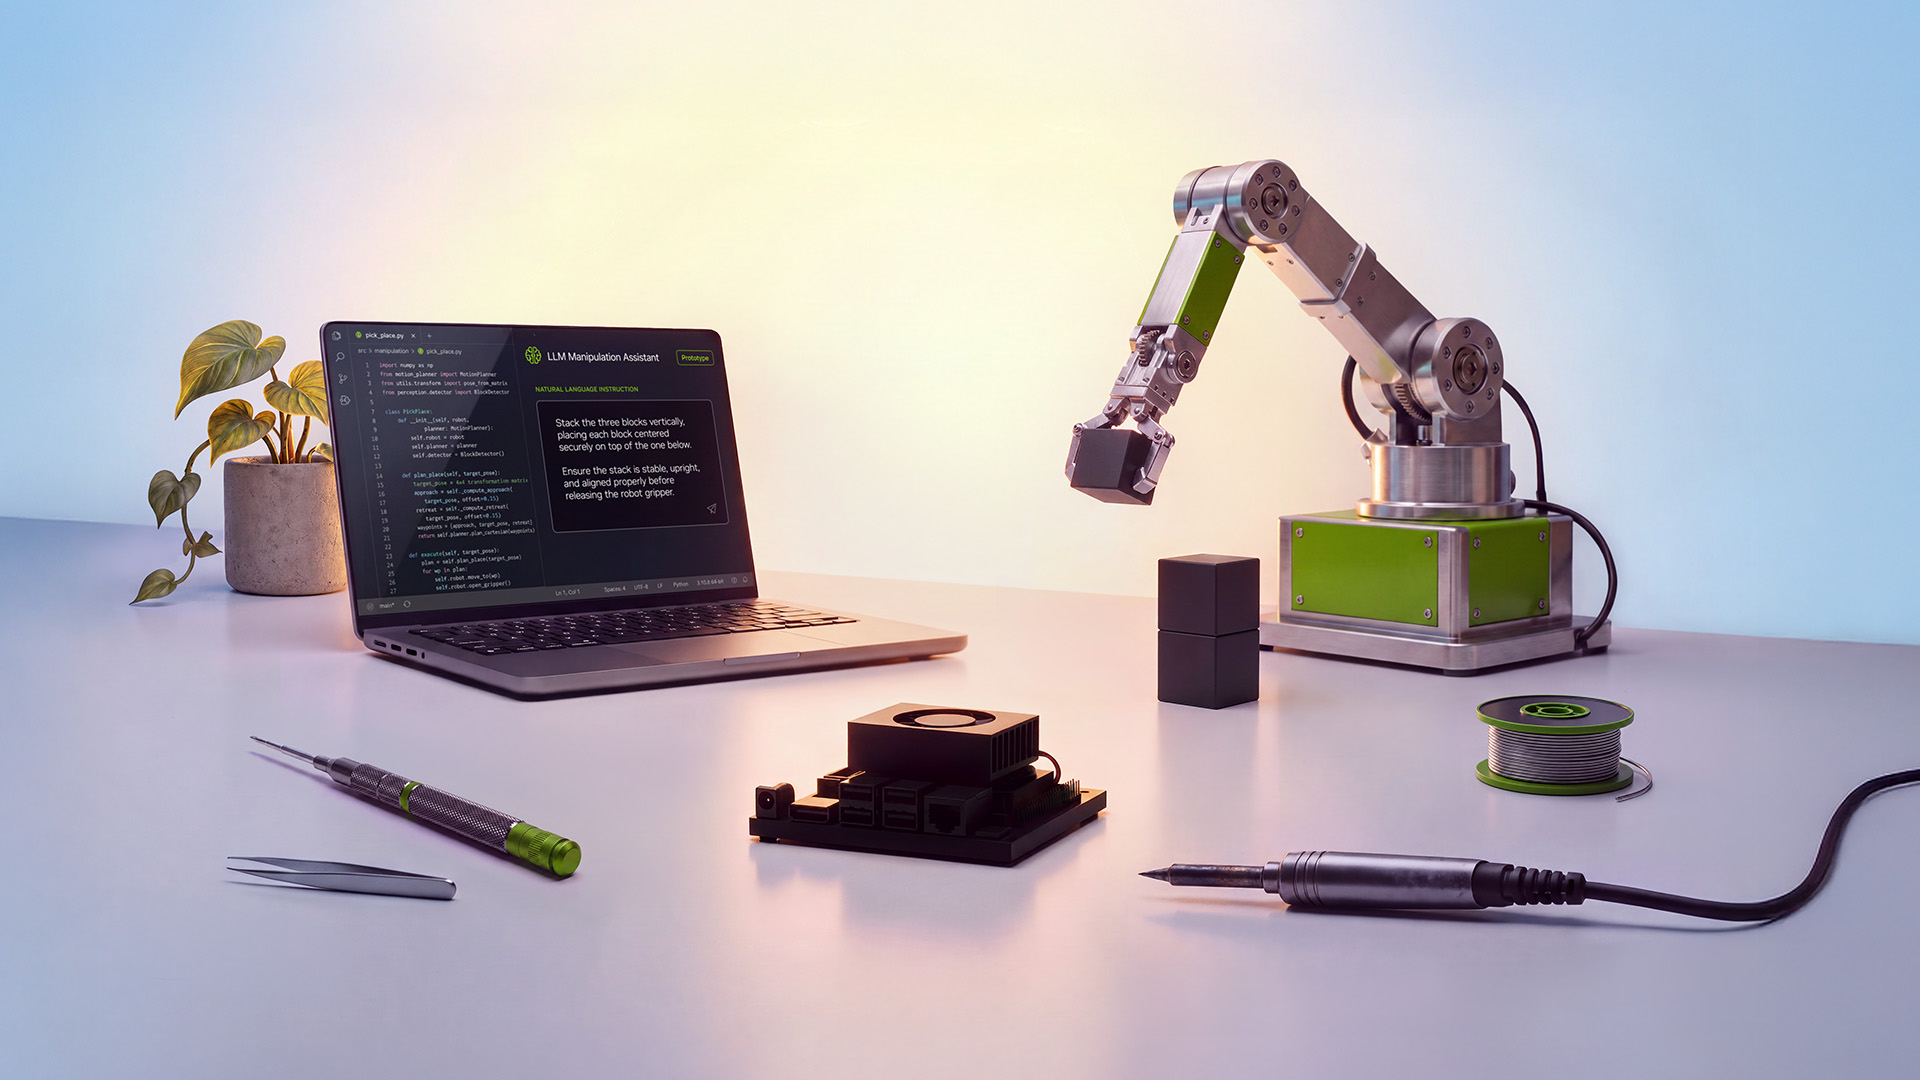
英伟达于2026年8月25日(当地时间)发布了面向嵌入式设备的AI模块「Jetson Orin Nano 2」。其AI算力达到78TOPS,相比上一代「Jetson Orin Nano Super」推理性能提升至2倍。电路板尺寸保持不变,在输出同等性能时功耗降低40%。模块与开发者套件预计于2027年上半年上市。
尺寸不变,推理性能翻倍
入门级嵌入式AI模块一直是那些需要「小巧且省电的大脑」的机器的基础,例如机器人、配送与巡检无人机、图像识别系统等。Jetson Orin Nano 2没有扩大这个框架,而是替换了内部配置。
CPU采用8核Arm Cortex-A78,内存为8GB LPDDR5X,带宽最高120GB/s。GPU基于Ampere架构,配备1,536个CUDA核心以及改进版Tensor核心。AI算力为78TOPS,高于上一代Jetson Orin Nano Super的67TOPS。
值得关注的是,实际推理速度的提升幅度大于算力数值的增幅。英伟达表示,得益于Tensor核心的改进与内存带宽的提高,AI模型的推理性能达到了上一代的2倍。在嵌入式场景中,能多快读取模型权重往往比原始算力更关键,因此采用LPDDR5X直接带来了收益。
15瓦模式即可达到上一代同等性能
功耗范围为15瓦至40瓦。上限比上一代更高,但真正有实际意义的是下限。在15瓦模式下运行时,Jetson Orin Nano 2能够输出与上一代相同的性能。也就是说,如果现有性能已经够用,功耗就可以削减40%。
对于依靠电池驱动的无人机和清洁机器人这类热量与功耗预算紧张的设备,这一差距会直接反映在续航时间与机身设计的自由度上。更贴近实际的理解是:设计者现在可以在「堆性能」和「省电」之间做选择。
英伟达机器人与边缘AI副总裁Deepu Talla表示,如今的中小型前沿模型已经达到去年最大规模前沿模型的精度,从而让边缘设备上的实时推理成为可能。模型变小之后,硬件也随之跟上。
以开放模型为前提,Gemma 4与Qwen 3同样可运行
Jetson Orin Nano 2能够运行针对内存效率优化的大语言模型(LLM)与视觉语言模型(VLM)。除英伟达自家的开放模型「NVIDIA Cosmos」和「NVIDIA Nemotron」之外,支持列表中还包括谷歌的「Gemma 4」以及Alibaba的「Qwen 3」等外部开放模型。
这背后是边缘AI开发方式的转变。以往的惯例是搭载图像分类或物体检测这类单一功能的模型,而现在的方向是搭载能同时处理语言与图像的模型,先理解上下文再执行动作。向机器下达指令的方式,正在从设置界面转向自然语言。
在软件层面,英伟达提供开放的软件栈以及「NVIDIA Jetson agent skills」。已有超过300万名开发者在英伟达的机器人平台上进行开发,因此现有成果易于迁移。
率先采用的企业与周边生态伙伴
率先采用或验证的企业包括图像识别设备厂商Cognex、工程机械厂商Doosan Bobcat以及家用清洁机器人厂商Matic。
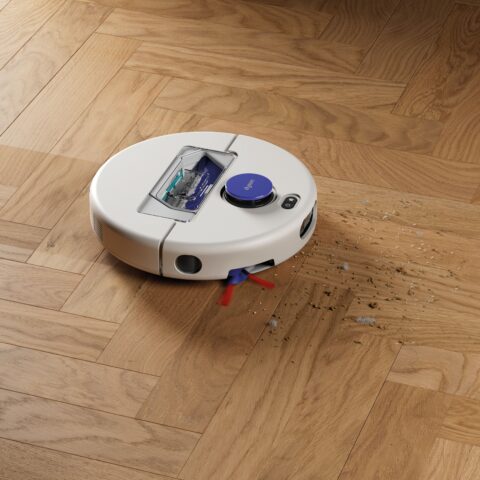
Matic计划借助Jetson Orin Nano 2让用户与清洁机器人的交互更加自然。联合创始人兼CEO Navneet Dalal表示,家用机器人需要理解人、精确绘制空间地图、掌握物体与空间的布局,并在不断变化的动态环境中自主完成清洁。对话式AI、手势检测、精密建图与语义理解等功能都要在小型机身内完成。
Alphabet旗下的无人机配送企业Wing目前在配送无人机上使用现行的Jetson Orin Nano Super,并计划评估Jetson Orin Nano 2。其感知负责人Dinuka Abeywardena表示,无人机配送依赖于能够快速、可靠地理解现实世界的AI。
此外,AAEON、ADLINK、Advantech、Aetina、Antmicro、Aptiv、AVerMedia、Connect Tech、Seeed Studio等众多合作伙伴正在准备载板、硬件系统与参考设计。这一生态层的厚度,也是Jetson系列在嵌入式领域持续被选用的原因之一。
总结
Jetson Orin Nano 2是一款入门级嵌入式AI模块,在尺寸不变的前提下实现了78TOPS与2倍推理性能,并且在15瓦模式下能以少40%的功耗输出与上一代同等的性能。能够在边缘侧运行包括Gemma 4与Qwen 3在内的开放LLM与VLM,是它与以往单一功能模型设计的差别所在。模块与开发者套件预计于2027年上半年提供,实机上市还需要一段时间。在此之前,哪些开放模型会成为这一级别的标配,将是下一个观察重点。