谷歌 DeepMind 于 7 月 30 日发布了面向机器人的推理模型「Gemini Robotics ER 2」[1]。它扮演机器人的高层大脑,负责编排多步骤任务,实际的动作执行则交给另一个模型。本次的两大重点,一是能够持续观看视频来判断自己的完成进度,二是让不同类型的机器人分工协作。开发者可通过 Gemini API 与 Google AI Studio 使用[1]。
为了不因思考而停顿
机器人要在人类生活的场所派上用场,仅有准确的空间理解还不够。判断本身必须跟上物理世界的实时速度[1]。
Gemini Robotics ER 2 正是围绕这个时间问题设计的。它负责与人对话、理解周围环境、制定多步骤计划,而真正驱动电机的部分则交给下层的 VLA(视觉语言动作)模型[1]。模型还能自行调用 Google 搜索,或是开发者自定义的任意函数[1]。
为了压缩延迟,ER 2 通过 Gemini Live API 的双向流式接口连接[1]。开发者把 VLA 模型、导航 API 等底层控制接口声明为工具,再将视频、音频或文本直接推送给模型[1]。这样一来,机器人每次推算下一步时出现的停顿感就消失了[1]。谷歌 DeepMind 表示,在实机 VLA、仿真 VLA、人工遥操作这三种控制方式下,工具编排的准确度都超过了上一代 ER 1.6[1]。
作为演示,官方公开了让 ER 2 调用波士顿动力 Spot 的导航与机械臂 API 的案例,用户开口就能让机器人把东西取来。相关代码已放在 GitHub 上[1]。
从视频判断「是否已经完成」
对机器人来说,最难的一点是自行判断任务是否结束[1]。ER 2 为此引入了两把尺子。
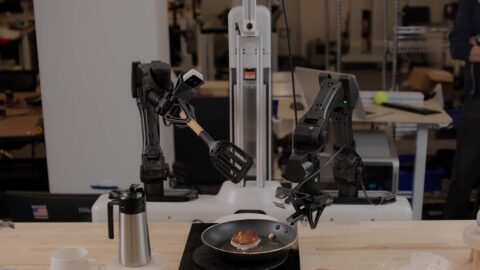
第一把是进度分类。系统把视频的每一帧划分到 0 至 20%、20 至 40%等 5 个档位,把当前进度量化成数值[1]。中途失败时,机器人只需重做该步骤,而不必推翻整个流程重来[1]。ER 2 在该任务上的准确率为 57.4%,超过上一代及竞争对手的前沿模型[1]。
第二把是关键时刻定位,即准确指出重要事件发生的那一帧,例如咖啡倒满杯子的瞬间[1]。ER 2 的准确率为 91.3%,平均偏差为 0.96 秒[1]。谷歌 DeepMind 称,这一水平足以与规模大得多的模型类别竞争,而计算成本只是其中一部分,执行速度还快 4 倍[1]。两把尺子合在一起,机器人就能确认拧灯泡、系垃圾袋这类工作是否按要求完成,然后再进入下一步[1]。
不同种类的机器人分工合作
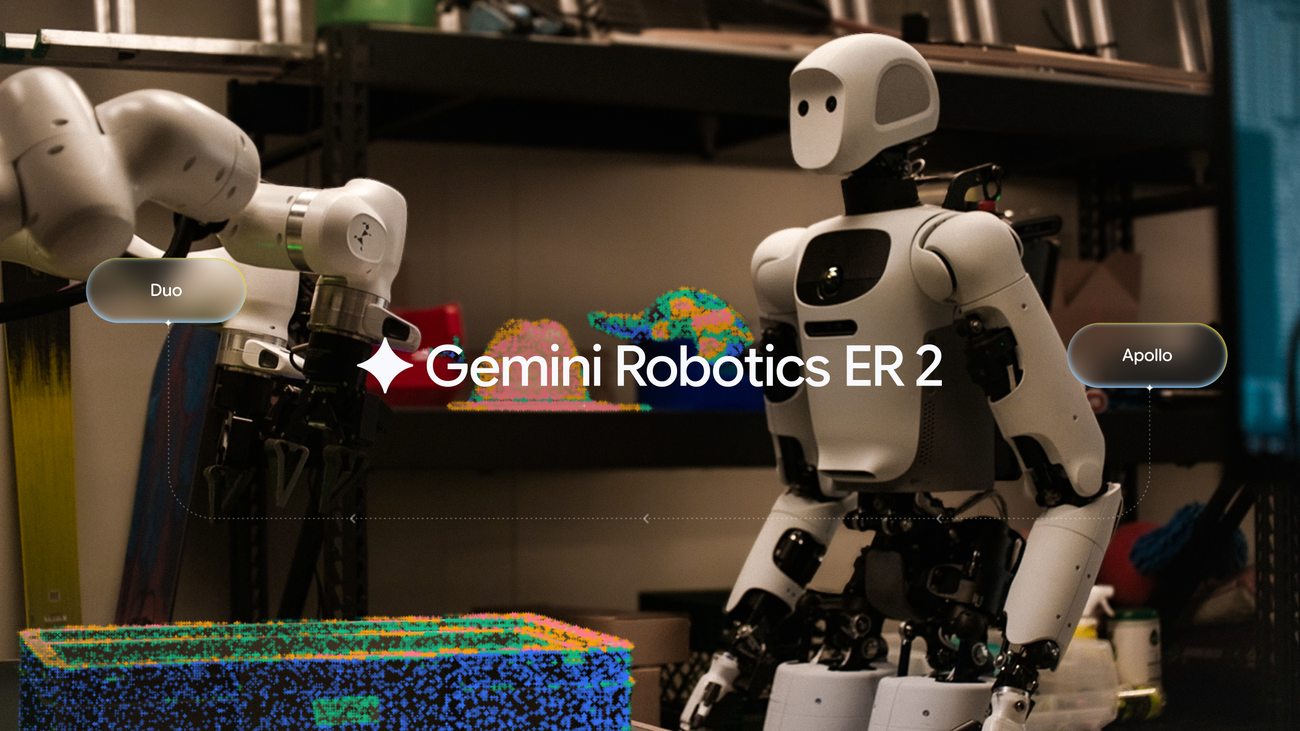
轮式机器人擅长室内,人形机器人则更适应崎岖地面,没有哪一台机器人适合所有任务[1]。ER 2 因此加入了多机协作,让不同的机器通过共享的语义理解互相沟通、交接,共同完成工作[1]。官方展示了 Apptronik 的人形机器人 Apollo 2 与 Franka 的 F3 Duo 协同作业的例子[1]。
空间理解本身也有更新。成功与失败的检测不再基于静态截图,而是直接作用于原始视频,可以捕捉洒落、打滑、错位等执行过程中的失误[1]。仪表读取从圆形表盘和视镜扩展到数字显示屏、直线刻度、直尺和液体温度计,共在 10 种仪表上做了验证[1]。
有人靠近就停下
安全方面,谷歌 DeepMind 表示,在衡量遵守物理约束能力的 Safety Instruction Following 与衡量人员接近感知的 Human Proximity 这两项基准上,该模型取得了迄今最好的成绩[1]。当有人靠近时,模型会让人形机器人停下,等到周围空出来后再自主恢复作业[1]。
官方还准备了一项新基准,用来衡量基础模型能否安全地担任 VLA 的编排者,评估项目包括是否遵守安全约束、是否监控环境、能否判断任务在物理上是否可行,以及在不确定时是否会主动请求人类介入[1]。在谷歌 DeepMind 的公告中,这套框架以 ASIMOV-Agentic 的名义公开,其中还会测试智能体能否拒绝来自 VLA 的危险工具调用[2]。
三款模型中的一款
ER 2 并非单独发布,而是 Gemini Robotics 2 这一三模型阵容中的一环[2]。另外两款分别是能从脚尖到指尖控制人形机器人的 VLA 模型 Gemini Robotics 2,以及可在机器人本体上运行的轻量版 Gemini Robotics On-Device 2[2]。On-Device 2 能在数小时内适配形状、传感器与自由度都不同的新型双臂机器人,多数情况下所需数据不到 200 个样例[2]。
三者的开放程度并不一致。ER 2 已在 Gemini API 与 Google AI Studio 上线,在 Gemini Enterprise Agent Platform 上为私有预览[1][2];而 VLA 与 On-Device 版本仍仅面向早期合作伙伴[2]。越是直接驱动肢体的部分,开放得越保守,因此外部开发者眼下能接触到的,主要是负责规划与监督的 ER 2。
总结
Gemini Robotics ER 2 是负责机器人规划与监督的推理模型。它能从视频中判断进度,以平均 0.96 秒的偏差定位关键瞬间,并支持不同类型机器人之间的分工。借助 Gemini Live API 的低延迟连接,过去每次思考都会中断动作的问题也得到解决。面向开发者的部分已通过 Gemini API 与 Google AI Studio 开放,而真正驱动肢体的 VLA 模型仍停留在早期访问阶段。
来源[1]:https://blog.google/innovation-and-ai/models-and-research/google-deepmind/gemini-robotics-er-2/
来源[2]:https://deepmind.google/blog/gemini-robotics-2-brings-whole-body-intelligence-to-robots/