中国のx86互換プロセッサメーカーZhaoxin(兆芯)が、上海のAIチップ企業・東方算芯との産業提携を明らかにしました。東方算芯が2026年7月13日に発表した国産初の「ソフトウェア定義・近メモリ演算」型3D AIチップ「DF1000」と、Zhaoxin独自のZX86 CPUを組み合わせ、汎用計算からAI演算までを一貫して国産技術でまかなう「双チップ(デュアルチップ)」構想を打ち出しています。海外の先端製造プロセスに頼らずに高性能な計算基盤を築く狙いです。
上海で示された「双チップ」構想
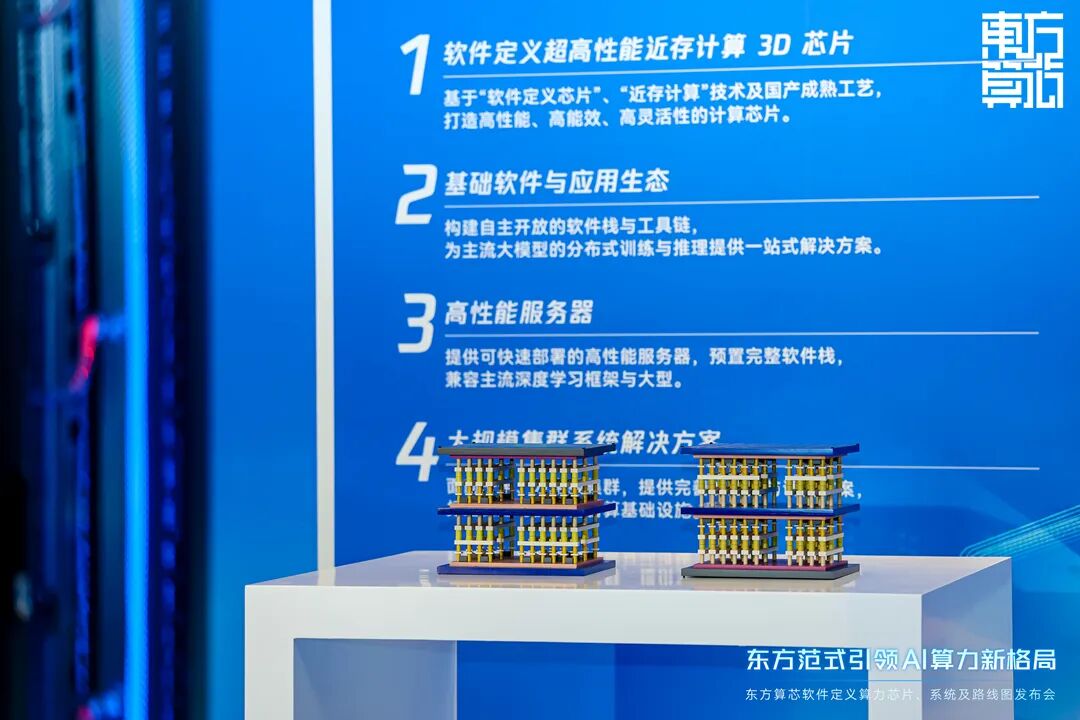
東方算芯は7月13日、上海市内でDF1000のお披露目イベントを開催し、同チップを初公開しました[1]。この場にはZhaoxinの総経理兼総工程師である王惟林氏が招かれ、「上海Zhaoxin × 東方算芯 共に上海の計算基盤を築く」と題した講演を行っています[1]。
王惟林氏は、両社の協業をAIチップ産業の連携イノベーションの実践と位置づけました。ハードウェアの標準的な適合と下層ソフトウェアの接続を通じて、ZX86 CPUとAI演算チップの技術を深く連動させ、汎用計算から専用のAI演算までをつなぐ国産の産業チェーンを構築するとしています[1]。国内の官公庁や企業、産業エコシステムに適合した一体型の計算基盤を目指す考えです。
DF1000が採る「ソフトウェア定義+3D近メモリ演算」
主役となるDF1000は、国産で初めて「ソフトウェア定義」と「近メモリ演算」を組み合わせた3D AIチップです[1]。近メモリ演算とは、演算を行う論理層とデータを保持するメモリ層を縦方向に積み重ねて両者の距離を縮め、データのやり取りを高速化する手法を指します。DF1000は記憶用のウェハーと論理用のウェハーを3Dハイブリッドボンディング(複数のチップを微細な接合で貼り合わせる技術)で積層し、配線間隔を数十マイクロメートルからサブマイクロメートル級まで詰めています[2]。
性能面では、国産の成熟した14nmプロセスを用いながらBF16精度で520TFLOPSの演算性能を実現し、メモリの読み書き帯域は6.4TB/s、チップ間を束ねるScale-up帯域は900GB/sに達するとしています[1][2]。東方算芯は、この設計によって計算システムが長年抱えてきた「メモリの壁」「帯域の壁」「消費電力の壁」という3つのボトルネックを崩したと説明します[2]。従来のHBM(広帯域メモリ)を使わずに、同じ容量ならHBMの5倍以上の帯域を得られると主張しており、DF1000はすでに完全なチップ試作検証を終え、128枚規模のクラスターでの安定稼働も確認したとしています[2]。
ZX86の実績と、先端プロセスに依存しない狙い
Zhaoxinは、独自の命令セット体系「ZX86」を長年にわたって開発してきました[1]。x86との互換性を保ちながら独自の知的財産として整備を進めており、PC・組み込み向けの「開先(KaiXian)」と、サーバー向けの「開胜(KaiSheng)」という2つの製品系列を展開しています[1]。AIPCやノートパソコン、デスクトップ、サーバー、IoT向けまで幅広くカバーし、行政・金融・教育・エネルギー・医療といった分野で量産採用が進んでいるとされます[1]。
今回の提携では、このZX86 CPUと東方算芯の3D近メモリAIチップを組み合わせた「ZX86 CPU+3D近メモリAIチップ」の双チップアーキテクチャを掲げます[1]。汎用計算はZhaoxinのCPUが、AIの学習・推論は東方算芯のAIチップが担う役割分担で、海外の最先端プロセスに依存しない国産の計算基盤を築くことを目標としています[1]。
東方算芯は「一世代を量産し、次世代を開発し、その先を先行研究する」という段階的な製品戦略を示しています[2]。後継となるDF2000を2026年第4四半期に、さらにDF3000を2027年第4四半期に投入し、それぞれ前世代から各種の性能を倍増させる計画だとしています[2]。
まとめ
ZhaoxinのZX86 CPUと東方算芯のDF1000を組み合わせる今回の提携は、汎用計算と大規模AI演算の双方を国産技術でまかなおうとする試みです。14nmという成熟プロセスのまま3D近メモリ演算で性能を引き上げ、HBMや先端プロセスへの依存を避ける設計思想が特徴と言えます。計画通りに後継チップまで進むか、実際の運用で性能を発揮できるかが今後の焦点になります。
出典: https://www.zhaoxin.com/news_view.aspx?nid=2&typeid=289&id=2053
出典: https://finance.sina.cn/stock/jdts/2026-07-13/detail-inihsisv4251366.d.html