中国x86兼容处理器厂商兆芯(Zhaoxin)公布了与上海AI芯片企业东方算芯的产业合作。通过把东方算芯于2026年7月13日发布的国内首颗"软件定义、近存计算"3D AI芯片DF1000与兆芯自研的ZX86 CPU结合起来,双方推出了从通用计算到AI运算全部由国产技术承担的"双芯"构想。其目标是在不依赖海外尖端制造工艺的前提下,打造高性能的算力底座。
上海亮相的"双芯"构想
7月13日,东方算芯在上海举办DF1000发布活动,首次公开这款芯片[1]。兆芯总经理兼总工程师王惟林受邀出席,并以《上海兆芯 x 东方算芯 共筑上海算力新基座》为题发表演讲[1]。
王惟林把双方的协同定位为AI芯片产业联动创新的重要实践。通过硬件标准化适配与底层软件打通,双方计划深度联动ZX86 CPU与AI算力芯片的技术能力,打通从通用计算到专用AI算力的完整自主产业链[1]。其目标是构建一套适配国内政企与产业生态的一体化算力底座。
DF1000采用的"软件定义+3D近存计算"
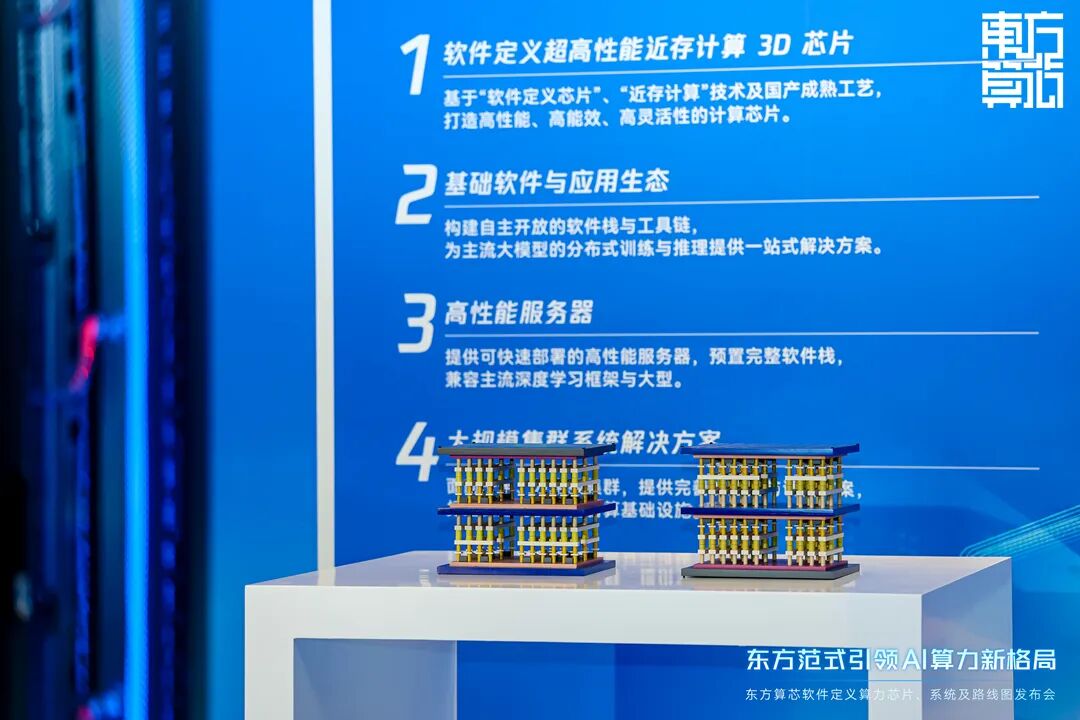
作为此次发布的主角,DF1000是国内首颗把"软件定义"与"近存计算"结合起来的3D AI芯片[1]。近存计算是指把执行运算的逻辑层与保存数据的存储层垂直堆叠,缩短两者之间的距离,从而加快数据搬运的一种技术手段。DF1000通过3D混合键合(以极其精细的键合把多颗芯片贴合在一起的技术)把存储晶圆与逻辑晶圆堆叠起来,将互连间距从数十微米压缩到亚微米级别[2]。
在性能方面,该芯片在采用国产成熟14nm制程的同时,实现了BF16精度下520TFLOPS的算力,访存带宽达到6.4TB/s,用于把多颗芯片互联的Scale-up带宽达到900GB/s[1][2]。东方算芯表示,这一设计破解了算力系统长期面临的"存储墙""带宽墙""功耗墙"三大瓶颈[2]。该公司称,在不使用传统HBM(高带宽内存)的情况下,同等容量下可获得HBM 5倍以上的带宽,并且DF1000已完成完整流片验证,还在128卡规模的集群上实现了稳定运行[2]。
ZX86的积累与不依赖尖端制程的目标
兆芯多年来持续研发自主指令集体系"ZX86"[1]。在保持与x86兼容的同时,兆芯将其打造为自主知识产权,并推出面向PC与嵌入式的"开先(KaiXian)"以及面向服务器的"开胜(KaiSheng)"两大产品系列[1]。其覆盖范围涵盖AIPC、笔记本电脑、台式机、服务器以及物联网设备,并在政务、金融、教育、能源、医疗等领域实现规模化采用[1]。
此次合作以把ZX86 CPU与东方算芯芯片结合的"ZX86 CPU+3D近存AI芯片"双芯架构为核心[1]。在这种分工下,由兆芯的CPU负责通用计算,由东方算芯的AI芯片负责AI训练与推理,目标是构建一套不依赖海外最先进工艺的国产算力底座[1]。
东方算芯提出了"量产一代、研发一代、预研一代"的分阶段产品策略[2]。该公司计划在2026年第四季度推出后继产品DF2000,并在2027年第四季度推出DF3000,二者相较上一代在各项性能上大致翻倍[2]。
总结
把兆芯的ZX86 CPU与东方算芯的DF1000结合起来,这次合作是一次试图以国产技术同时承担通用计算与大规模AI运算的尝试。其核心思路是在保持14nm成熟制程的前提下,通过3D近存计算提升性能,避免对HBM与尖端制程的依赖。后续能否按计划推进到迭代芯片,以及能否在实际部署中发挥性能,将是今后的关注焦点。
来源: https://www.zhaoxin.com/news_view.aspx?nid=2&typeid=289&id=2053
来源: https://finance.sina.cn/stock/jdts/2026-07-13/detail-inihsisv4251366.d.html