理化学研究所、Cleveland Clinic 与 IBM 组成的联合团队,凭借用量子计算机计算 12,635 个原子的蛋白质复合物这一成果,入围 2026 年 ACM 戈登贝尔奖决选名单。这被称为迄今用量子计算处理过的、具有生物学意义的最大规模分子。获奖结果将在 11 月的 SC26 上公布。
12,635 个原子是怎么来的
这次的计算对象是 T4 溶菌酶和胰蛋白酶两种蛋白质。前者是分解细菌膜成分的酶,后者由胰腺产生并参与消化,都是生物化学教科书里的经典分子。
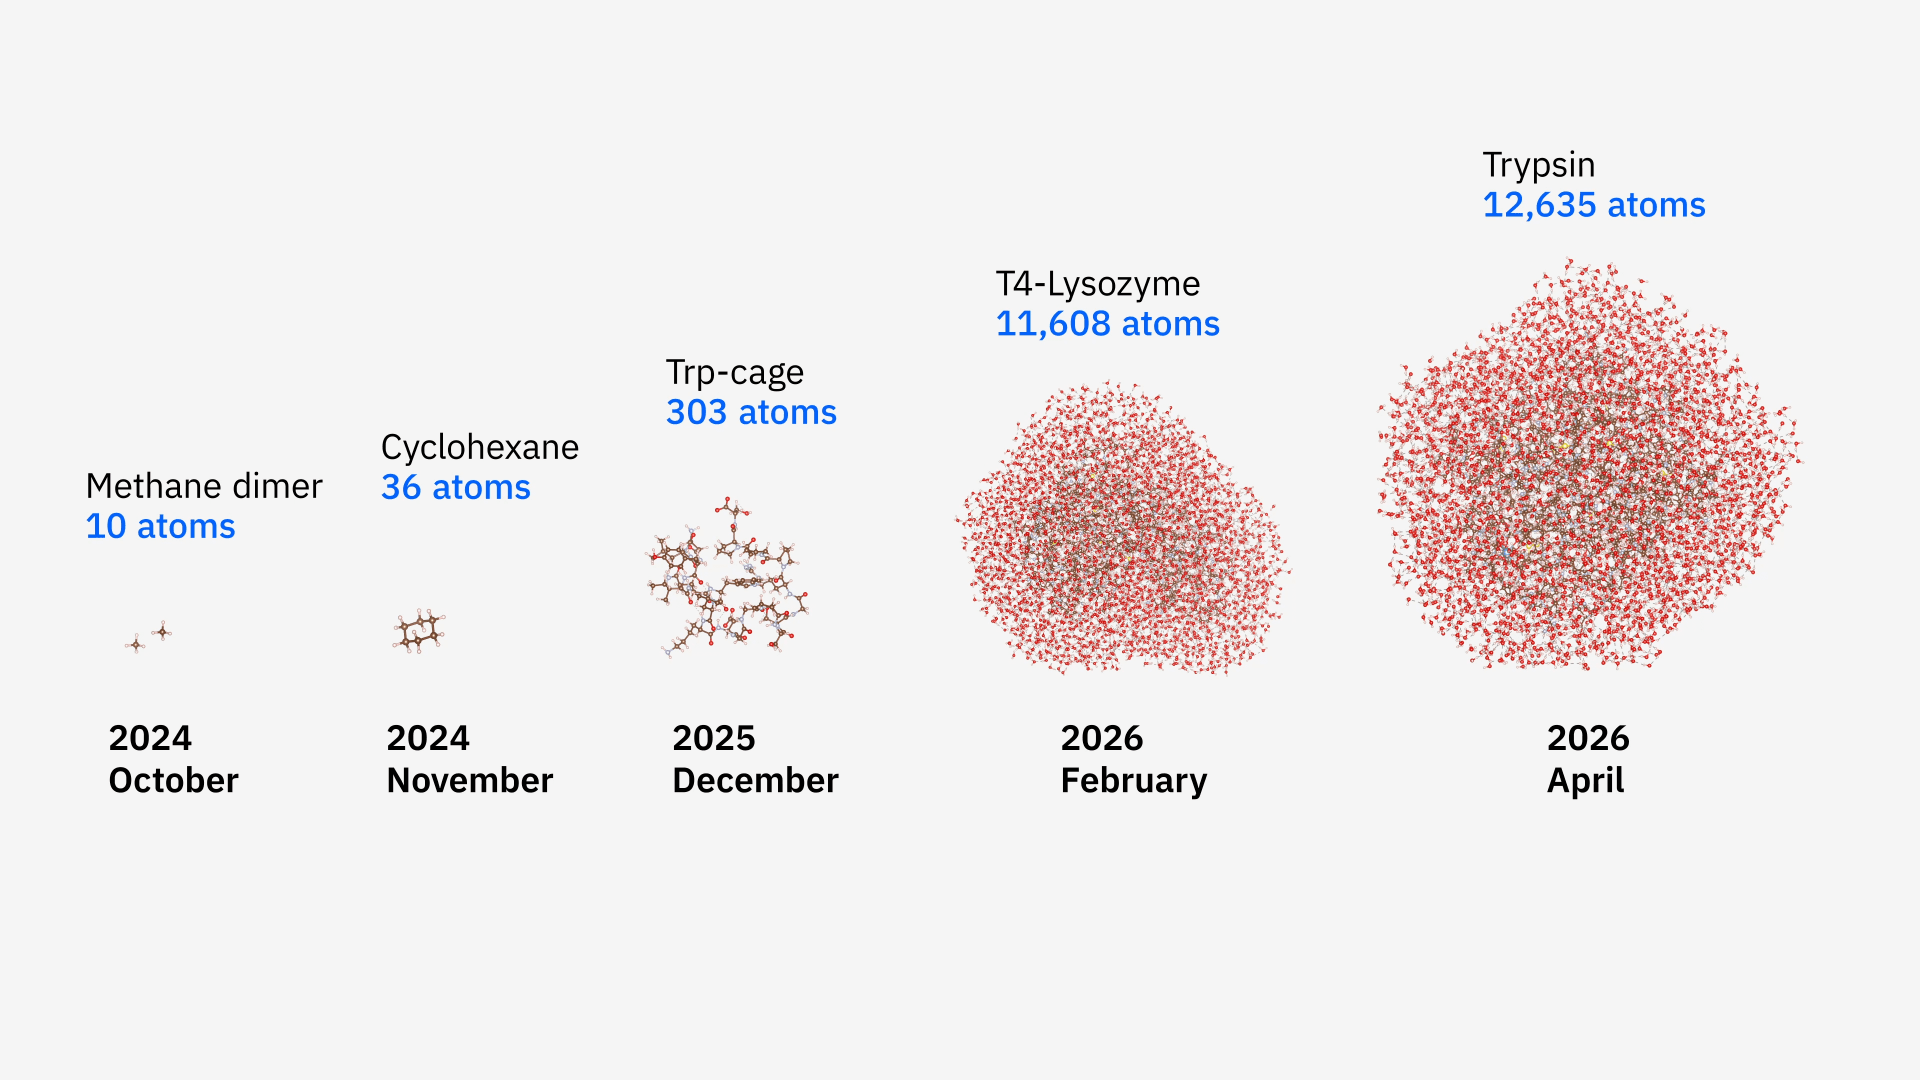
这次计算的特别之处在于,蛋白质并非孤立地悬在真空中,而是与它在自然界中实际结合的分子(配体)配成一组,并且置于液态水的环境中。在这样的条件下,T4 溶菌酶的体系达到 11,608 个原子,胰蛋白酶达到 12,635 个原子。也就是说,电子结构是在更接近体内真实情况的状态下算出来的。
作为对照的是同一团队不久前处理过的 303 个原子的迷你蛋白 Trp-cage。相比之下,体系规模扩大约 40 倍,在工作流程的某个特定环节上精度提高了 210 倍。量子计算在化学领域的应用,在很短的时间里完成了两个数量级的跨越。
让量子与经典分工的思路
所采用的框架被称为以量子为中心的超级计算(QCSC)。它并不是让量子计算机独自解出整个大分子,而是把计算拆成一个个较小的团簇:简单的部分交给经典计算机,只有电子纠缠过强、经典方法难以处理的部分才交给量子计算机,最后再由经典一侧把分子重新拼接起来。
拆分分子的步骤本身也做了改进。按照传统方法,分子尺寸翻一倍,所需的经典计算资源就会膨胀到 25 倍,因此在胰蛋白酶这样的规模上,拆分本身就无法执行。团队利用了一个性质:距离超过 7 到 10 埃以外的信息在量子力学层面几乎不产生影响,于是把计算范围收缩到以每个原子为中心的球体内部。
量子一侧的方法也有更新。在原有的基于采样的量子对角化(SQD)之上,团队引入了名为 TrimSQD 的方式,先把搜索空间切分成多个子空间再逐一考察,从而更容易找出值得交给量子计算机处理的电子构型。
156 量子比特的 Heron 与富岳、Miyabi-G
硬件配置同样是这项研究的看点。量子采样由两台 156 量子比特的 IBM Quantum Heron r2 处理器分担,一台设在 Cleveland Clinic,另一台设在理化学研究所,也就是把美国和日本的量子计算机同时用在一次计算里。实际使用的量子比特最多为 94 个,运行了 9,200 条线路、耗时超过 100 小时,收集到 13 亿次测量结果。
量子计算机返回的子空间对角化则由两台经典超级计算机承担:理化学研究所的富岳,以及由东京大学和筑波大学运营的 GPU 机型 Miyabi-G。QPU(量子处理器)、CPU 与 GPU 各自承担擅长的环节,可以看出量子计算正在被纳入更大的计算平台,而不再是孤立的一台设备。
需要说明的是,这套方法目前并未超越最好的经典方法。IBM 也明确指出了这一点,并把成果定位为:量子计算机已经成为今天的科学研究中真正可用的工具。
9 月的追加成果:取消了人工数据传输
针对 5 月公开的最初结果,9 月又发布了后续进展。表示分子之间结合紧密程度的结合能,其计算精度进一步提高。在创新药研发的语境下,能否预测候选化合物与目标蛋白结合的强度是关键问题,因此这里的精度直接关系到实用价值。
另一项进展是在理化学研究所新的 GPU 超算 ROQUO 上验证了整套工作流程。此前在量子机与经典机之间仍保留着人工交接数据的环节,通过把 CPU、GPU、QPU 统一编排,这道人工工序被取消,传输带来的错误和等待时间都随之减少。这是一项不起眼但分量很重的改进,让流程更接近研究人员可以直接使用的状态。
领导这项研究的 Cleveland Clinic 的 Kenneth Merz 把这个结果形容为梦寐以求的事情。此次开发的方法据称可以直接移植到 IBM 计划于 2029 年推出的容错量子计算机 IBM Quantum Starling 上,因此即便硬件换代,积累也不会白费。
总结
单看 12,635 这个数字,容易被当成规模竞赛,但其内核是如何在量子与经典之间分配任务的设计问题。日本一侧由理化学研究所的富岳与 ROQUO、以及东京大学和筑波大学的 Miyabi-G 承担了计算的主要部分,这项工作同时也是 NEDO 与日本经济产业省量子与超算协同项目的成果。能否获奖,将在 11 月 15 日至 20 日于芝加哥举行的 SC26 上揭晓。