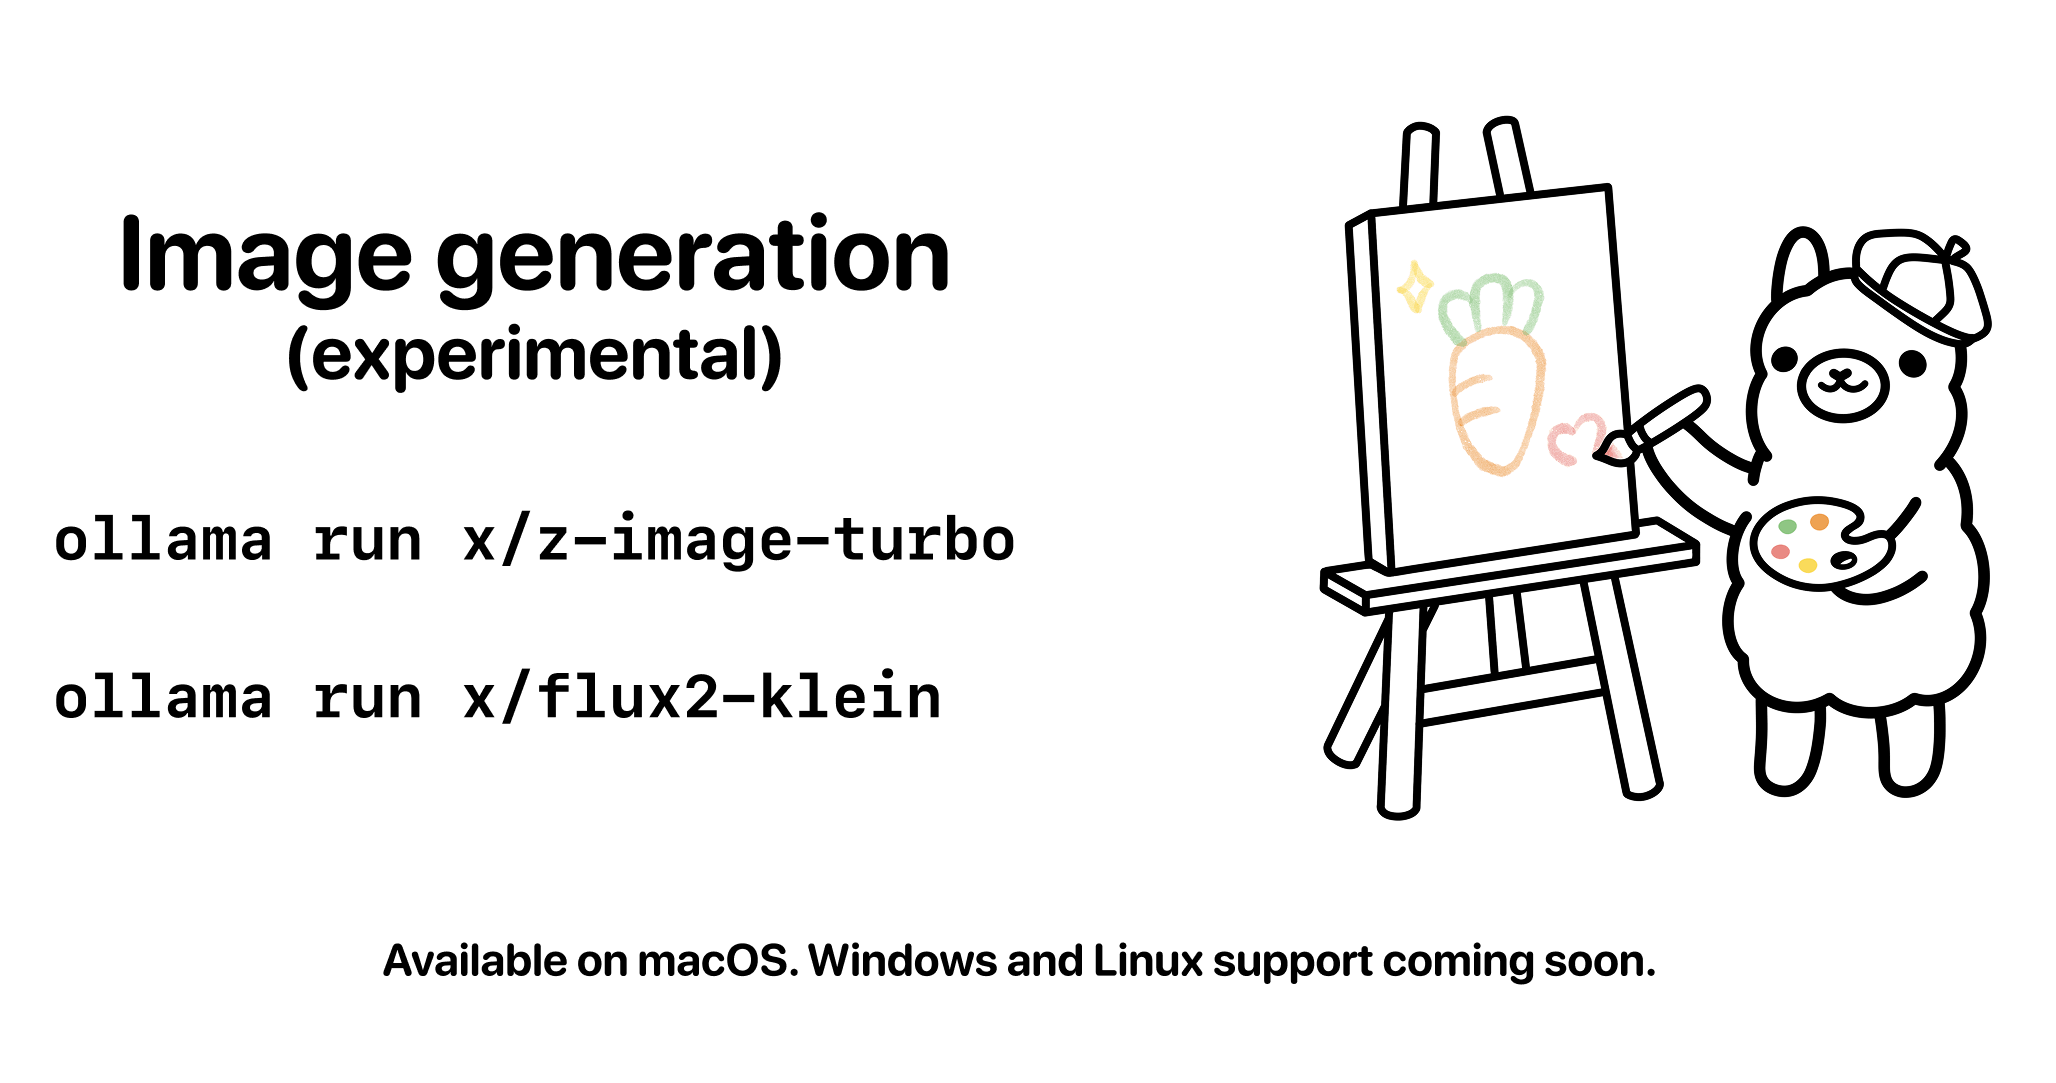
用於在本機執行大型語言模型(LLM)的工具「Ollama」開始實驗性支援依文字生成圖像的功能[1]。此功能率先提供給 macOS,對 Windows 與 Linux 的支援也即將到來[1]。它內建了由阿里巴巴通義實驗室(Tongyi Lab)開發的「Z-Image Turbo」,以及 Black Forest Labs 的「FLUX.2 Klein」兩款模型,都能僅在本機上執行[1]。對於不想完全仰賴雲端服務的使用者而言,把圖像生成整個流程留在本機完成的選擇變多了。
在終端機即可完成、率先登陸 Mac 的圖像生成
Ollama 的圖像生成和以往的對話模型一樣,只要在終端機輸入一道指令即可呼叫[1]。用法是在模型名稱後面附上提示詞(指示文字)再執行[1]。
ollama run x/z-image-turbo "your prompt"
生成的圖像會儲存到目前所在的目錄(資料夾)中[1]。此外,支援圖像顯示的終端機可以就地預覽已儲存的圖像,具體列舉的對象包括 Ghostty 與 iTerm2 等終端機[1]。從生成到檢視都能在同一個畫面內完成,不必另外開啟檢視器。
目前支援的系統僅有 macOS,Windows 與 Linux 則標示為「即將支援」[1]。由於處理整個流程都在本機的 Mac 上完成,輸入的提示詞與生成的圖像無須傳送到外部伺服器,這在顧慮隱私或網路環境的情境下是一項優勢。
內建模型「Z-Image Turbo」與「FLUX.2 Klein」
這次的實驗性支援準備了兩款圖像生成模型[1]。
第一款是「Z-Image Turbo」。它由阿里巴巴通義實驗室打造,是一款 60 億參數(表示模型規模的數值)的文字轉圖像模型,擅長生成寫實風格的圖像[1]。它還能在圖像中準確地呈現英文與中文兩種文字[1]。其授權為 Apache 2.0,公開了權重(訓練完成的資料),並允許商業使用[1]。執行指令如下[1]。
ollama run x/z-image-turbo
第二款是「FLUX.2 Klein」。它被定位為 Black Forest Labs 迄今最快的圖像生成模型,提供 40 億(4B)與 90 億(9B)兩種參數規模[1]。它擅長在圖像中呈現清晰易讀的文字,適合用於 UI 原型(介面草圖)以及含有文字的設計[1]。授權依規模而異:4B 模型採用可商用的 Apache 2.0,9B 模型則適用「FLUX Non-Commercial License v2.1」這項非商業授權[1]。執行指令如下[1]。
ollama run x/flux2-klein
兩款模型可依用途分別選用。追求寫實照片風格可選 Z-Image Turbo,需要含有文字的設計用途則可選 FLUX.2 Klein。
透過設定項目細緻調整生成
Ollama 的圖像生成可以透過指定幾項參數來調整結果[1]。
儲存位置預設為目前目錄,但只要在終端機切換目標目錄,儲存位置也會隨之改變[1]。圖像尺寸可用「/set width」「/set height」指令指定寬度與高度,圖像越小生成越快,佔用的記憶體也越少[1]。
左右生成品質與速度的是步數[1]。這個數值指模型內部反覆處理的次數,步數少則快但細節較粗糙,反之過多有時會出現多餘的瑕疵(artifact)[1]。Ollama 會為每款模型預先設定建議的預設值[1]。
此外,還可以指定用於重現相同結果的種子值(亂數種子),以及用來說明不希望圖像中出現哪些元素的負面提示詞[1]。固定種子值之後,就能從相同的提示詞再次得到相同的圖像,這在逐步打磨構圖或分享生成結果時相當實用[1]。
後續規劃
關於今後的安排,Ollama 列出了對 Windows 與 Linux 的支援,以及新增圖像生成模型與圖像編輯功能[1]。目前它仍屬於實驗性定位,但在本就能於本機完成從對話到程式碼生成的 Ollama 上再加入圖像生成,單一本機所能負擔的 AI 用途看來會進一步擴大。
總結
Ollama 實驗性支援了依文字生成圖像,並率先在 macOS 上可用。它內建了阿里巴巴通義實驗室、擅長寫實表現的「Z-Image Turbo」,以及 Black Forest Labs、擅長文字呈現的「FLUX.2 Klein」兩款模型,兩者都只需一道終端機指令即可執行。儲存位置、尺寸、步數、種子值、負面提示詞等調整項目也一應俱全,讓人能在不向雲端傳送資料的前提下,僅在本機試用圖像生成。對 Windows 與 Linux 的支援以及圖像編輯功能也已預告,後續的擴充值得關注。