NVIDIA 在官方部落格上,提出面向代理 AI 時代的新標尺——「每美元智慧(intelligence per dollar)」[1]。該公司認為,AI 已不再是訓練一次就結束,而是進入以「後訓練(post-training)」為主角的時代,也就是在運作中持續打磨模型能力的階段。NVIDIA 將新平台「Vera Rubin」定位為能高效承接這種持續負載的基礎設施,宣稱可用上一代四分之一的 GPU 數量訓練最大規模的模型,從根本重新檢視 AI 基礎設施的成本結構。
後訓練從「一次性」轉為「不停循環」的工序
NVIDIA 以職業運動員來比喻。真正拉開頂尖選手差距的,是比賽與比賽之間發生的事:持續修正、根據上一場暴露的問題調整並磨練技藝。代理 AI 也是如此[1]。與只針對提示作出回應的生成式模型不同,代理被賦予一個目標,必須在環境變化、工具更替與意外狀況中自行規劃,並在執行途中的失敗裡重新站起來。
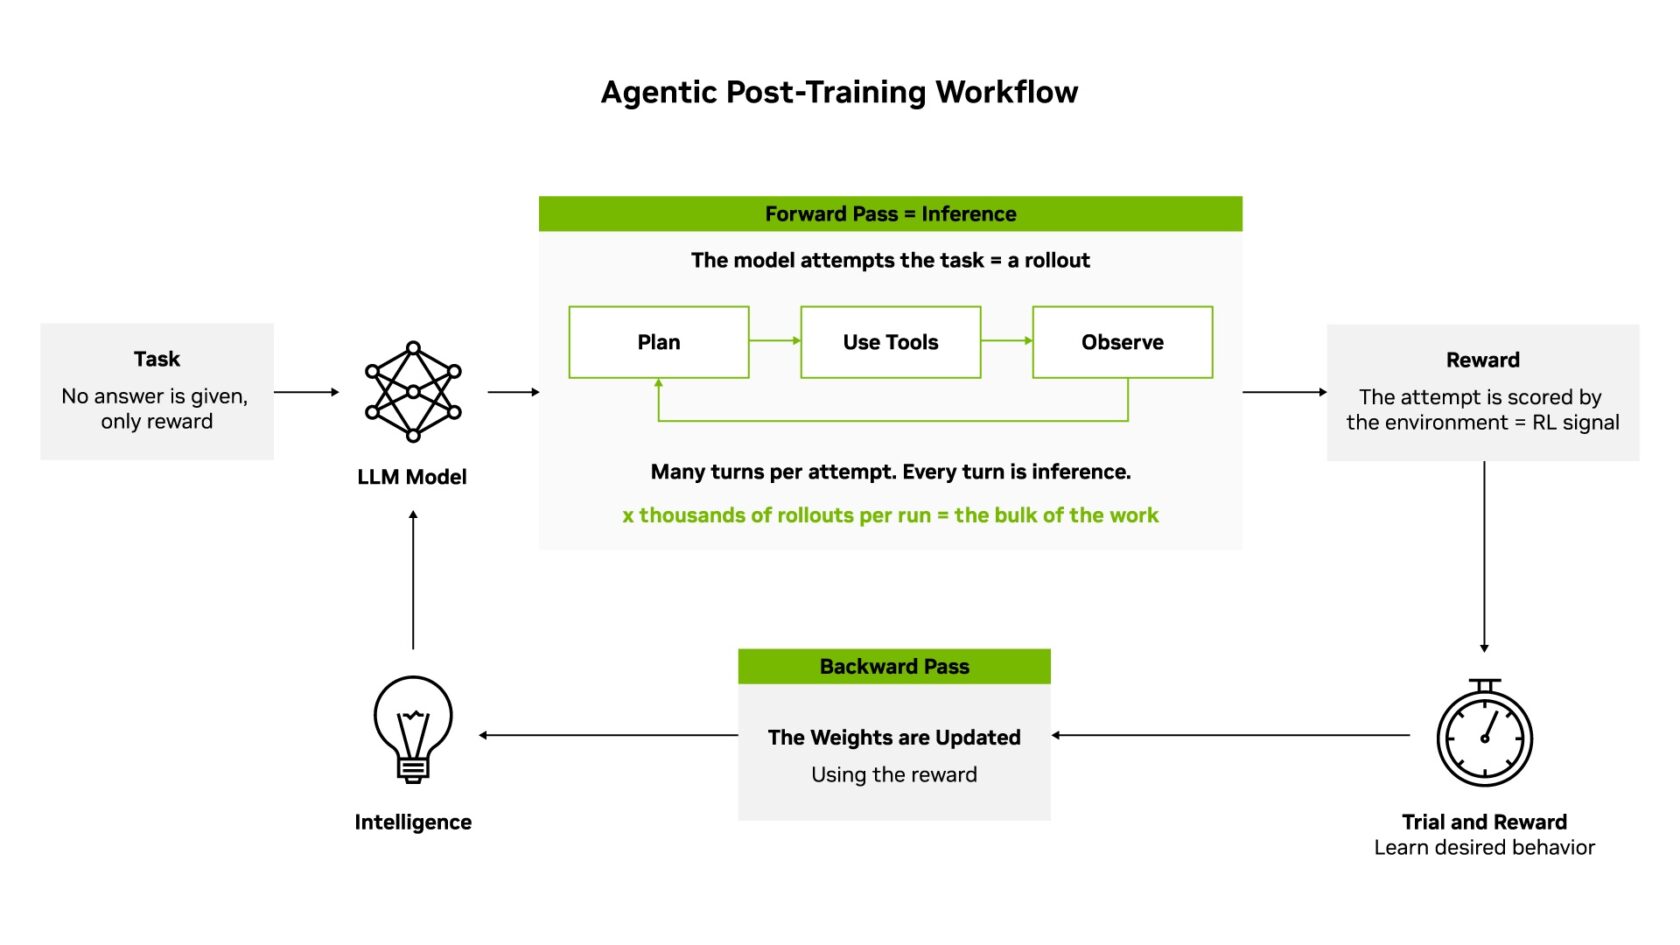
正因如此,在初始訓練之後打磨模型的「後訓練」,已不再是一次性的收尾步驟。代理所用的工具可能每週都在變,正式環境中會不斷浮現測試集未曾預料的邊際案例。訓練會從正式環境不斷循環回流,運算負載成長並非因為單次執行更大,而是因為執行永不停止。NVIDIA 將其稱為代理時代的核心工作負載[1]。
「每美元智慧」這把新標尺
後訓練的目標,是讓學習循環中每一次前向處理(推論)與反向處理(權重更新)的收益最大化,提高每投入一美元所換得的智慧。「每美元智慧」正是在此登場[1]。
NVIDIA 把這項指標放在大家熟悉的「每權杖成本(cost per token)」之上一層。每權杖成本衡量的是營運效率,也就是交付 100 萬個權杖需要多少成本;而每美元智慧追問的是:打造一個值得提供服務的模型、並隨環境變化讓它持續保有價值,需要多少成本。兩者不是競爭而是巢狀關係——降低每權杖成本的基礎設施,也會同時降低植入模型的每一單位智慧的成本[1]。
作為具體例子,NVIDIA 提到開放權重、具備 5,500 億參數的模型「Nemotron 3 Ultra」。它公開了完整的訓練流程,並在評估真實軟體缺陷修復的標準基準「SWE-bench verified」取得 71.7%,在開源的真實缺陷中,大約每 10 個就有 7 個生成了能通過專案自身測試的修復[1][2]。
Vera Rubin 訓練頂級模型只需四分之一 GPU
為了讓這種持續後訓練在經濟上可行,NVIDIA 表示現有的「Blackwell」平台降低了單次執行成本,使頻繁的後訓練變得可行。而下一代「Vera Rubin」進一步推動這股趨勢,能以 Blackwell 世代四分之一的 GPU 數量訓練最大規模的模型[1]。
Vera Rubin 針對代理的持續學習進行端到端的協同設計,目標是在單次執行中跑更多的嘗試(rollout)、同時運行更多環境,並支撐永不停止的後訓練循環。
實際開發現場中的運用
NVIDIA 也介紹了多個採用案例。持續對前沿開放模型進行後訓練的 Prime Intellect,目前在 Blackwell 上跑訓練,並計畫在 Vera Rubin 上擴展強化學習環境、在單次執行中生成更多嘗試。該公司在檢驗真實強化學習負載時發現,Vera CPU 相較於 x86 架構,平均每 CPU 的吞吐量高出 30%[1]。
搜尋 AI 公司 Perplexity 在數百顆 NVIDIA GPU 上非同步執行強化學習後訓練。透過以 RDMA 為基礎的權重傳輸機制,可在訓練端與推論端節點之間,以不到 2 秒的時間同步兆級參數規模的模型,並把如此完成後訓練的「Qwen3 235B」模型部署在「GB200 NVL72」系統上運行[1]。
將後訓練當成服務提供的 Together AI,也透過 API 提供監督式微調、強化學習與偏好最佳化等一整套工序,並期待下一步用上 Vera Rubin。NVIDIA 強調,面向訓練環境的「NeMo Gym」與面向分散式後訓練的「NeMo RL」等開放函式庫,能把這類工作從研究者專屬的客製程式,轉變為可重複運用的基礎設施[1]。
總結
NVIDIA 此次提出的「每美元智慧」,把 AI 的評價維度從「單次推論有多便宜」,擴展到「打造聰明的模型並讓它保持聰明的成本」。後訓練越是變成不停的循環,運算負載就越持續攀升,而 Vera Rubin 據稱能以 Blackwell 世代四分之一的 GPU 完成這一切。包括 Prime Intellect 與 Perplexity 等現場數值能在多大範圍內普遍重現,這都顯示代理時代的基礎設施競爭,正連同衡量成本的標尺一起改變。
出典:https://blogs.nvidia.com/blog/nvidia-vera-rubin-post-training-intelligence-per-dollar/