

在 Microsoft Build 大會上,NVIDIA 與微軟宣布擴大合作,將執行 AI 代理所需的各項要素一次整合到位[1]。NVIDIA 創辦人暨執行長黃仁勳透過直播從台北參與了 Satya Nadella 的主題演講,展示了貫通 Windows 裝置、Azure 雲端到本機環境的統一技術堆疊[1]。本次合作的重點,是在 Microsoft Foundry 上提供 NVIDIA 的開放模型,以及將安全的執行環境整合進開發工具 GitHub Copilot[1]。
Microsoft Build 上揭示的合作全貌
NVIDIA 認為,AI 代理光靠優秀的模型還不夠,還需要高速的硬體、安全的執行環境(執行階段)、反應迅速的資料層,以及為長時間推論(已訓練的 AI 實際導出答案的處理)而調校的模型,四者齊備才能成立[1]。本次擴大合作的目標,是讓開發者無論在 Windows 裝置、Azure 雲端還是本機,都能用上這 4 項要素[1]。
主題演講提到的具體主題,包括面向 Windows 的 RTX Spark 與 DGX Station for Windows、以 GPU 加速的 Microsoft Fabric、在 Microsoft Foundry 上提供 NVIDIA 開放模型、將 NVIDIA OpenShell 整合進 GitHub Copilot,以及次世代的 AI 工廠[1]。其中,企業與開發者能立即上手的雲端建置進展最為明顯[1]。
NVIDIA 的開放模型登上 Microsoft Foundry
在 Microsoft Foundry 的代理服務中,除了 NVIDIA、Anthropic、OpenAI 的模型外,還能使用針對特定任務的「Hermes special agents」,企業可在 Azure 上建立內建身分驗證與治理(管理控管)的代理[1]。Anthropic 的 Claude 已能在 Azure 上的 NVIDIA GB300 Blackwell Ultra 系統原生執行,預計數週內開放給客戶[1]。
NVIDIA 將於本月在 Foundry 的受管運算上,提供面向程式設計、研究、業務處理等長時間執行代理的全新開放推論模型「Nemotron 3 Ultra」[1]。同時也推出面向語音辨識的「Nemotron 3.5 ASR」與用於安全判定的「Nemotron 3.5 Content Safety」[1]。開發者可以將 Nemotron 與前沿模型、本機模型組合,依每項處理最佳化成本與品質[1]。
開放模型的範圍也延伸到實體 AI 與科學領域[1]。面向實體 AI 的全面開放模型「Cosmos 3」,以及可用於企業預測與風險分析的 AI 氣象模型「Earth-2」,透過 Foundry 等管道提供[1]。此外還提供用於建構正式環境代理的開源基礎「NVIDIA Agent Toolkit」與「NemoClaw」藍圖(設計圖),讓代理能把 cuDF、cuOpt、AI-Q、NeMo 等 CUDA-X 函式庫當作專用技能呼叫[1]。
GitHub Copilot 獲得安全執行環境「OpenShell」
隨著代理從程式設計輔助走向自主執行,就需要在不交出真實權限的前提下完成實際工作的機制[1]。NVIDIA 將因應此課題的執行環境「NVIDIA OpenShell」整合進了 GitHub Copilot[1]。
在 OpenShell 中,每個代理都在隔離的容器(獨立的執行區域)內運作,對外通訊在抵達檔案、網路、憑證之前都會依政策逐一檢查[1]。政策以程式碼撰寫,可在程式碼儲存庫中進行版本控管,並能在執行中更新[1]。OpenShell 採用 Apache 2.0 開源授權,不依賴特定模型,可對應本機、混合與雲端等各類環境[1]。
以 GPU 為 Microsoft Fabric 資料倉儲加速
由於 AI 代理以資料為燃料運作,對資料的高速存取不可或缺[1]。NVIDIA 的加速運算已整合進 Microsoft Fabric 資料倉儲,微軟內部基準測試顯示,在要求高並行的處理中,SQL 執行相較以 CPU 為基準最高快 6 倍,相較其他 3 家主要雲端資料倉儲業者最高快 7 倍[1]。
如此一來,企業的資料層便能跟上持續查詢並推論資料的代理[1]。NVIDIA 表示,這是兩家公司多年合作、從研究到正式運用一以貫之的成果[1]。
從雲端到本機,直至 Windows 裝置
合作也延伸到雲端之外[1]。微軟將讓其本機平台「Azure Local」上的「Foundry Local」支援 NVIDIA RTX PRO 6000 Blackwell Server Edition[1]。與 Nemotron 開放模型組合後,企業可在本機、混合,以及符合各國法規的主權(於本國境內完結)環境等資料所在之處執行高效能 AI 處理[1]。Azure Local 上的 Foundry Local 也新增支援多節點部署與推論基礎「vLLM」[1]。
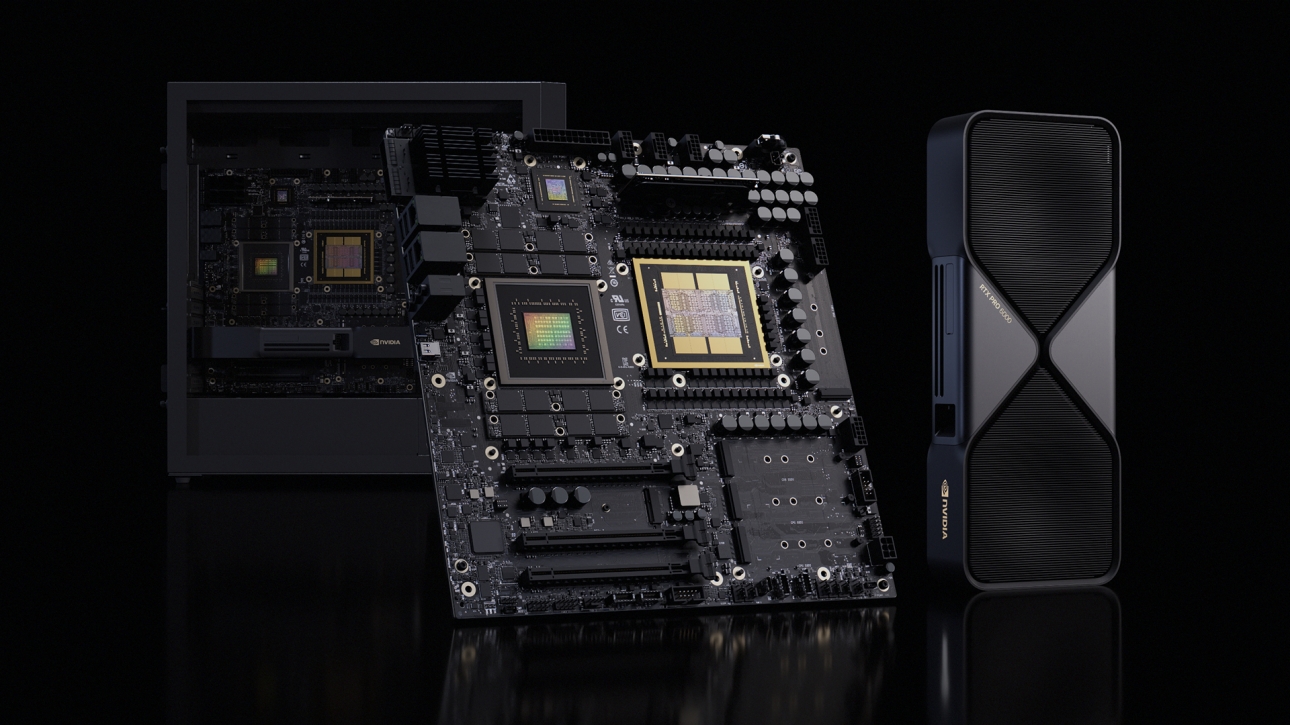
在 Windows 裝置方面,面向個人代理的專用 PC「RTX Spark」與桌邊 AI 超級電腦「DGX Station for Windows」都執行前述的 OpenShell,可在本機安全地執行代理[1]。在實體 AI 領域,微軟為開發機器人、自動駕駛車等,將 NVIDIA 的開源實體 AI 工具整合進 Azure 與「Physical AI Toolchain」[1]。
大規模的基座也開始運轉[1]。微軟的 AI 工廠「Fairwater Wisconsin」提前投入運轉,次世代平台「NVIDIA Vera Rubin」也正式投產[1]。據 NVIDIA 表示,Vera Rubin 可緊鄰 Blackwell 追加部署,將每百萬瓦的推論處理量最高提升 10 倍,並大幅降低代理處理每個 token 的成本[1]。
總結
這次發表可說是一項讓 AI 代理「在哪裡執行都行」的合作。藉由 Microsoft Foundry 上的開放模型,以及整合進 GitHub Copilot 的 OpenShell,開發者無論在雲端還是本機,都更容易建構與營運受到安全管理的代理。再加上 Fabric 的加速與向 Azure Local 的擴展,NVIDIA 與微軟清楚展現出方向:把模型、執行環境、資料與基礎設施各層,從 Windows 到雲端串成一條連續的技術堆疊。
來源:https://blogs.nvidia.com/blog/microsoft-build-windows-local-cloud-devices/



























