阿里巴巴的AI研究團隊Qwen於2026年6月16日發表了用於驅動機器人的基礎模型套件「Qwen-Robot Suite」。此套件由阿里巴巴旗下的通義實驗室開發,包含負責移動至目的地的「Qwen-RobotNav」、負責操控機械手臂的「Qwen-RobotManip」,以及理解周遭環境並預判後續變化的「Qwen-RobotWorld」三款模型。這象徵著AI正從處理文字的聊天機器人,邁向在現實世界中驅動實體的物理AI。
繼語言模型之後,邁向「擁有身體的AI」
在此之前,生成式AI的主戰場一直是處理文字與影像的軟體領域。Qwen-Robot Suite將這項技術帶入物理空間,目標是讓機器人能夠完成「移動」「抓取物體」「理解環境」這三項基本動作。阿里巴巴將其定位為機器在物理世界中行動所需的一整套軟體基礎,其特點在於提供了不綁定於某一台特定機器人的通用底層架構。
三款模型各司其職,但組合使用時可以貫通完成一連串流程,例如「接收指令後移動至目的地,找到目標物並進行操作」。能夠以語言指令作為起點行動,是它與傳統機器人控制的最大差異。
Qwen-RobotNav是引導機器人抵達目的地的導航模型。它以同時處理視覺與語言的Qwen3-VL為基礎,使用1560萬筆資料進行訓練。值得關注的是,它將依指令移動、依指定地點移動、搜尋目標物、追蹤目標以及自動駕駛這五種性質不同的任務,統一由單一模型來承擔。
在衡量效能的基準測試中也給出了具體數字。在貼近真實環境、依語言指令移動的VLN-CE RxR測試中,它取得了76.5%的成功率;在評估持續追蹤目標能力的EVT-Bench測試中,達到了90%的追蹤精度。這是一款即使身處初次造訪的場所,也力求能夠依照自然語言指令行動的模型。
Qwen-RobotManip 跨越結構不同的機械手臂進行操控
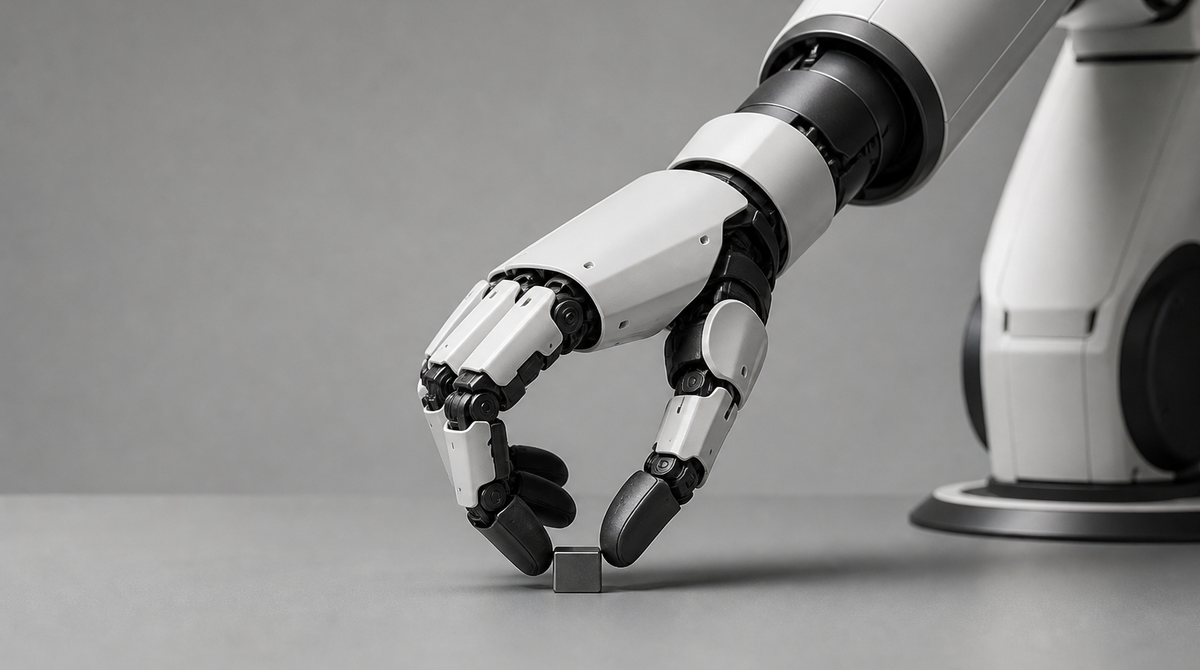
Qwen-RobotManip是負責以機械手臂抓取與移動物體的模型。它以Qwen3.5-4B為底層,結合公開的機器人資料集與人類作業影片,使用約3萬8100小時的資料進行訓練。不依賴僅靠自家機體蒐集的專用資料,而是運用廣泛流通的資料來達成規模化,是其在開發上的一處巧思。
機械手臂會因廠商與產品不同,在關節數量、手臂長度以及驅動方式上各有差異。這種機型之間的差異,一直是重複運用同一操作模型的障礙。Qwen-RobotManip的設計可以跨越結構不同的機械手臂,在評估桌面作業的RoboChallenge Table30-v1中位居首位,據說較以往的方法提升了20%。
Qwen-RobotWorld 行動之前先預判「接下來會如何」
三款模型中最具挑戰性的,是擔任世界模型的Qwen-RobotWorld。它會在機器人實際開始動作之前,對「這個環境接下來會如何變化」進行模擬與預測。它藉由視覺語言模型以語言描述周遭環境,並能夠跨越移動、駕駛、操作等場景,預見在物理上合乎邏輯的未來走向。
應用範例包括:根據人手作業的影片生成機械手臂的動作,以及從一條指令出發,生成在時間與空間兩方面都保持一致的多角度影片。能夠事先在腦海中描繪出行動的結果,是安全且高效地驅動物理AI的重要基礎。
先面向企業試營運提供,中國廠商的物理AI競爭加速
Qwen-Robot Suite目前處於透過阿里雲面向部分企業客戶的試營運提供階段。阿里巴巴希望讓這三款模型成為各類機器人可以共用的底層架構,有報導將此舉評價為意在打造「機器人領域的Android」。在語言模型上一路領先的中國大型科技企業,似乎也在現實世界中驅動實體的機器人領域持續增強存在感。
面向機器人的基礎模型,是全球企業與研究機構競相開發的領域。由一家公司將移動、操作、預測這些主要功能一併呈現,意義不容小覷。接下來值得關注的,是相容的機器人與實際導入案例今後能擴展到何種程度。
總結
2026年6月16日,阿里巴巴旗下的Qwen發表了面向機器人的基礎模型套件「Qwen-Robot Suite」。它由負責移動的Qwen-RobotNav、負責機械手臂操作的Qwen-RobotManip,以及負責預測的世界模型Qwen-RobotWorld三大支柱構成,力求貫通完成從語言指令到一連串動作的整個過程。各模型也給出了具體的基準成績,目前正透過阿里雲面向企業試營運提供。這是一則象徵AI主戰場正從聊天機器人轉向現實世界的發表。