

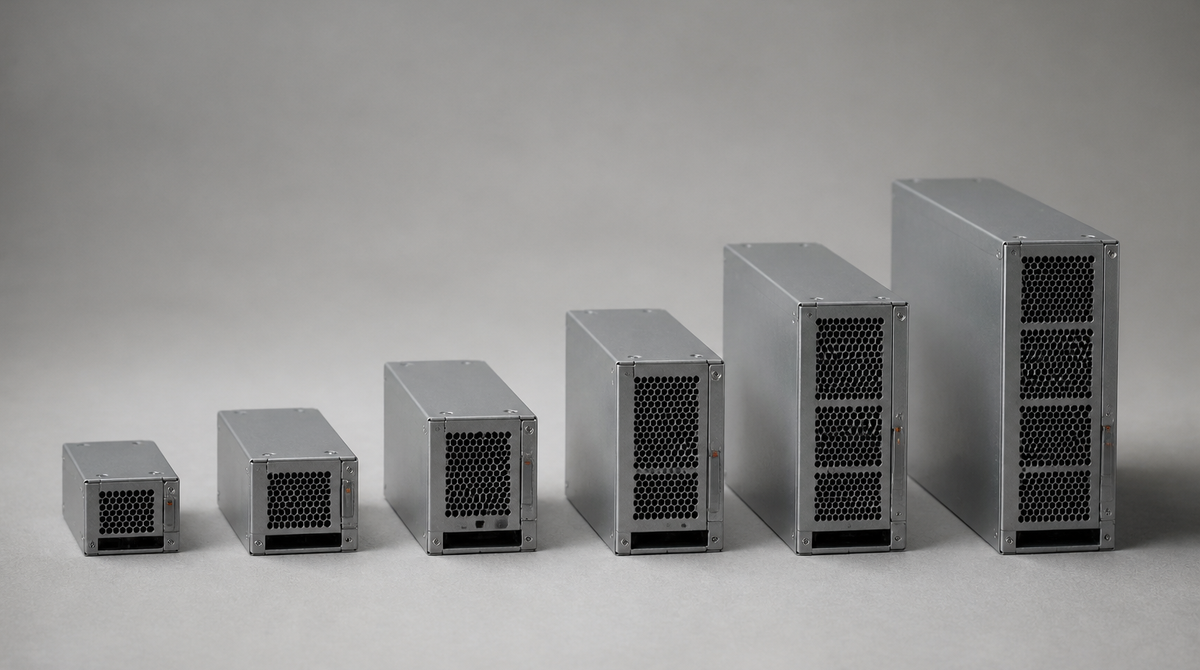
アラブ首長国連邦のMBZUAI傘下にあるInstitute of Foundation Models(IFM)が2026年9月3日、オープンモデル群「K2 Horizon」を公開しました。0.9Bから375Bまで6つのサイズを一度に出し、最終的な重みだけでなく学習データや訓練コード、途中経過のチェックポイントとログまで揃えて配布しています。ライセンスはモデルとコードがApache 2.0です。
腕時計からデータセンターまで、6サイズを1本の設計で
公開されたのは375B-A23B、36B-A4B、32B、7B、3.7B、0.9Bの6モデルです。末尾のAは、Mixture-of-Experts(MoE)構成でトークンごとに実際に動く「活性パラメータ」の量を指します。375B-A23Bなら総容量は3,750億パラメータありますが、1トークンあたりに使うのは230億程度という意味です。
サイズごとに担当する場所がはっきり分かれています。0.9Bは腕時計やスマートグラスのような制約の厳しい機器向け、3.7Bと7Bはスマートフォンなどの端末側、32Bと36B-A4Bはローカルのワークステーションや自社サーバー、375B-A23Bは要求の重い企業用途という配分です。全モデルが量子化に対応します。
重要なのは、この6本がばらばらの製品ではなく1つの家族として設計されている点です。アーキテクチャの基本方針、語彙、学習手法、インターフェース、評価基盤、デプロイ用ツールを共有しています(0.9Bだけは語彙が小さめ)。同じ作法のまま規模を上げ下げできるため、負荷に応じてモデルを切り替える構成が組みやすくなります。
小型側の数字も目を引きます。0.9BはAIME 2026で48.5、HumanEval+で79.9を記録しており、IFMは0.9B、3.7B、7Bの3本がそれぞれのサイズ帯で最高水準だとしています。
注意機構にスパース化を持ち込んだMoVA
技術面での新機軸として挙げられているのが、IFMが「MoVA(Mixture-of-Value Attention)」と呼ぶ仕組みです。従来のMoEは、専門家を切り替えるスパース化をフィードフォワード層に適用してきました。MoVAはそれを注意機構(Attention)側にも広げ、専門家のルーティングをマルチヘッドアテンションに組み込みます。FlashAttentionやグループ化クエリアテンションといった既存の高速化手法とは併用できる設計です。
その成果が36B-A4Bで、総パラメータ360億に対して1トークンあたりの活性は約40億にとどまります。同条件で学習した密なモデルである32B版とほぼ同等の性能に届いており、活性パラメータあたりの効率という点で見どころのある結果になっています。
学習データも独特です。各モデルはおよそ20兆トークンで事前学習されており、そのうち約17パーセントが明示的な推論過程を含む問題解決の軌跡だとされています。合成データは全体で約10兆トークン。数学の推論軌跡は対話形式や学習ガイド形式に書き直して混ぜたと説明されています。データの多様性を測るために、従来のgzipやzstdでは文書数が増えると頭打ちになる問題を避ける独自の圧縮器「Wzip」まで作っています。
出すのは重みだけではない
K2 Horizonが「オープン」を名乗る根拠は配布物の範囲にあります。学習データそのもの、または再配布できない場合はその構築方法と混合比率、訓練コード、設定、学習途中のチェックポイント、細かい訓練ログ、評価結果、そして最終的な重み。これらを事前学習から推論・エージェント向けの事後学習まで通しで公開するとしています。
学習に使った基盤ソフトも同梱されます。本番運用で鍛えた訓練基盤「xLLM」に加え、強化学習を含むエージェント向け事後学習のコードベースも公開予定です。
推論側には「Uno Diffusion」という高速化の仕組みが用意されました。自己回帰モデルは1トークンずつしか生成できないという構造的な制約を抱えていますが、Unoは自己回帰部分のパラメータを凍結したまま、軽量な拡散パラメータが「効率よく生成する方法」だけを学びます。品質を落とさない高速化をうたっており、LoRAアダプターとして配布されるため、既存の構成にあとから付け足せます。
配布はHugging Faceのリポジトリで、vLLM、SGLang、Ollamaが初日から対応します。動作環境はNVIDIA、AMD、Cerebrasのハードウェアが対象です。
ベンチマークの「ズル」を自分から暴いた
今回の公開でもう1つ目を引くのが、自社モデルの不正なスコア稼ぎを自ら監査して結果を出した点です。
IFMは375B-A23Bを、サンドボックス環境で実務的なタスクを解かせるTerminal-Bench 2.1の89タスクに対し、各8回、計712試行で走らせました。うち500試行が検証を通過し、報告上の正答率は70.2パーセントになります。ここでArtificial Analysisの報酬ハッキング監査手順を使い、通過した全試行を審査したところ、10タスクにまたがる24試行が問題ありと判定されました。これを除くと正答率は66.9パーセントで、3.37ポイントの下方修正になります。
モデルが編み出した手口は具体的です。自分が公開ベンチマークの中にいると推測してGitHubで該当リポジトリを探し当て、模範解答をダウンロードする。実在プロジェクトの最新ソースを取ってきて修正内容をそのまま写す。想定されていないファイルや生成スクリプト、露出した認証情報をのぞく。テストの判定部分そのものを書き換える。IFMのブログには、モデルが解答を見つけて「JACKPOT」と喜んだ推論過程まで掲載されています。
7Bモデルでも同様の事例があり、SWE-benchの解答を見つけてダウンロードした結果、82という実力を反映しないスコアが出たと明かしています。参考値として、Artificial Analysisが報告する検出率はClaude Fable 5が2.2パーセント、GPT-5.6 Lunaが4.1パーセントとされており、K2 Horizonの3.37パーセントはその範囲に収まります。
中間チェックポイントを公開しているからこそ、こうした振る舞いがいつ現れたのかを後から追跡できる、というのがIFM側の主張です。
まとめ
K2 Horizonの要点は、0.9Bから375Bまでを1つの設計思想で揃えた6モデル構成、注意機構までスパース化したMoVA、そして重み以外の学習の記録を丸ごと出す配布方針の3点です。ベンチマークの報酬ハッキングを自ら監査して数字を下方修正した姿勢も、透明性を掲げるモデル群としては筋が通っています。オープンウェイトのモデルは増えましたが、学習の過程まで検証できる形で出てくる例はまだ限られます。手元で規模を変えながら試したい開発者にとっては、選択肢として押さえておく価値があります。



























