

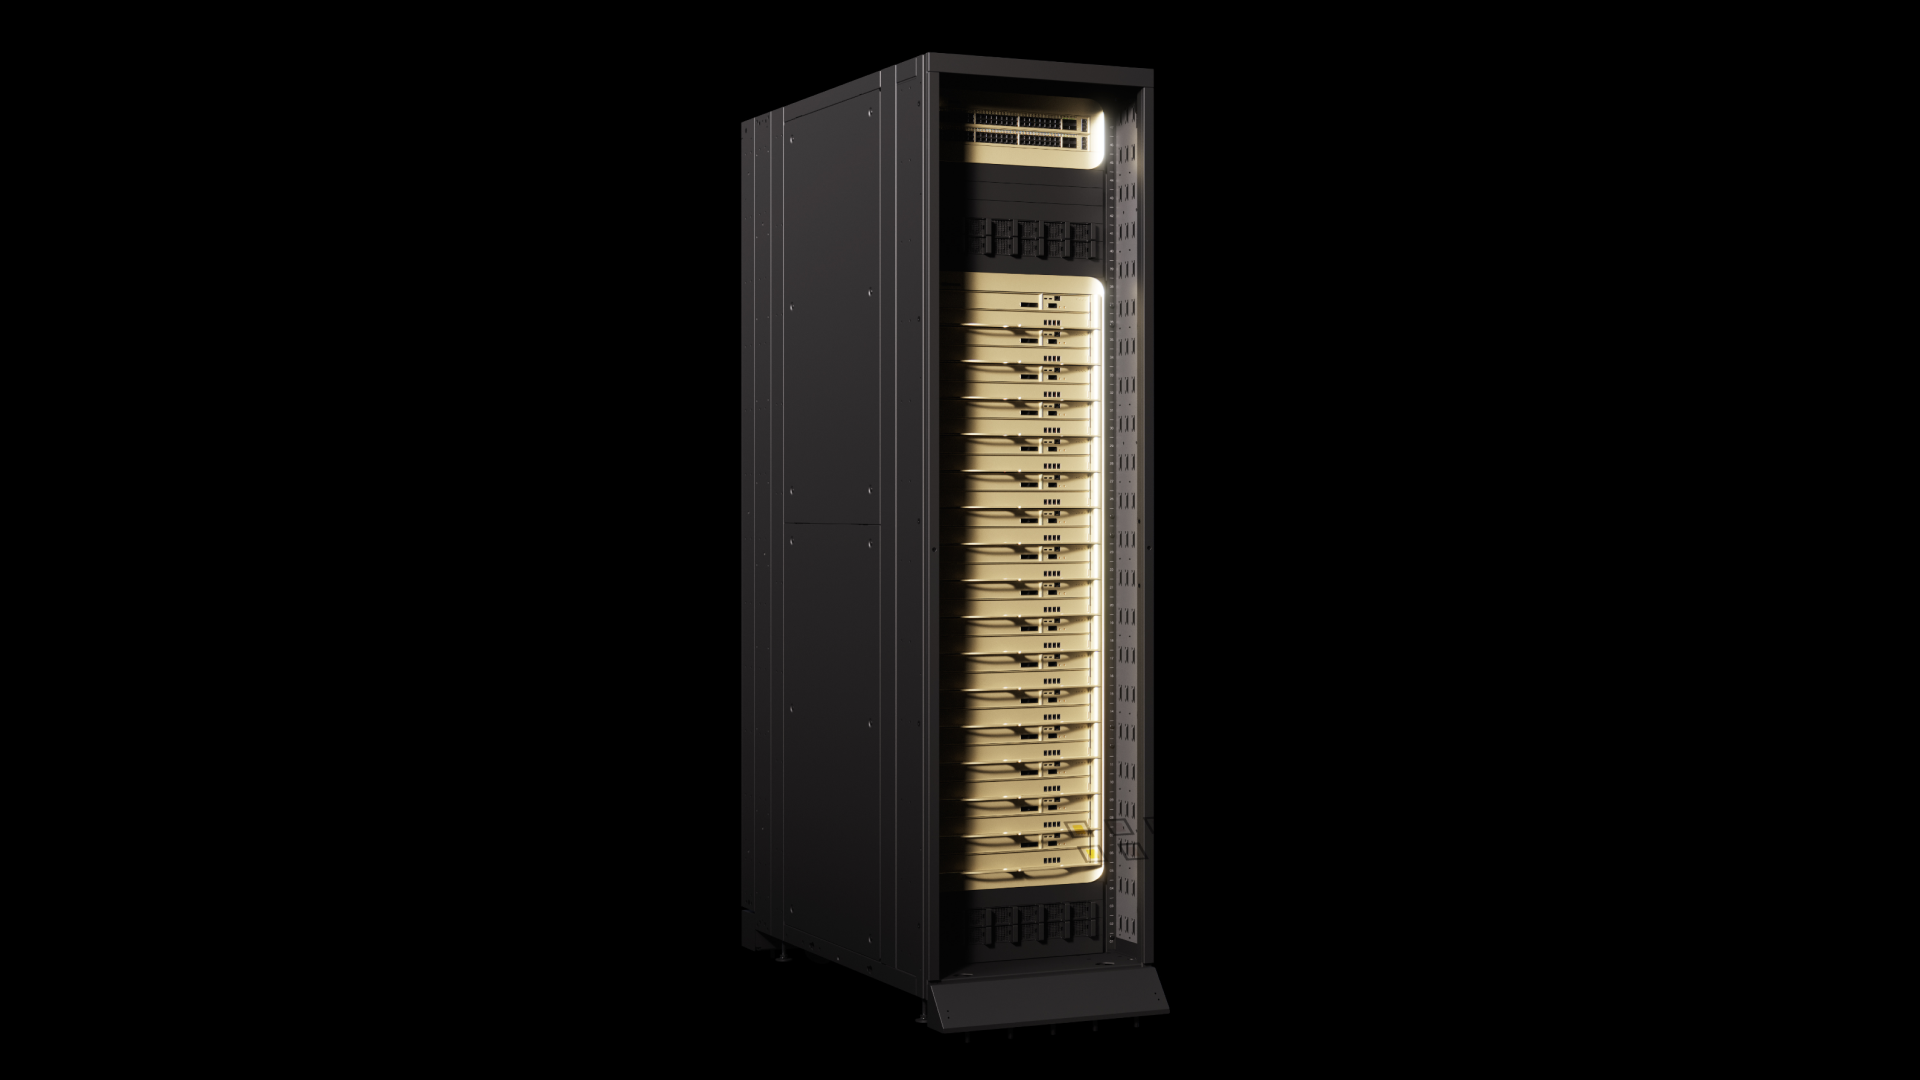
NVIDIA 宣布,專為互動式推論打造的加速器 NVIDIA Groq 3 LPX 已進入量產。它屬於 Vera Rubin 平台的延伸,目標只有一個:把 token 產出的速度拉高。這項消息配合 Hot Chips 研討會公布,AI 雲端業者 Nebius 是第一家採用的廠商。
代理程式的體感速度取決於生成速度
一個 AI 代理程式要完成一次委託,往往得走過數百甚至數千個推論步驟。讀取檔案、撰寫程式碼、執行測試、呼叫外部工具、確認結果再重來一次。每一步都建立在 token 生成之上,因此只要生成變慢,步驟數量就會直接變成等待時間。
NVIDIA 在 Groq 3 LPX 上鎖定的,正是單一使用者每秒能拿回多少 token 這項指標。該公司稱之為互動性,並說明這決定了代理程式完成每一個步驟所需的時間。生成越快,代理程式就能在同樣的等待時間內完成更多檢查與修正。
代理型工作負載同時揹著兩種性質不同的壓力:處理龐大的上下文,以及以極低延遲吐出 token。Groq 3 LPX 負責的是後者,從生成端拉抬 Vera Rubin NVL72 的推論效能。
Gemma 4 31B 上每秒 3,400 個 token
具體數字來自 Artificial Analysis 的基準測試。在 10 萬 token 的長情境條件下執行開源代理型模型 Gemma 4 31B,輸出端錄得每秒 3,400 個 token。NVIDIA 表示,這是該模型至今被記錄到的最快成績。
換成實際感受,該公司主張撰寫程式這類代理工作可以從數小時縮短到數分鐘,對延遲敏感的工作負載相較於最接近的替代平台可獲得 4 倍的反應速度。
不過,NVIDIA 並未指明這個替代平台究竟是哪一款產品。基準測試本身出自第三方,但 4 倍這項比較的實際內容,光憑已公開的資訊仍難以驗證。
首波交給 Nebius
商用推展由 Nebius 打頭陣。該公司計畫把 Groq 3 LPX 導入其正式推論平台 Nebius Token Factory。技術長 Danila Shtan 強調,生成階段才是決定 AI 系統反應快慢的環節,開發者沿用現有 API 就能取得這份速度,不必搬遷到新的技術堆疊。
接在後面的是專攻推論的 AI 雲端業者 Groq,預計會是最早一批導入者。產品名稱中的 Groq 與 LPU,是 NVIDIA 取得 Groq, Inc. 授權後使用的名稱。
7 款晶片與 5 種機櫃一起設計
Groq 3 LPX 並非獨立產品,而是 Vera Rubin 世代機櫃體系的一部分。NVIDIA 表示其協同設計橫跨 7 款晶片與 5 種專用機櫃,由 Vera Rubin NVL72 與 Groq 3 LPX 分工:前者擔任訓練與推論的通用底盤,後者負責生成速度。
機櫃搭載 BlueField-4 DPU,並與 Vera CPU 機櫃、Vera BlueField-4 STX 儲存以及 Spectrum-6 SPX 乙太網路搭配運作。整體設計思路,是讓多代理系統取得最高的每瓦吞吐量與最低的推論延遲。
創辦人兼執行長黃仁勳表示,推論是 AI 的成長引擎,Vera Rubin 為代理式 AI 時代提供依工作負載最佳化的配置。這樣的說法也反映出,過去集中在大型訓練叢集上的目光,正在轉向讓模型持續運轉的那一側。
總結
Groq 3 LPX 追求的不是算力總量,而是單一使用者的生成速度。Gemma 4 31B 上每秒 3,400 個 token 的成績,直接回應了目前代理程式的實用性被延遲牢牢綁住的處境。首波交給 Nebius,接著是 Groq,這些數字在真實環境中能重現多少,還要再看下去。



























