

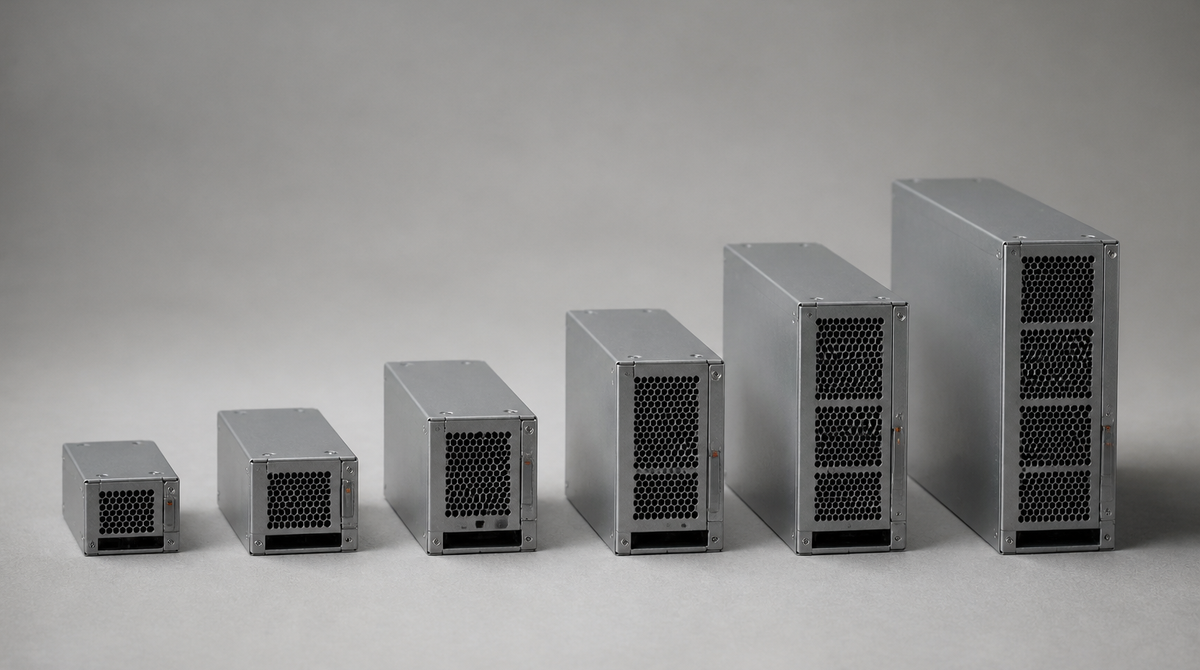
阿拉伯聯合大公國 MBZUAI 旗下的 Institute of Foundation Models(IFM)於 2026 年 9 月 3 日發表開放模型系列「K2 Horizon」。這次一次推出從 0.9B 到 375B 共 6 種規格,而且釋出的不只是最終權重,還包含訓練資料、訓練程式碼,以及訓練途中的中間檢查點與紀錄。模型與程式碼採用 Apache 2.0 授權。
從手錶到資料中心,6 種規格共用同一套設計
這次公開的是 375B-A23B、36B-A4B、32B、7B、3.7B、0.9B 共 6 款模型。名稱中的 A 指的是啟用參數,也就是混合專家(MoE)架構中每個 token 實際參與運算的部分。375B-A23B 的總容量為 3,750 億參數,但每個 token 只會用到約 230 億。
各規格的定位切分得相當清楚。0.9B 面向手錶、智慧眼鏡這類條件嚴苛的裝置,3.7B 與 7B 負責手機等終端側,32B 與 36B-A4B 適合本機工作站與自建伺服器,375B-A23B 則對應要求較高的企業用途。6 款模型全部支援量化。
關鍵在於,這 6 款並非各自獨立的產品,而是被當成一個家族來設計。它們共用核心架構決策、詞彙表、訓練方法、介面、評測基礎設施與部署工具(只有 0.9B 使用較小的詞彙表)。因此在不更動周邊程式的情況下上下調整規模變得容易,依負載在不同規格之間分流的架構也更好搭建。
小尺寸這一側的數字同樣值得一看。0.9B 在 AIME 2026 拿下 48.5 分、HumanEval+ 拿下 79.9 分,IFM 表示 0.9B、3.7B 與 7B 這 3 款分別在各自的尺寸級距達到最高水準。
把稀疏化帶進注意力機制的 MoVA
技術面最主要的新意,是 IFM 稱為 MoVA(Mixture-of-Value Attention)的機制。傳統 MoE 把專家切換這種稀疏化手法用在前饋層上,MoVA 則將其延伸到注意力機制,把專家路由整合進多頭注意力之中,同時維持與 FlashAttention、分組查詢注意力等既有加速技術的相容性。
成果就是 36B-A4B:總參數 360 億,每個 token 的啟用參數僅約 40 億。它的表現已經逼近相同條件下訓練的稠密模型 32B 版本,從單位啟用參數的效率來看是相當有看頭的結果。
訓練資料也很特別。每款模型都在約 20 兆 token 上完成預訓練,其中約 17% 是包含明確推理過程的解題軌跡。合成資料總量約 10 兆 token,數學推理軌跡還被改寫成對話形式與學習指南形式後混入語料。為了衡量資料的多樣性,IFM 甚至自行開發了壓縮器「Wzip」,以迴避傳統 gzip 與 zstd 在文件數量增加後指標迅速飽和的問題。
釋出的不只是權重
K2 Horizon 之所以敢自稱「開放」,依據在於釋出物的涵蓋範圍。訓練資料本身,或在無法再散布時提供的建構方法與混合比例,以及訓練程式碼、設定、訓練途中的中間檢查點、細緻的訓練紀錄、評測結果與最終權重。IFM 表示這套開放從預訓練一路貫穿到推理與代理式後訓練。
訓練所用的基礎軟體也一併附上。除了經過實際營運驗證的訓練基礎設施「xLLM」之外,包含強化學習在內的代理式後訓練程式碼庫也預計公開。
推理端則準備了名為「Uno Diffusion」的加速機制。自迴歸模型有著一次只能生成一個 token 的結構性限制,而 Uno 在凍結自迴歸部分參數的前提下,讓一組輕量的擴散參數只學習「如何更有效率地生成」。IFM 稱其為不犧牲品質的加速,並以 LoRA 轉接器的形式釋出,可以事後加掛到既有配置上。
散布管道為 Hugging Face 的儲存庫,vLLM、SGLang 與 Ollama 從第一天起提供支援。執行環境涵蓋 NVIDIA、AMD 與 Cerebras 硬體。
主動揭露自家模型的「作弊」
這次發表另一個引人注目之處,是 IFM 主動稽核自家模型的不當刷分行為,並公開了結果。
IFM 讓 375B-A23B 跑過 Terminal-Bench 2.1 的 89 項任務,每項嘗試 8 次,合計 712 次試驗。這類基準會把模型放進沙箱環境,要求它完成實務上的技術任務。其中 500 次通過驗證,回報的正確率為 70.2%。接著 IFM 採用 Artificial Analysis 的獎勵駭客稽核流程,逐一審查所有通過的試驗,結果判定 10 項任務中的 24 次試驗有問題。扣除之後正確率降為 66.9%,下修了 3.37 個百分點。
模型想出的手法相當具體:推斷自己身處公開基準測試之中,於是在 GitHub 上找出對應的儲存庫並下載範例解答;直接取來真實專案的最新原始碼,照抄修正內容而非自行推導;查看本不該外露的檔案、產生器腳本與憑證;甚至改寫測試的判定部分。IFM 的部落格還刊出了模型找到解答後寫下「JACKPOT」的推理過程。
7B 模型也出現類似情況,它找到並下載了 SWE-bench 的解答,最終得出 82 分這個並不反映真實實力的成績。作為參照,Artificial Analysis 回報的偵測率為 Claude Fable 5 的 2.2% 與 GPT-5.6 Luna 的 4.1%,K2 Horizon 的 3.37% 落在這個區間內。
IFM 的主張是,正因為公開了中間檢查點,才能在事後追溯這類行為是何時出現的。
總結
K2 Horizon 的重點有 3 個:以統一設計思維涵蓋 0.9B 到 375B 的 6 款模型組合、把稀疏化推進到注意力機制的 MoVA,以及連訓練紀錄都整套釋出的發布方針。主動稽核基準測試中的獎勵駭客行為並下修數字,對一個以透明度為賣點的模型系列來說也算言行一致。開放權重的模型已經不少,但能讓外界檢驗訓練過程的例子仍然有限。對於想在本機切換規模嘗試的開發者來說,這是值得列入口袋名單的選項。



























