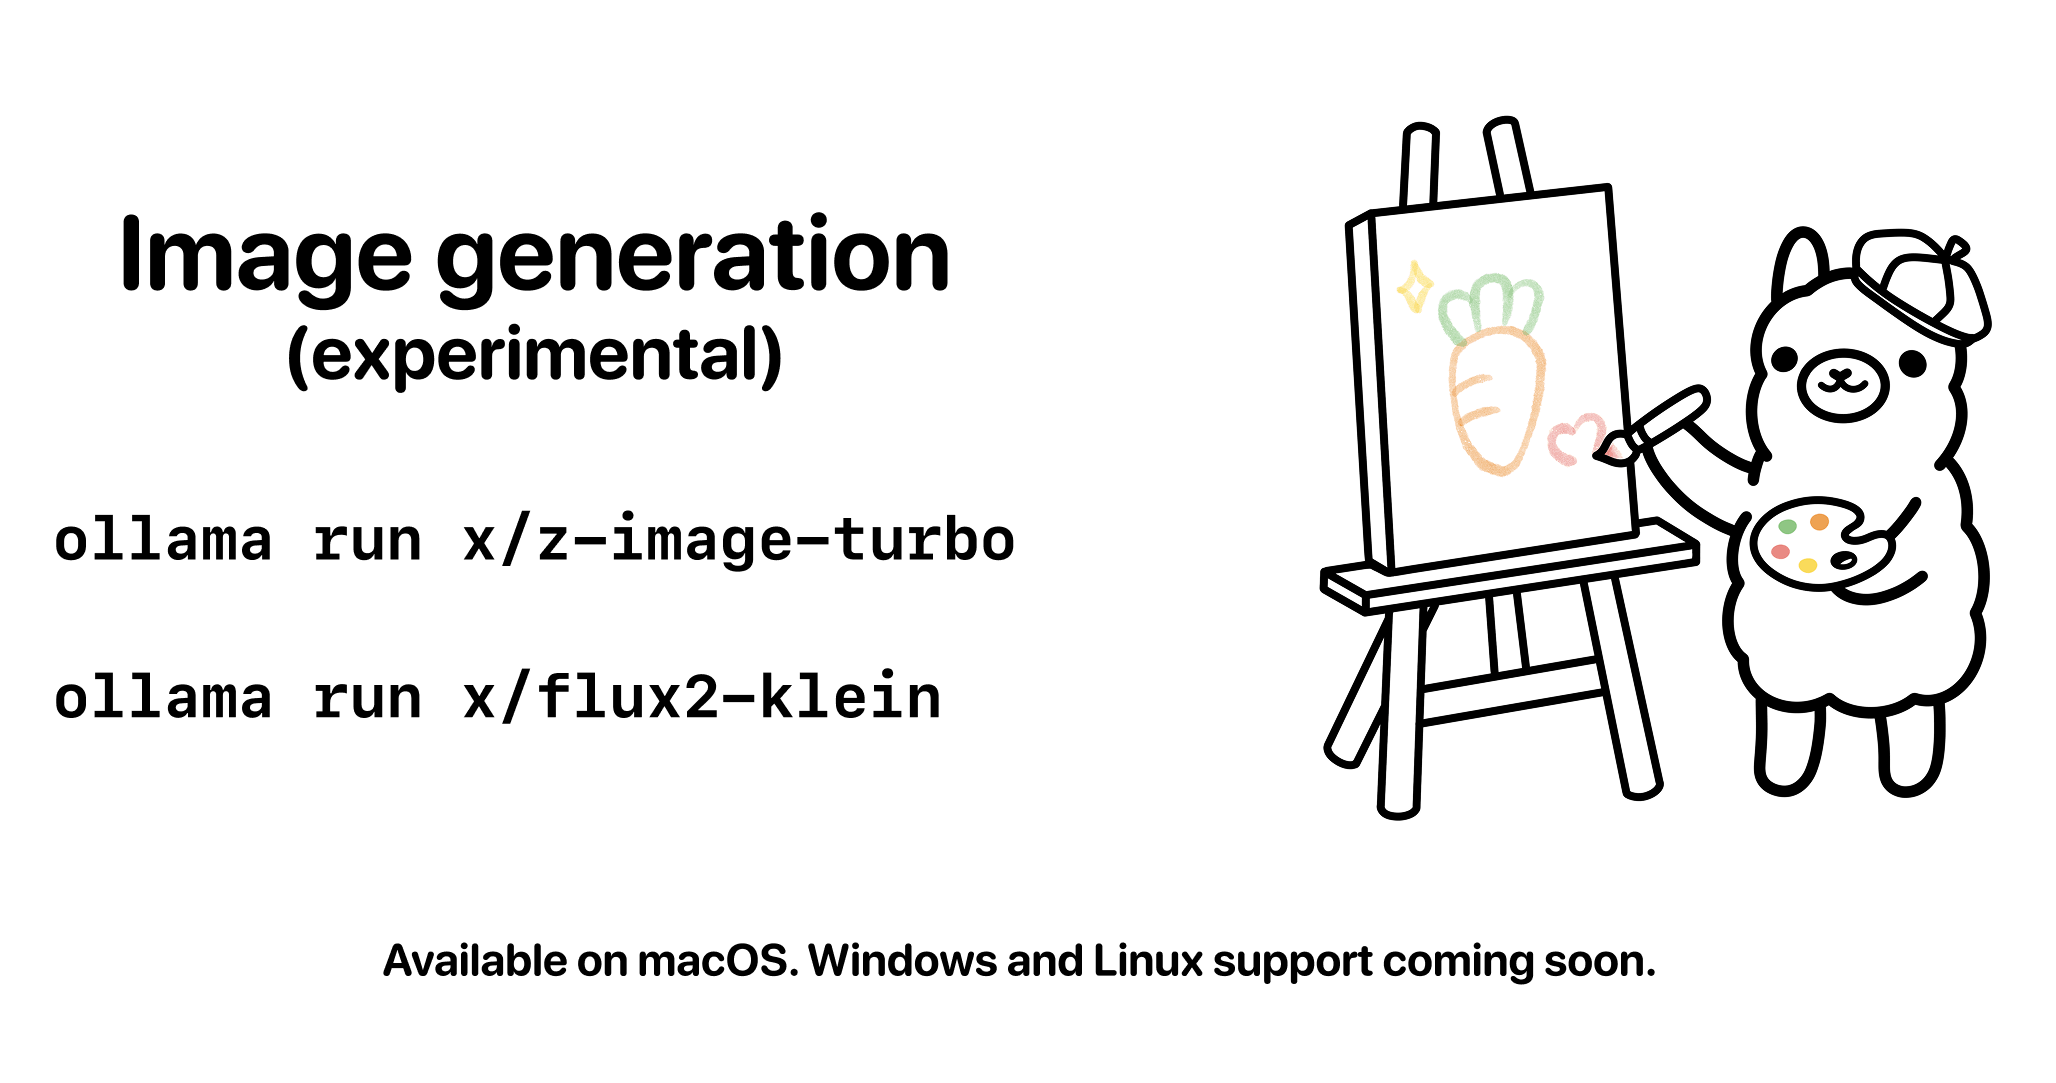
用于在本地运行大语言模型(LLM)的工具「Ollama」开始实验性支持根据文本生成图像的功能[1]。该功能率先面向 macOS 提供,对 Windows 和 Linux 的支持也即将到来[1]。它内置了由阿里巴巴通义实验室(Tongyi Lab)开发的「Z-Image Turbo」,以及 Black Forest Labs 的「FLUX.2 Klein」两款模型,都可以仅在本机上运行[1]。对于不想完全依赖云服务的用户来说,把图像生成全程放在本地完成的选择更多了。
终端即可完成、率先登陆 Mac 的图像生成
Ollama 的图像生成和以往的对话模型一样,只需在终端输入一条命令即可调用[1]。用法是在模型名称后附上提示词(指令文)再执行[1]。
ollama run x/z-image-turbo "your prompt"
生成的图像会保存到当前所在的目录(文件夹)中[1]。此外,支持图像显示的终端可以就地预览保存的图像,具体列举的对象包括 Ghostty 和 iTerm2 等终端[1]。从生成到查看都能在同一个画面内完成,无需另外打开查看器。
目前支持的系统仅有 macOS,Windows 和 Linux 标注为「即将支持」[1]。由于处理全程在本机的 Mac 上完成,输入的提示词和生成的图像无需发送到外部服务器,这在顾虑隐私或网络环境的场景下是一项优势。
内置模型「Z-Image Turbo」与「FLUX.2 Klein」
本次实验性支持准备了两款图像生成模型[1]。
第一款是「Z-Image Turbo」。它由阿里巴巴通义实验室打造,是一款 60 亿参数(表示模型规模的数值)的文本转图像模型,擅长生成写实风格的图像[1]。它还能在图像中准确地呈现英文和中文两种文字[1]。其许可证为 Apache 2.0,公开了权重(训练好的数据),并允许商业使用[1]。执行命令如下[1]。
ollama run x/z-image-turbo
第二款是「FLUX.2 Klein」。它被定位为 Black Forest Labs 迄今最快的图像生成模型,提供 40 亿(4B)和 90 亿(9B)两种参数规模[1]。它擅长在图像中呈现清晰可读的文字,适合用于 UI 原型(界面草图)以及包含文字的设计[1]。许可证因规模而异:4B 模型采用可商用的 Apache 2.0,9B 模型则适用「FLUX Non-Commercial License v2.1」这一非商业许可证[1]。执行命令如下[1]。
ollama run x/flux2-klein
两款模型可以按用途分别选用。追求写实照片风格可选 Z-Image Turbo,需要包含文字的设计用途则可选 FLUX.2 Klein。
通过配置项精细调整生成
Ollama 的图像生成可以通过指定若干参数来调整结果[1]。
保存位置默认是当前目录,但只要在终端切换目标目录,保存位置也会随之改变[1]。图像尺寸可用「/set width」「/set height」命令指定宽度和高度,图像越小生成越快,占用内存也越少[1]。
左右生成质量与速度的是步数[1]。这个数值指模型内部反复处理的次数,步数少则快但细节粗糙,反之过多有时会出现多余的噪点(artifact)[1]。Ollama 会为每款模型预先设定推荐的默认值[1]。
此外,还可以指定用于复现相同结果的种子值(随机数种子),以及用于说明不希望图像中出现哪些元素的负面提示词[1]。固定种子值后,就能从相同的提示词再次得到相同的图像,这在逐步打磨构图或分享生成结果时很有用[1]。
后续计划
关于今后的安排,Ollama 列出了对 Windows 和 Linux 的支持,以及新增图像生成模型和图像编辑功能[1]。目前它仍属于实验性定位,但在本就能在本地完成从对话到代码生成的 Ollama 上再加入图像生成,单台本机所能承担的 AI 用途看来会进一步扩大。
总结
Ollama 实验性支持了根据文本生成图像,并率先在 macOS 上可用。它内置了阿里巴巴通义实验室、擅长写实表现的「Z-Image Turbo」,以及 Black Forest Labs、擅长文字呈现的「FLUX.2 Klein」两款模型,二者都只需一条终端命令即可运行。保存位置、尺寸、步数、种子值、负面提示词等调整项也一应俱全,让人可以在不向云端发送数据的前提下,仅在本地试用图像生成。对 Windows 和 Linux 的支持以及图像编辑功能也已预告,后续的扩展值得关注。