NVIDIA 在官方博客上提出了面向智能体 AI 时代的新标尺——"每美元智能(intelligence per dollar)"[1]。该公司认为,AI 已经不再是训练一次就结束,而是进入了以"后训练(post-training)"为主角的时代,即在运行中持续打磨模型能力的阶段。NVIDIA 把新平台"Vera Rubin"定位为高效承接这种持续负载的基础设施,声称能以上一代四分之一的 GPU 数量训练最大规模的模型,从根本上重新审视 AI 基础设施的成本结构。
后训练从"一次性"变为"不停循环"的工序
NVIDIA 用职业运动员来比喻。真正拉开顶尖选手差距的,是比赛之间发生的事:持续修正、根据上一场暴露的问题调整并磨练技艺。智能体 AI 也是如此[1]。与只对提示作出回应的生成式模型不同,智能体被赋予一个目标,必须在环境变化、工具更替和意外情况中自行规划,并在执行途中的失败里重新站起来。
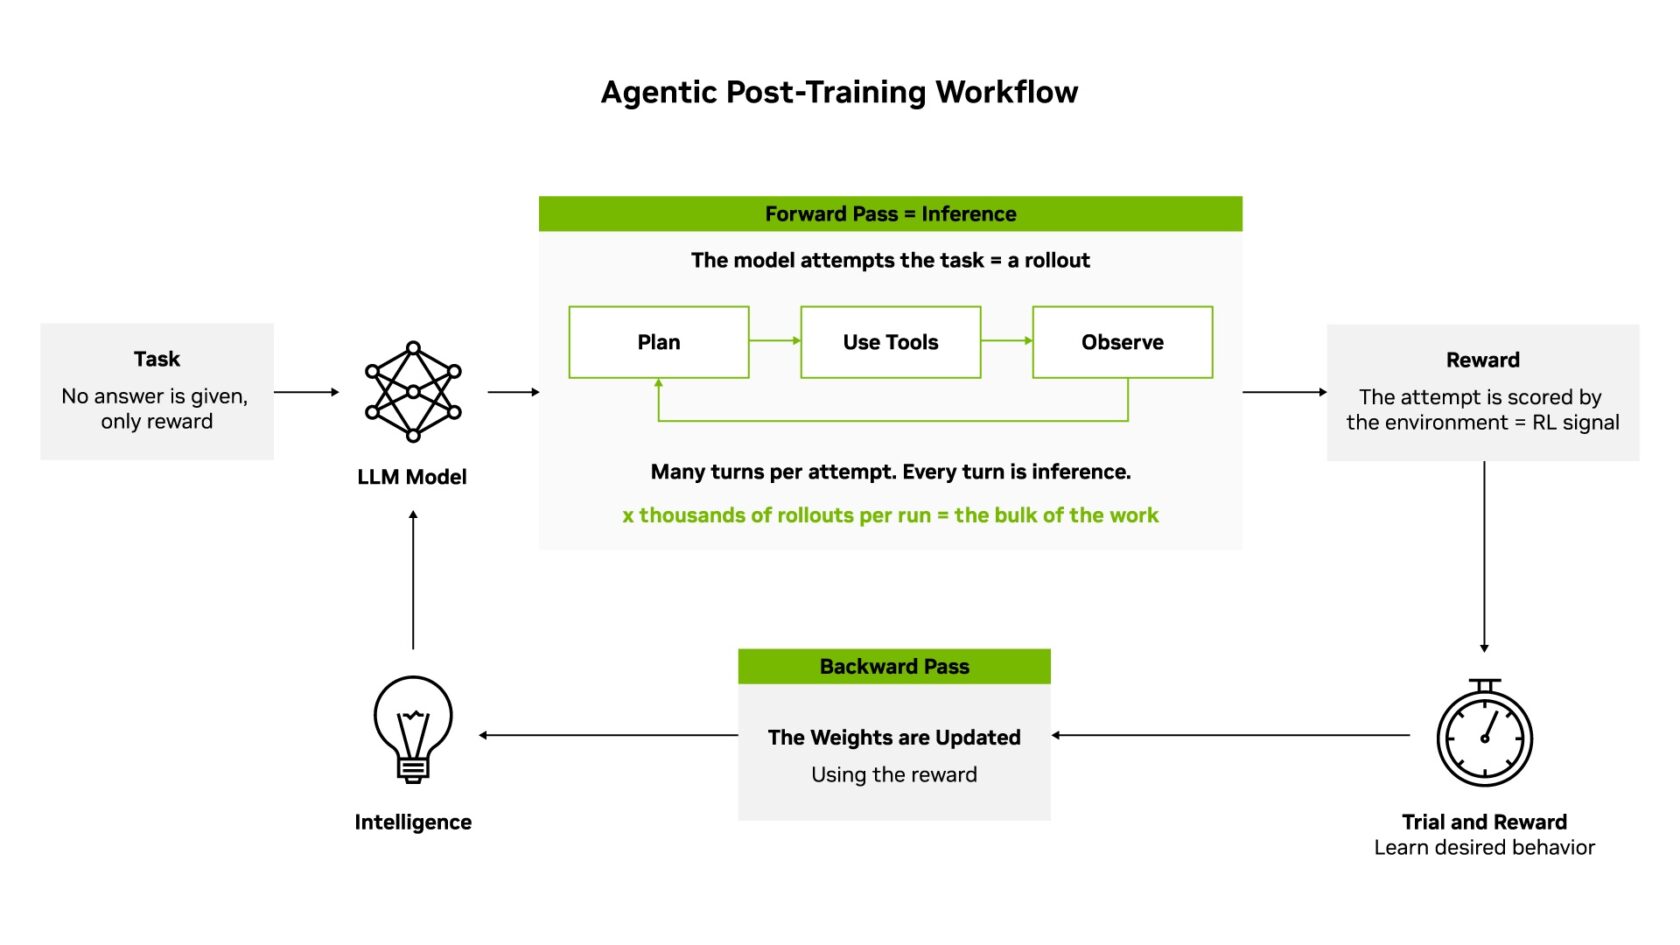
正因如此,在初始训练之后打磨模型的"后训练",已不再是一次性的收尾步骤。智能体所用的工具可能每周都在变,生产环境中会不断浮现测试集未曾预料的边缘案例。训练会从生产端不断循环回流,算力占用增长并非因为单次运行更大,而是因为运行永不停止。NVIDIA 将其称为智能体时代的核心工作负载[1]。
"每美元智能"这把新标尺
后训练的目标,是让学习循环中每一次前向处理(推理)和反向处理(权重更新)的收益最大化,提高每投入一美元所换来的智能。"每美元智能"正是在此登场[1]。
NVIDIA 把这一指标放在人们熟悉的"每令牌成本(cost per token)"之上一层。每令牌成本衡量的是运营效率,即交付 100 万令牌需要多少成本;而每美元智能追问的是:打造一个值得提供服务的模型、并随环境变化让它持续保持价值,需要多少成本。二者不是竞争而是嵌套关系——降低每令牌成本的基础设施,也会同时降低植入模型的每一单位智能的成本[1]。
作为具体例子,NVIDIA 提到了开放权重、拥有 5,500 亿参数的模型"Nemotron 3 Ultra"。它公开了完整的训练流程,并在评估真实软件缺陷修复的标准基准"SWE-bench verified"上取得 71.7%,在开源真实缺陷中,大约每 10 个里就有 7 个生成了能通过项目自身测试的修复[1][2]。
Vera Rubin 训练顶级模型只需四分之一 GPU
为让这种持续后训练在经济上可行,NVIDIA 表示现有的"Blackwell"平台降低了单次运行成本,使频繁的后训练变得现实可行。而下一代"Vera Rubin"进一步推动这一趋势,能以 Blackwell 世代四分之一的 GPU 数量训练最大规模的模型[1]。
Vera Rubin 面向智能体的持续学习进行了端到端的协同设计,目标是在单次运行中跑更多的尝试(rollout)、同时运行更多环境,并支撑永不停止的后训练循环。
实际开发现场中的用法
NVIDIA 还介绍了多个采用案例。持续对前沿开放模型进行后训练的 Prime Intellect,目前在 Blackwell 上跑训练,并计划在 Vera Rubin 上扩展强化学习环境、在单次运行中生成更多尝试。该公司在检验真实强化学习负载时发现,Vera CPU 相比 x86 架构,平均每 CPU 吞吐量高出 30%[1]。
搜索 AI 公司 Perplexity 在数百块 NVIDIA GPU 上异步执行强化学习后训练。借助基于 RDMA 的权重传输机制,可在训练侧与推理侧节点之间以不到 2 秒的时间同步万亿参数规模的模型,并将由此完成后训练的"Qwen3 235B"模型部署在"GB200 NVL72"系统上运行[1]。
将后训练作为服务提供的 Together AI,也通过 API 提供有监督微调、强化学习和偏好优化等一整套工序,并期待下一步用上 Vera Rubin。NVIDIA 强调,面向训练环境的"NeMo Gym"和面向分布式后训练的"NeMo RL"等开放库,能把这类工作从研究者专属的定制代码,转变为可复用的基础设施[1]。
总结
NVIDIA 此次提出的"每美元智能",把 AI 的评价维度从"单次推理有多便宜",扩展到"打造聪明的模型并让它保持聪明的成本"。后训练越是变成不停的循环,算力负载就越持续攀升,而 Vera Rubin 据称能以 Blackwell 世代四分之一的 GPU 完成这一切。包括 Prime Intellect 与 Perplexity 等现场数值在多大范围内能被普遍复现,这都表明智能体时代的基础设施竞争,正连同衡量成本的标尺一起发生改变。
出典:https://blogs.nvidia.com/blog/nvidia-vera-rubin-post-training-intelligence-per-dollar/