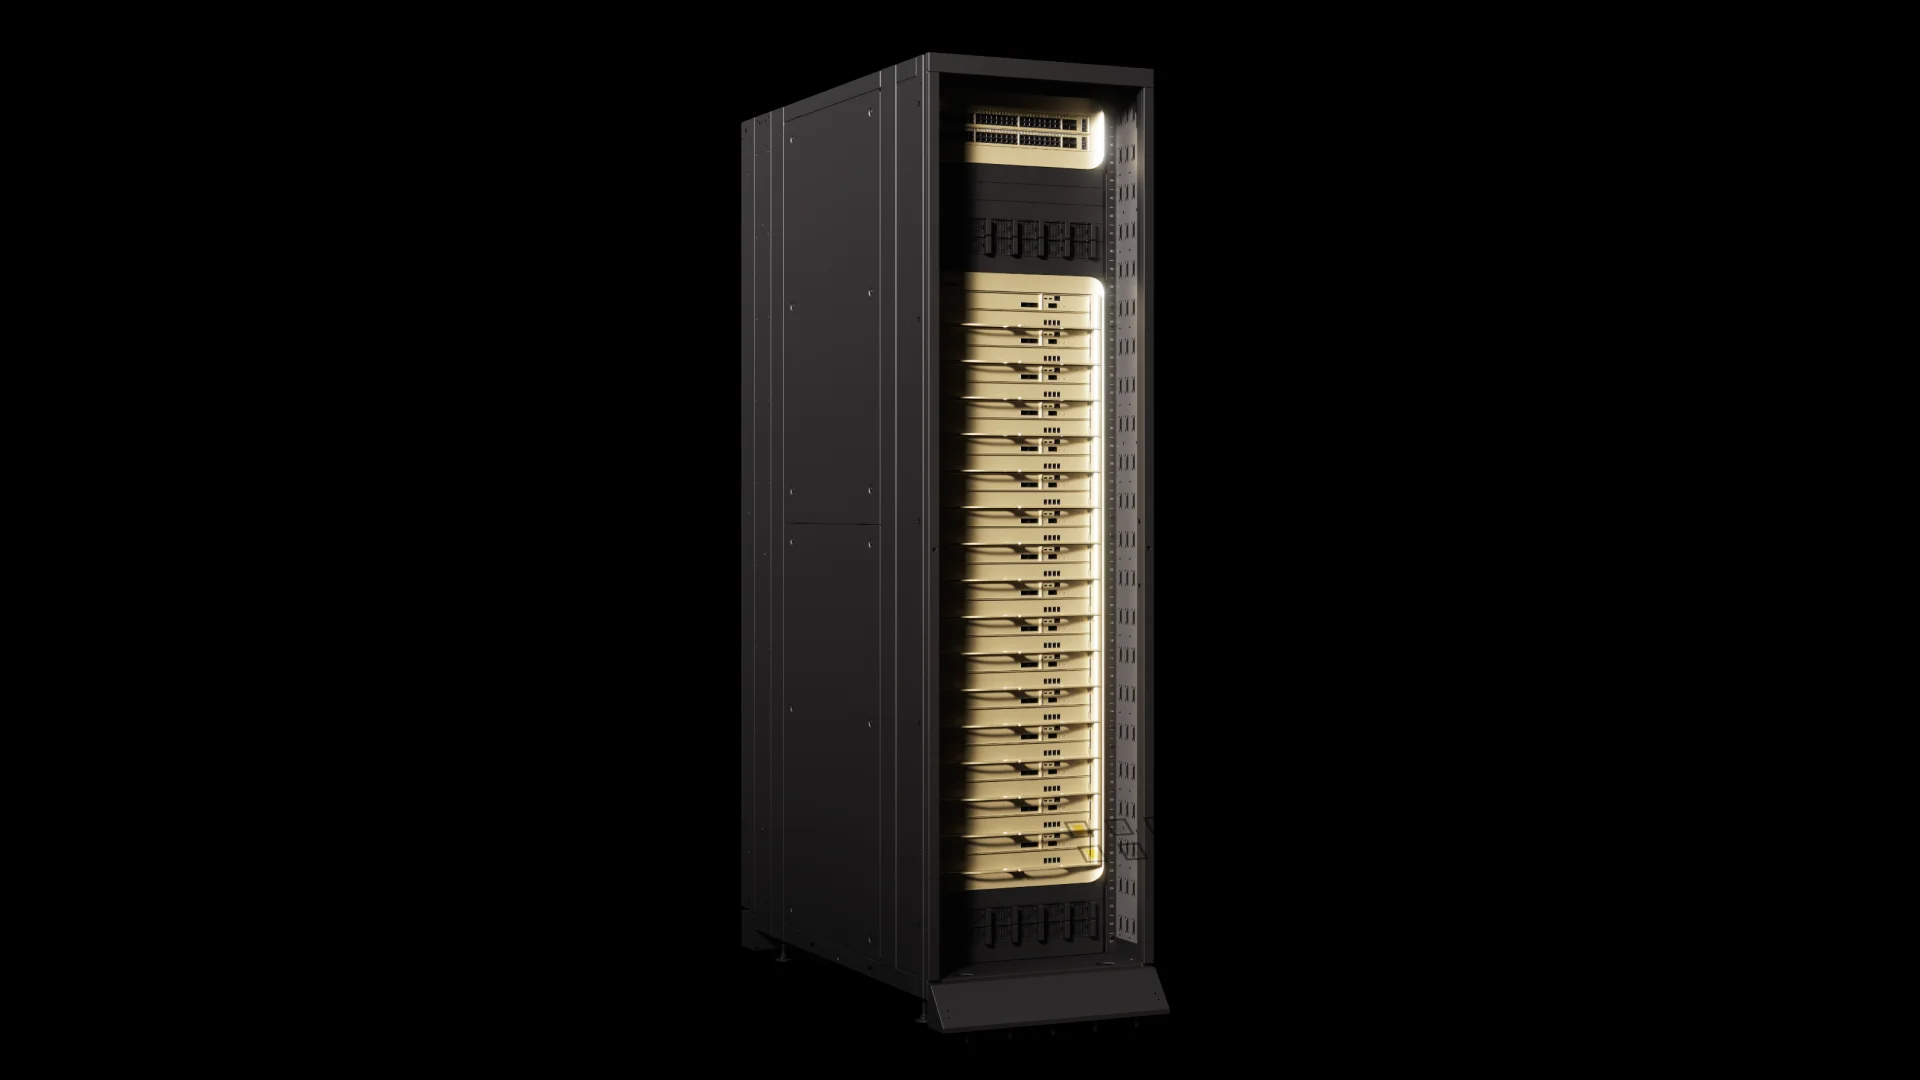
英伟达宣布,专为交互式推理打造的加速器 NVIDIA Groq 3 LPX 已进入量产阶段。它是 Vera Rubin 平台的扩展,目标只有一个:提高 token 的生成速度。该消息随 Hot Chips 会议一同公布,AI 云服务商 Nebius 成为首个采用方。
智能体的体感速度取决于生成速度
一个 AI 智能体完成一次请求,往往要经过数百甚至数千个推理步骤。它读取文件、编写代码、运行测试、调用外部工具、核对结果,然后再次尝试。每一步都建立在 token 生成之上,因此生成一慢,步骤数量就会直接转化为等待时间。
英伟达在 Groq 3 LPX 上瞄准的,正是单个用户每秒能拿到多少 token 这一指标。该公司将其称为交互性,并解释说这决定了智能体完成每一步工作所需的时间。生成越快,智能体就能在同样的等待时间内完成更多的检查与修正。
智能体类工作负载同时承载着两种性质不同的压力:处理超长上下文,以及以极低延迟输出 token。Groq 3 LPX 被安排负责后者,从生成侧提升 Vera Rubin NVL72 的推理性能。
Gemma 4 31B 上每秒 3,400 token
具体数字来自 Artificial Analysis 的基准测试。在 10 万 token 的上下文条件下运行开源智能体模型 Gemma 4 31B,输出侧录得每秒 3,400 token。英伟达表示,这是该模型迄今为止被记录到的最快成绩。
换成实际感受,该公司称编码这类智能体任务可以从数小时缩短到数分钟,对延迟敏感的工作负载相比最接近的替代平台可获得 4 倍的响应速度。
不过,英伟达并未说明这里的替代平台具体指哪款产品。基准测试本身出自第三方,但 4 倍这一比较的具体依据,仅凭已公开的信息还难以复现。
首发落在 Nebius
商用推广由 Nebius 打头阵。该公司计划将 Groq 3 LPX 引入其生产级推理平台 Nebius Token Factory。CTO Danila Shtan 强调,生成阶段才是决定 AI 系统响应快慢的环节,开发者可以沿用现有 API 获得这一速度,无需迁移到新的技术栈。
紧随其后的是专注推理的 AI 云服务商 Groq,预计将成为最早一批采用者。产品名称中的 Groq 与 LPU 均由英伟达从 Groq, Inc. 获得授权使用。
7 款芯片与 5 种机架的协同设计
Groq 3 LPX 并非独立产品,而是 Vera Rubin 世代机架体系的一部分。英伟达称其协同设计横跨 7 款芯片和 5 种专用机架,由 Vera Rubin NVL72 与 Groq 3 LPX 分工:前者承担训练与推理的通用底座,后者负责生成速度。
机架搭载 BlueField-4 DPU,并与 Vera CPU 机架、Vera BlueField-4 STX 存储以及 Spectrum-6 SPX 以太网协同工作。整体设计思路是让多智能体系统获得最高的每瓦吞吐量和最低的推理延迟。
创始人兼 CEO 黄仁勋表示,推理是 AI 的增长引擎,Vera Rubin 面向智能体 AI 时代提供按工作负载优化的配置。这样的措辞也反映出,过去集中在大型训练集群上的关注,正在转向持续运行模型的那一侧。
总结
Groq 3 LPX 追求的不是算力总量,而是单个用户的生成速度。Gemma 4 31B 上每秒 3,400 token 的成绩,直接回应了当下智能体可用性被延迟严重束缚的现实。首发交给 Nebius,随后是 Groq,这些数字在真实运行环境中能还原多少,还有待观察。