英伟达(NVIDIA)于当地时间 9 月 14 日宣布,在开源量子计算平台“CUDA-Q”中新增面向容错量子计算机的新层“CUDA-Q Logical”。此次发布配合在加拿大多伦多举办的量子计算国际会议“IEEE Quantum Week 2026”。其特点是可以在同一条流程中组合并测试算法、纠错码、硬件配置等要素。美国费米国家加速器实验室(Fermilab)表示,设计所需的时间已从 5 个月缩短至 3 周。CUDA-Q Logical 现已可通过 GitHub 获取。
面向“逻辑量子比特”时代的基础
作为量子计算机基本单位的物理量子比特极易受噪声影响,若直接使用,错误会在计算过程中不断累积。因此,将多个物理量子比特捆绑在一起、检测并纠正其中的错误,把它们当作一个可靠的“逻辑量子比特”来使用的方式,被认为是实用规模量子计算不可或缺的前提。药物研发、金融建模、材料开发等大规模计算,都以这种容错机制为基础。
不过,面向容错量子计算机的应用开发是一项费时费力的工作。稍微调整算法、换用另一种纠错码、重新审视硬件配置,只要动其中任何一项,所需的物理量子比特数量和运行时间就会大幅变化。由于各要素相互影响,如果不把它们放在一起设计(协同设计),就找不到最优组合。
CUDA-Q Logical 正是承担这一部分工作的层。研究人员可以在一处设计并整合以逻辑量子比特为前提的应用所需的各个要素,通过切换选项寻找性能最佳的配置。领导英伟达量子业务的 Timothy Costa 表示,量子计算正在走向逻辑量子比特的时代,研究人员需要一个能够表达容错系统所有方面、开放且可定制的平台。他强调,无论量子比特的类型和架构如何,该平台都能用于探索完全集成、协同优化的系统。
工作方式接近编译器
根据英伟达研究团队公开的技术文档,CUDA-Q Logical 位于物理执行层的正上方,通过名为“虚拟逻辑机”的抽象计算机模型,把不依赖特定硬件的量子程序逐级下沉。在这一过程中,它会生成用于纠错的微代码、操控物理量子比特的脉冲调度以及实时控制方案,可以说是一套专用于容错量子计算的编译器基础设施。
笔者觉得有意思的一点是,所需资源的估算不是来自理论公式,而是直接从编译器实际生成的产物中导出。以往人们往往依赖“这种规模的计算大概需要这么多物理量子比特”的粗略估算,而现在可以直接清点实际配置,估算的可信度也随之提高。
Fermilab 提速 7 倍,硅量子比特所需数量降至十分之一
作为早期成果,官方公布了几组数字。Fermilab 的研究团队使用 CUDA-Q Logical 验证了以往的研究结果,并针对不同纠错方法和量子硬件,评估了物理量子比特数量、运行时间等资源需求。他们把复杂的容错系统设计转化为可重复执行、可验证的计算工作流,结果算法开发周期从 5 个月缩短至 3 周,提速 7 倍。Fermilab 首席技术官、同时担任超导量子材料与系统中心主任的 Anna Grassellino 表示,以往需要花约 5 个月搭建专用基础设施的工作,如今只用 3 周就完成了。
另一个引人注目的案例来自澳大利亚的 Iceberg Quantum 和 Diraq。Iceberg Quantum 利用 CUDA-Q Logical,为 Diraq 的硅自旋量子比特建立了容错架构模型。结果显示,用 15 万个物理量子比特即可构建 1,000 个逻辑量子比特,约为 Diraq 此前估算数量的十分之一。这可以说是一个例子,说明通过设计上的巧思,能在多大程度上打破“纠错需要海量物理量子比特”的常识。
此外,中性原子路线的 Infleqtion、超导路线的 IQM Quantum Computers、硅路线的 Quantum Motion、从事仿真平台的 QCDesign,以及美国桑迪亚国家实验室,都已开始使用 CUDA-Q Logical。采用不同量子比特路线的企业和研究机构共用同一基础平台,这也正是英伟达反复强调“不限路线”的原因。
桑迪亚国家实验室的新基准“QUOPS”也已收录
此次发布还包括一项内容:桑迪亚国家实验室开发的新基准“QUOPS”已作为参考实现被纳入 CUDA-Q。QUOPS 是一个不依赖特定硬件的开放指标,用于衡量量子计算系统朝着实用规模应用推进了多少。
迄今为止,量子计算机的进步大多以增加量子比特数量、提高保真度、延长相干时间等物理量子比特层面的改进来描述。QUOPS 着眼于容错这一下一阶段,目的是让各家厂商能用共同的尺度比较进展。桑迪亚在 IEEE Quantum Week 之前发布了预印本,报告了针对谷歌(Google)、IBM、Quantinuum 量子处理器的初步基准测试结果。该实验室量子性能实验室的联合主任 Timothy Proctor 谈到基准的用意时表示,能够跟踪并预测量子计算机能力的增长,是整个行业都需要的。
连接 GPU 与量子处理器的生态不断扩大
除 CUDA-Q Logical 之外,官方还介绍了采用英伟达量子相关技术的其他动向。Diraq 正在使用面向量子计算构建和部署 AI 的开放模型系列“NVIDIA Ising”,对自家硅量子处理器进行校准。在用于把量子处理器与 GPU 超级计算机紧密耦合的开放系统架构“NVQLink”方面,Anyon Computing 开发了新的量子控制系统,法国光量子计算公司 Quandela 构建了量子处理器与 GPU 相结合的架构。Quantum Machines 则在以色列量子计算中心进行了整合超级计算机与量子比特的演示。
在应用层面,IonQ 在英伟达加速计算平台上报告了量子生成式 AI 框架“DQAOA-GPT”的进展,Phasecraft 利用英伟达的 cuQuantum 构建了对量子化学计算(变分量子本征求解器)进行大规模仿真的分子数据库,这些都是把 GPU 当作量子研究工具的案例。提供纠错和误差缓解软件的 Qedma Quantum Computing,以及拥有企业级混合量子应用平台的 QCentroid,也分别将各自的技术集成到了 CUDA-Q 中。
总结
英伟达在开源量子计算平台 CUDA-Q 中新增了面向容错量子计算机的设计与集成层“CUDA-Q Logical”。其要点在于能把算法、纠错码到硬件配置放在一起设计,并根据实际产物估算所需资源。Fermilab 的设计周期从 5 个月缩短至 3 周,在 Iceberg Quantum 与 Diraq 的案例中,所需物理量子比特数量降至以往估算的约十分之一。桑迪亚国家实验室的基准 QUOPS 也作为参考实现被收录。随着量子计算机的评价标准从“拥有多少量子比特”转向“能以多低的成本构建可靠的逻辑量子比特”,这次发布清楚地展现了英伟达试图从 GPU 一侧掌握这一设计流程的意图。
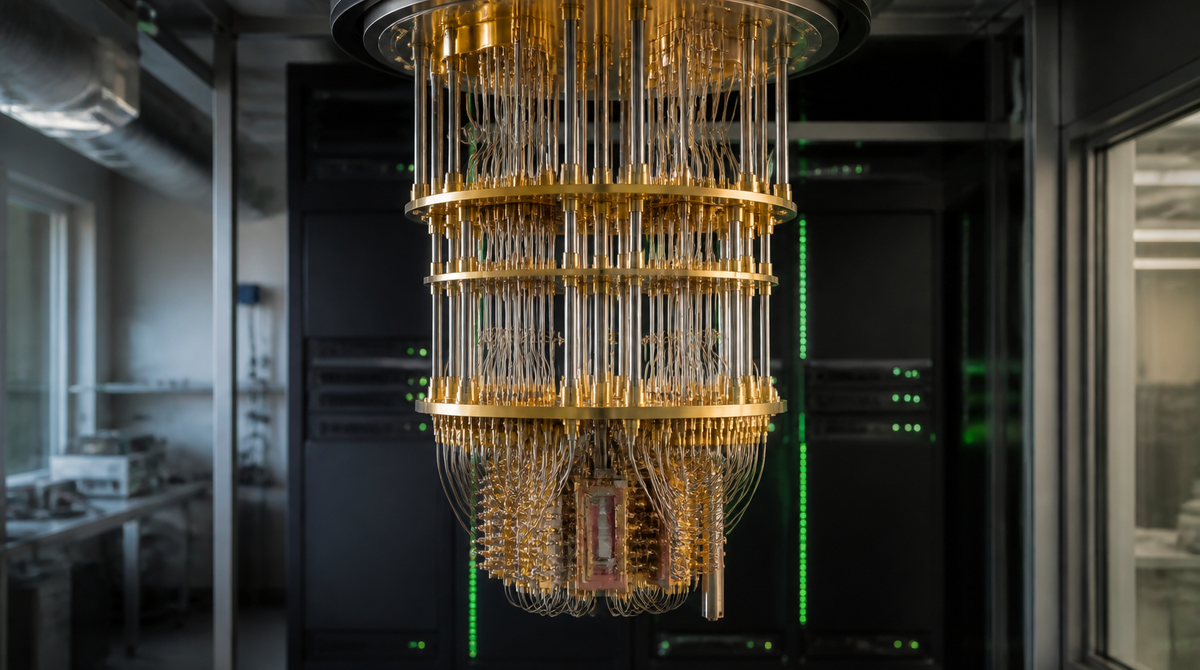
※缩略图为 AI 生成的示意图