

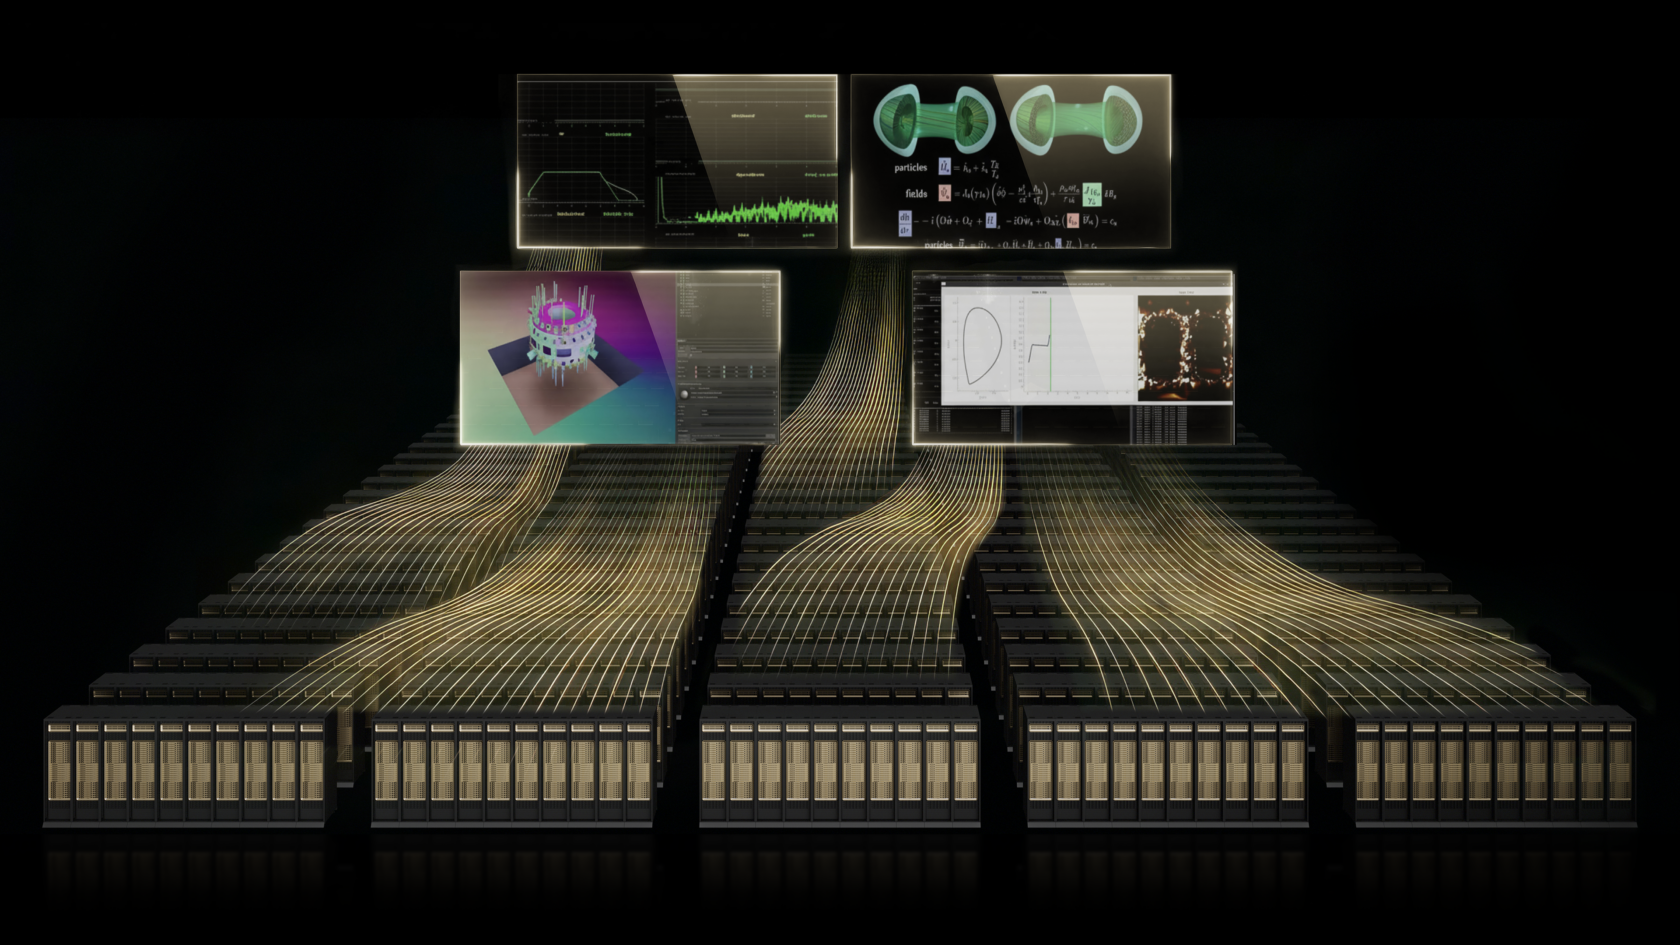
英伟达(NVIDIA)在官方博客中详细解读了用于生产智能的新型基础设施"AI工厂"的理念[1]。正如发电厂曾经产出电力,AI工厂被定位为将电力转化为"token"、全天候持续生产智能的设施[1]。该公司主张,性能要用每瓦特的token数量和每个token的成本来衡量,而这种效率会直接转化为收益[1]。
什么是AI工厂
英伟达表示,AI已不再只是软件,而是成为支撑社会运转、不可或缺的基础设施[1]。处于这一转变中心的,正是AI工厂(专门用于生产智能的大规模计算基础)[1]。正如工业时代发电厂把能源转化为电力,英伟达把AI工厂定位为将能源转化为token(推理模型与智能体进行处理时的生产单位)的设施[1]。
这里看重的指标是每秒的token数、每瓦特的token数、每个token的成本、利用率以及运行时间[1]。英伟达称,每瓦特的性能会直接关系到收益,而每个token的成本决定了每一座AI工厂的经济性[1]。每座设施都会从模型、算力、网络、内存、软件、存储、电力到散热进行整体优化,以持续输出智能[1]。
智能体AI改变了工作负载的内容
AI工厂面向的是远不止回答单个提示的常态化推理(inference,已训练的AI实际给出答案的处理过程)[1]。智能体AI(自主编排步骤并推进工作的AI)不仅承担推理与规划,还包括搜索、调用工具、获取数据、编写代码以及实际操作[1]。这些系统甚至会创建专属的子智能体、学习特定领域工具的用法,使处理变得更长、更深,计算负载也更高[1]。
要支撑这些工作,需要把高速内存、用于保存上下文的存储、用于协同的网络、负责调度的软件以及负责执行的CPU,与加速算力组合在一起[1]。英伟达表示,让整个工作流不间断地运转才是决定性能的关键,并把推理形容为如今贯穿整台机器的"实时调度"挑战[1]。
竞争力以每瓦特性能来衡量
英伟达主张,衡量AI工厂竞争力的最终标尺已变成"每瓦特的性能"[1]。该公司援引调研机构SemiAnalysis的InferenceX基准测试称,其Blackwell Ultra世代的GPU把每个token的成本压到了最低[1]。
具体数据也一并公布。据英伟达介绍,采用Blackwell Ultra的"NVIDIA GB300 NVL72"系统,每兆瓦可生成的token数量比上一代最高多出50倍,相比此前的Hopper世代可把每个token的成本降至三十五分之一[1]。长文本推理以及大量推理处理的调度,由名为"NVIDIA Dynamo"的软件基础来完成,承担着保持高利用率的角色[1]。在下一代"NVIDIA Vera Rubin"平台上,英伟达称这一趋势会进一步推进,通过"LPX"把每瓦特性能最高提升至35倍,并借助更深入的全栈优化进一步压低token成本[1]。
从芯片走向整体设计,由合作伙伴与数字孪生支撑
英伟达表示,从GPU起步的这项工作,已扩展为包含加速算力、高速互连、液冷系统、推理软件、自主智能体以及参考架构的"全栈AI工厂"[1]。为了把这些带入企业数据中心,该公司与思科、戴尔、慧与(HPE)、联想、美超微(Supermicro)等系统合作伙伴紧密协作[1]。英伟达提到,自家也在运营面向企业的AI工厂,有数百个自主智能体协助其工程与运维团队,并以此作为实际例证[1]。
该公司还指出,建设大规模设施仅靠优化算力是不够的[1]。"NVIDIA DSX"参考设计旨在以每兆瓦最低的token成本来构建吉瓦级的AI工厂[1]。"NVIDIA Omniverse DSX Blueprint"则使用连接设施、硬件与软件的数字孪生(把现实中的设施在虚拟空间中再现的技术),支持从建设前的设计验证到投运后的运营改进[1]。英伟达总结称:上一次工业革命把能源转化为劳动,而这一次把能源转化为智能[1]。
英伟达还表示,将由创始人兼CEO黄仁勋在定于台北时间6月1日上午11点举行的"NVIDIA GTC Taipei at COMPUTEX"主题演讲中,详细讲述这些AI工厂的整体图景[2]。
总结
英伟达给出的,是把数据中心从"存放文件的地方"重新理解为"生产token的工厂"的思路。以每瓦特的token数量和每个token的成本为核心,不只看单颗芯片,而是把电力与散热也纳入其中进行整体优化来衡量竞争力——这一思路显然是着眼于生成式AI普及所带来、不断膨胀的算力需求。6月1日的主题演讲会披露多少具体内容,将是下一个看点。
来源:https://blogs.nvidia.com/blog/ai-factories-the-new-infrastructure-of-intelligence/
来源:https://blogs.nvidia.com/blog/nvidia-gtc-taipei-computex-2026-news/



























