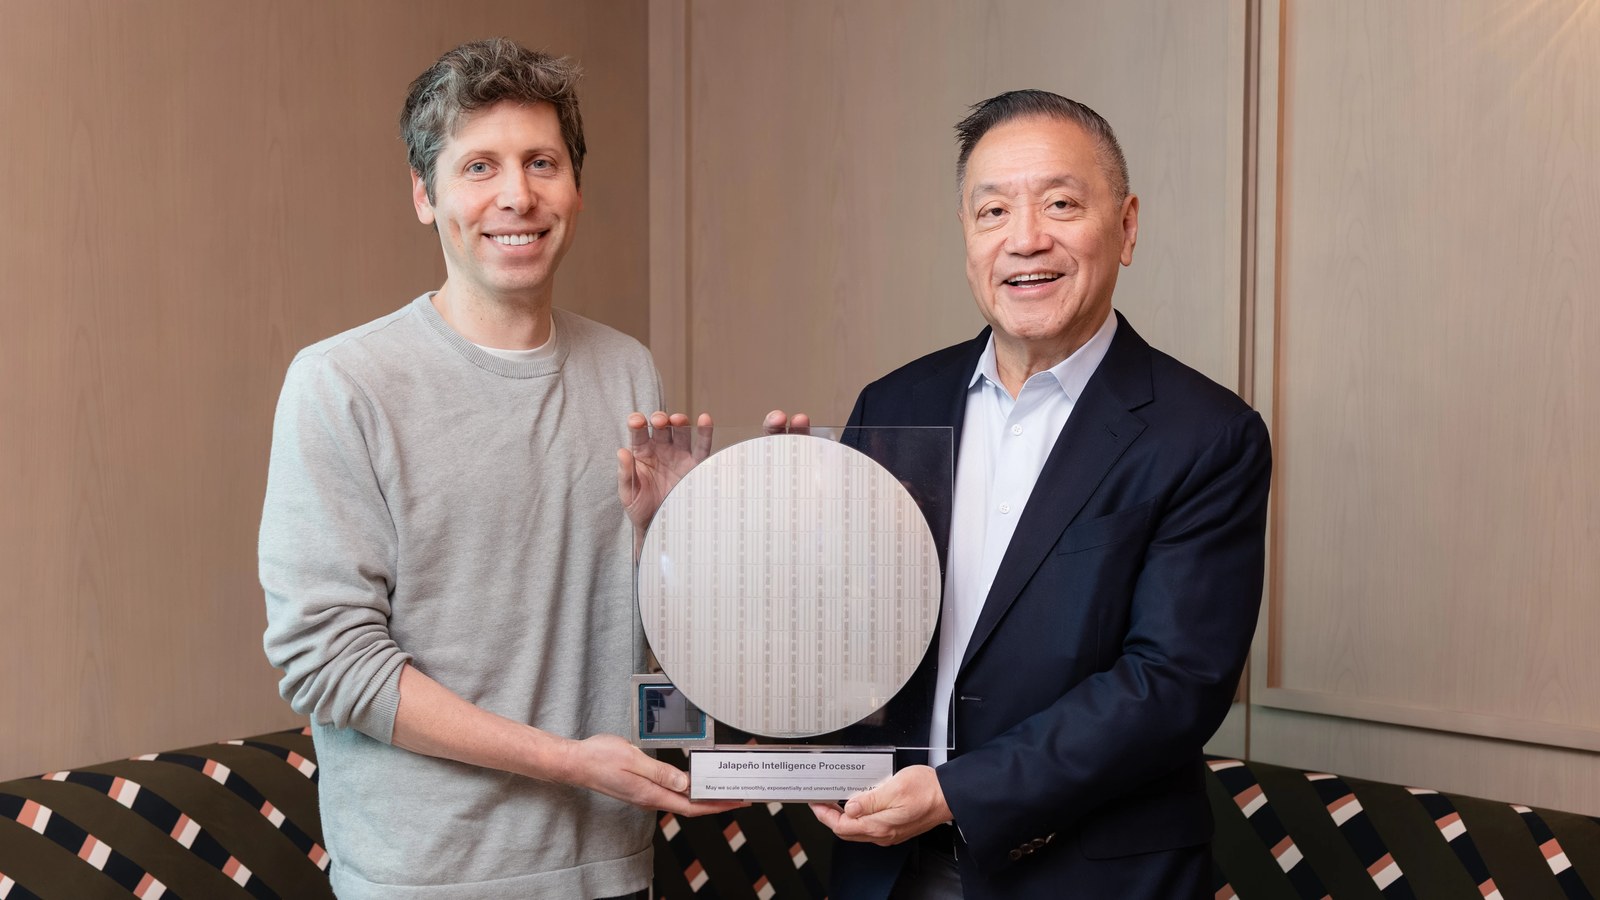
OpenAI 攜手半導體大廠博通(Broadcom),發表了首款自研 AI 晶片「Jalapeño」[1]。這是一款專為 ChatGPT 等服務中回應使用者提問的「推論」處理而打造的專用晶片,兩家公司表示從設計到製造僅花費 9 個月[1][2]。早期測試顯示,其每瓦效能有望大幅超越目前最先進的水準,並計畫於 2026 年底開始在資料中心大規模部署[1]。
「Jalapeño」是怎樣的一款晶片
Jalapeño 是 OpenAI 稱為「Intelligence Processor(智慧處理器)」的自研 AI 加速器(專門用於加速 AI 運算的晶片)[1]。這裡所說的推論,指的是訓練完成的 AI 模型針對使用者的問題組織出答案的過程,ChatGPT 生成文字便屬於這個環節[3]。
其特點在於,它並非由既有 GPU 改造而來,而是為大型語言模型(LLM)的推論從零設計[1]。OpenAI 依據自身對模型、核心程式與服務系統的理解來決定晶片架構,力求減少資料搬移、平衡運算、記憶體與網路資源,藉此逼近理論峰值的實際效能[1]。這款晶片是在博通高層將其交給 OpenAI 執行長 Sam Altman 與總裁 Greg Brockman 時正式亮相[1]。
9 個月開發與效能展望
OpenAI 表示,從設計啟動到製造流片(tape-out,即確定量產設計)僅花 9 個月,並將其定位為高效能半導體領域最快的 ASIC(特殊應用積體電路)開發週期之一[1][2]。設計與最佳化的一部分動用了 OpenAI 自家的 AI 模型,並表示由 AI 協助晶片設計可縮短開發週期[1]。
效能方面,放置於實驗室的工程樣片,已在以量產為目標的頻率與功耗下執行實際的機器學習工作負載[1]。據稱其上正執行包括「GPT-5.3-Codex-Spark」在內的模型[1]。作為早期測試結果,該公司表示每瓦效能有望大幅超越目前最先進的水準[1]。不過最終效能仍在量測中,詳盡的技術報告預計於數月內公布,目前的數字僅為 OpenAI 單方面的說法[1]。
製造方面由博通負責晶片實作與網路技術(包含名為 Tomahawk 的通訊晶片),Celestica 則負責電路板、機架與整體系統的組裝[1][2]。
支撐 ChatGPT 的「全端」策略
OpenAI 將這次的晶片定位為「全端(full-stack)」策略的一環——連模型與產品底層的基礎設施也由自家設計[1]。透過讓從晶片架構到核心程式、記憶體、網路、工作排程乃至部署機制都朝同一目標最佳化,以更快、更省、更穩定地執行自家模型[1]。
推論是 AI 觸及使用者的接點,該公司認為成本、速度與可靠性的改善,會直接轉化為 ChatGPT 回應更快、開發者使用 API 的費用更低[1]。Jalapeño 被視為跨越多個世代的運算平台的第一步,將以 2026 年底的初期部署為起點,與包含微軟在內的資料中心夥伴一同以吉瓦級規模逐步擴展[1][2]。
對 NVIDIA 獨大格局的一記衝擊
主流媒體將這次發表解讀為緩解對 AI 半導體市占遙遙領先的 NVIDIA 依賴的舉措[3]。在 Google、Amazon 等大廠紛紛推進自研晶片之際,OpenAI 也憑藉擁有自家專用半導體,加入了讓運算資源採購多元化、壓低成本的潮流[3]。不過,Jalapeño 要實現量產並在真實運作中證明實力仍需時日,公布的效能優勢能否在現場重現,仍有待後續驗證[1][3]。
總結
OpenAI 與博通發表的「Jalapeño」,是該公司首款專為 LLM 推論打造的自研 AI 晶片。從設計到製造僅花 9 個月,號稱每瓦效能超越目前最先進水準,但最終效能仍在量測,詳盡報告尚需數月。博通與 Celestica 支撐生產,並計畫自 2026 年底起與微軟等夥伴以吉瓦級規模部署。它是 OpenAI 自行設計基礎設施這一全端策略的象徵,能在多大程度上撼動 NVIDIA 獨大的 AI 半導體格局,將是今後的觀察重點。
來源:https://openai.com/index/openai-broadcom-jalapeno-inference-chip