

NVIDIA 在官方部落格公開了 Vera 的設計理念與導入案例,並將其定位為面向 AI 代理(AI Agent)時代的全新 CPU 類別[1]。Vera 標榜是「面向大規模環境的單執行緒效能最強 CPU」,88 個核心可同時以最高效能運作,在模擬代理執行的負載測試中,單核效能達到 x86 的 1.8 倍。AI 搜尋公司 Perplexity 也正評估將其導入即將上線的正式系統。
為什麼代理時代需要單執行緒效能
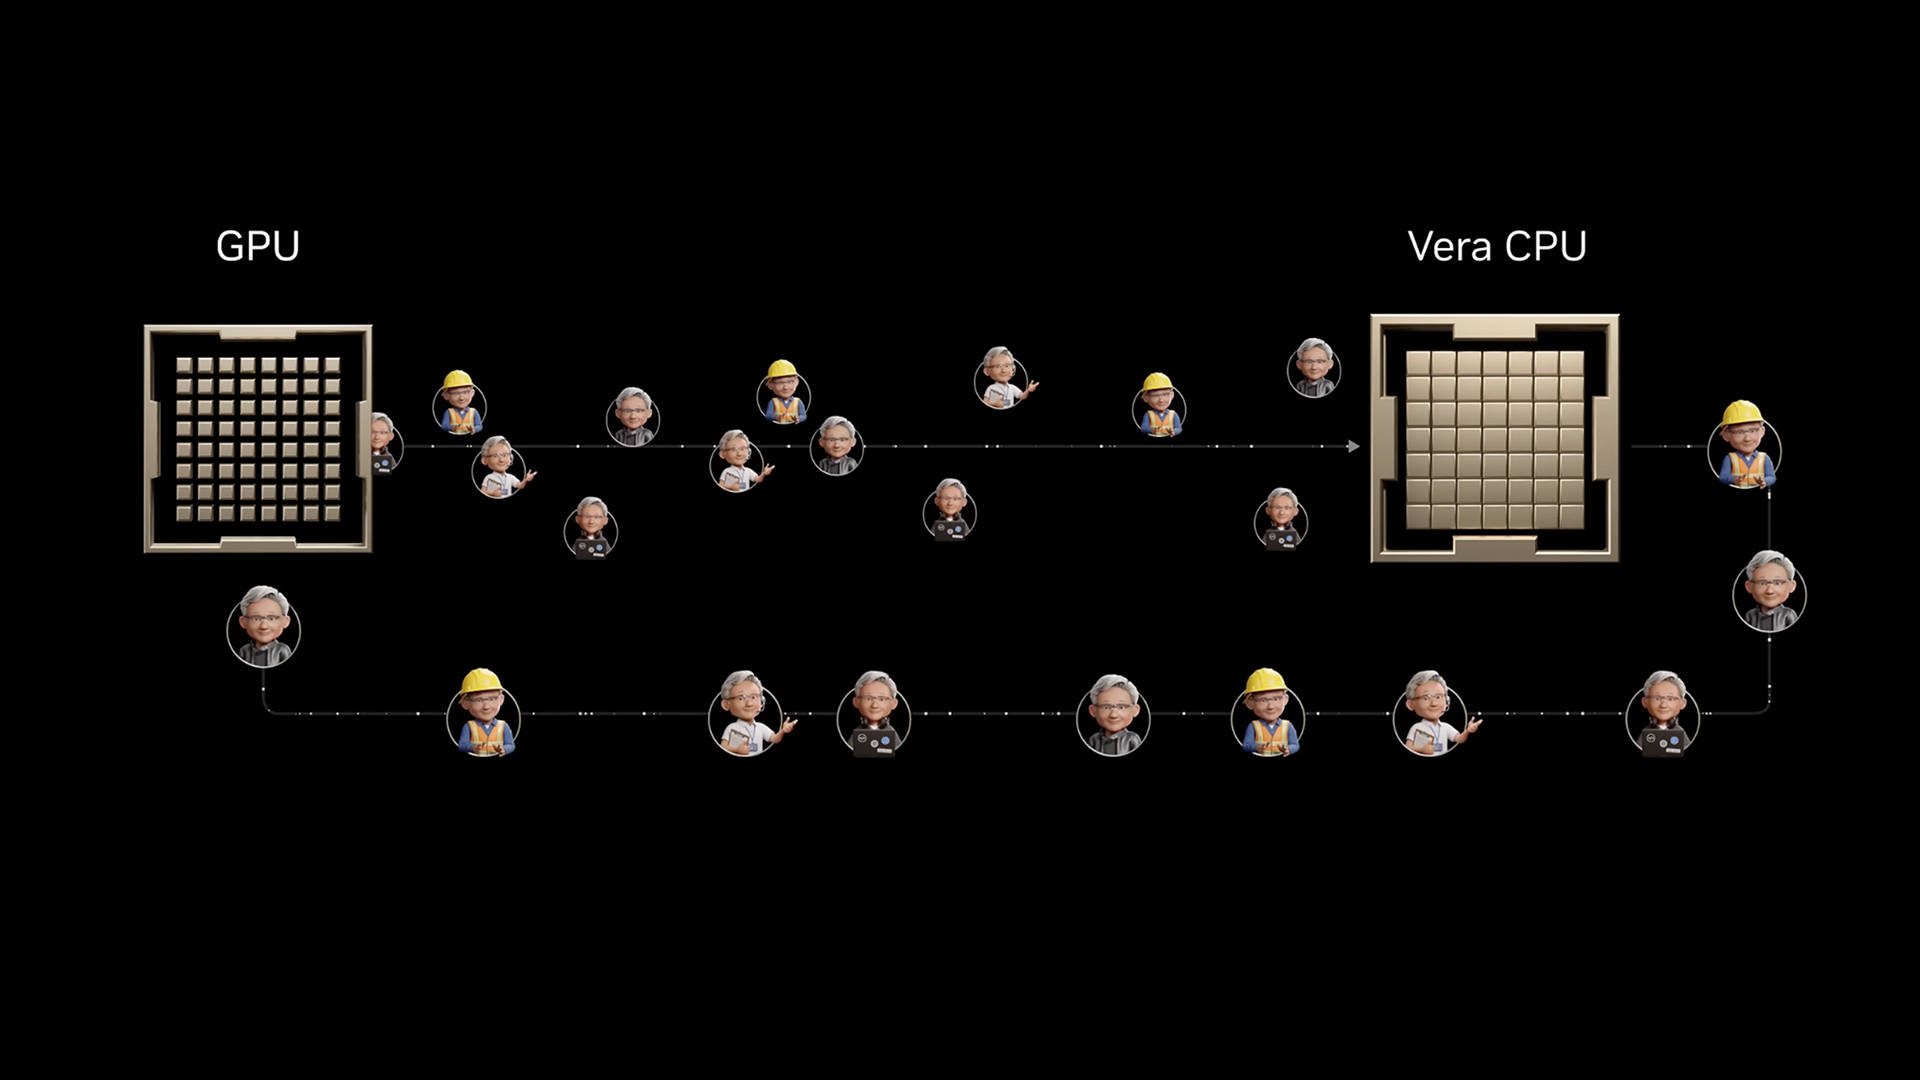
AI 代理的運作方式是一個迴圈:模型思考下一步,CPU 執行工具呼叫、程式碼執行、資料處理等實際工作,結果再回饋給模型做出下一個判斷。每一步都依賴前一步的結果,屬於循序處理,因此無論核心數增加多少,單一迴圈的推進速度都不會變快。決定迴圈速度的,始終是單核處理效能[1]。
另一方面,NVIDIA 指出現有的資料中心 CPU 並未針對這類用途最佳化。雲端運算普及以來,CPU 廠商一直朝著降低「每個可出租核心的成本」方向演進:為了增加核心數量,用於讓核心高速運作的高效能記憶體互連等晶片面積遭到壓縮,而小晶片(chiplet)架構的普及,又帶來各核心無法完整存取整顆晶片記憶體效能的「小晶片稅」[1]。
從 AI 工廠(AI Factory)的角度來看,CPU 的遲緩會直接轉化為昂貴 GPU 的等待時間。代理的工作完成得越快,GPU 的使用率與收益就越高,因此需要一顆所有核心都能毫不妥協地發揮單執行緒效能的 CPU——這正是 NVIDIA 的主張[1]。
Olympus 核心與 1.2TB/s 記憶體頻寬
Vera 的核心是 NVIDIA 自主設計的 CPU 核心「Olympus」,每時脈週期指令數(IPC)較上一代 NVIDIA Grace 提升 50%。記憶體方面採用 LPDDR5X,以不到 40 瓦的記憶體功耗實現最高 1.2TB/s 的頻寬;單晶片(monolithic)運算裸晶搭配 3.4TB/s 的核心間頻寬,即使 88 個核心全部滿載,資料供給也不會成為瓶頸。NVIDIA 表示這一核心間頻寬是其他資料中心 CPU 的 3 倍[1]。
結果是,在模擬代理執行的高負載 CPU 工作負載中,Vera 展現了 x86 的 1.8 倍的持續單核效能。工具呼叫、程式碼執行、資料處理、結果驗證等各個步驟的提速不斷累積,最終提升整個 AI 工廠的處理量[1]。
Perplexity 實測 1.5 倍,資料處理最高 6 倍
導入案例也相當具體。Perplexity 以日常運行的代理任務對 Vera 進行驗證:複製程式碼儲存庫並在沙箱中執行測試套件的真實編碼工作流程,比 x86 快約 1.5 倍完成;沙箱並行啟動速度最高提升 1.9 倍。該公司目前正評估在即將上線的正式系統中部署 Vera[1]。
在資料處理方面,合作夥伴的實測顯示:與 Starburst 的大規模 SQL 分析提速 3 倍,與 Redpanda 的即時串流處理延遲最多降至六分之一,比較對象皆為主流 x86 伺服器 CPU。Vera 同時也是 GPU 複合系統「NVIDIA Vera Rubin」中承載 GPU 的 CPU,並被用於儲存處理器「BlueField-4 STX」,因此整個 AI 工廠可以在同一套架構與同一套工具鏈上運作,這一點也被特別強調[1]。
預告下一代 CPU「Rosa」與新核心「Rigel」
NVIDIA 也表明 CPU 路線圖將持續推進。下一代 CPU「Rosa」將搭載全新設計的「Rigel」核心。Rigel 屬於 Arm v9.2 世代,在維持與 Olympus 相同晶片面積的前提下,透過改進指令供給、擴大 L2 快取以及更有效率的記憶體處理,進一步提升單核效能[1]。
總結
NVIDIA 公開的 Vera 設計理念,象徵著從核心數量競賽轉向「讓所有核心都全速運作」。憑藉高 IPC 的 Olympus 核心、1.2TB/s 記憶體頻寬與 3.4TB/s 核心間頻寬,Vera 在代理處理中實現了 x86 的 1.8 倍單核效能,並有 Perplexity 編碼工作流程 1.5 倍、SQL 分析 3 倍等實測數據佐證。在代理成為主角的時代,資料中心評價 CPU 的標準本身或許正在改變。
來源:https://blogs.nvidia.com/blog/nvidia-vera-max-single-threaded-cpu-at-scale/



























