
Anthropic 於6月30日宣布,將自7月1日起重新部署其最新模型「Claude Fable 5」[1]。此舉是在美國政府解除對該模型的出口管制之後作出的,全球使用者可再次於 Claude Platform、Claude.ai、Claude Code 及 Claude Cowork 上使用該模型[1]。日本媒體也報導了管制解除後該模型的回歸[2]。
從出口管制到重新部署
Fable 5 與更高階的「Mythos 5」於6月9日發布,但美國政府在6月12日對這兩款模型實施了出口管制[1]。由於針對外國國民的限制立即生效,且當時沒有可靠的即時國籍查核方式,Anthropic 對所有使用者暫停了這兩款模型的存取[1]。該指令源於一份報告:Amazon 的研究人員發現了一種繞過 Fable 5 安全機制的方法,誘導其辨識軟體漏洞,並在其中一例中生成了示範如何利用該漏洞的程式碼[1]。不過,Anthropic 自身的測試證實,包括 Claude Opus 4.8、GPT-5.5、Kimi K2.7 在內、能力更弱的現有模型也能辨識相同的漏洞並生成相同的示範[1]。
攔截率超過99%的全新安全防護
在重新部署時,Anthropic 訓練了一個針對上述繞過手法的改良版安全分類器[1]。該公司表示,此分類器目前已能在超過99%的情況下攔截該特定手法[1]。當請求被攔截時會通知使用者,並改由 Claude Opus 4.8 處理[1]。美國商務部轄下的人工智慧標準與創新中心(CAISI)對新舊防護措施進行了測試,並認同其「極為強大」[1]。與此同時,更強的分類器在日常程式撰寫與除錯時可能更頻繁地誤判正常請求,Anthropic 表示會持續優化[1]。
使用條件與業界通用的越獄評估框架
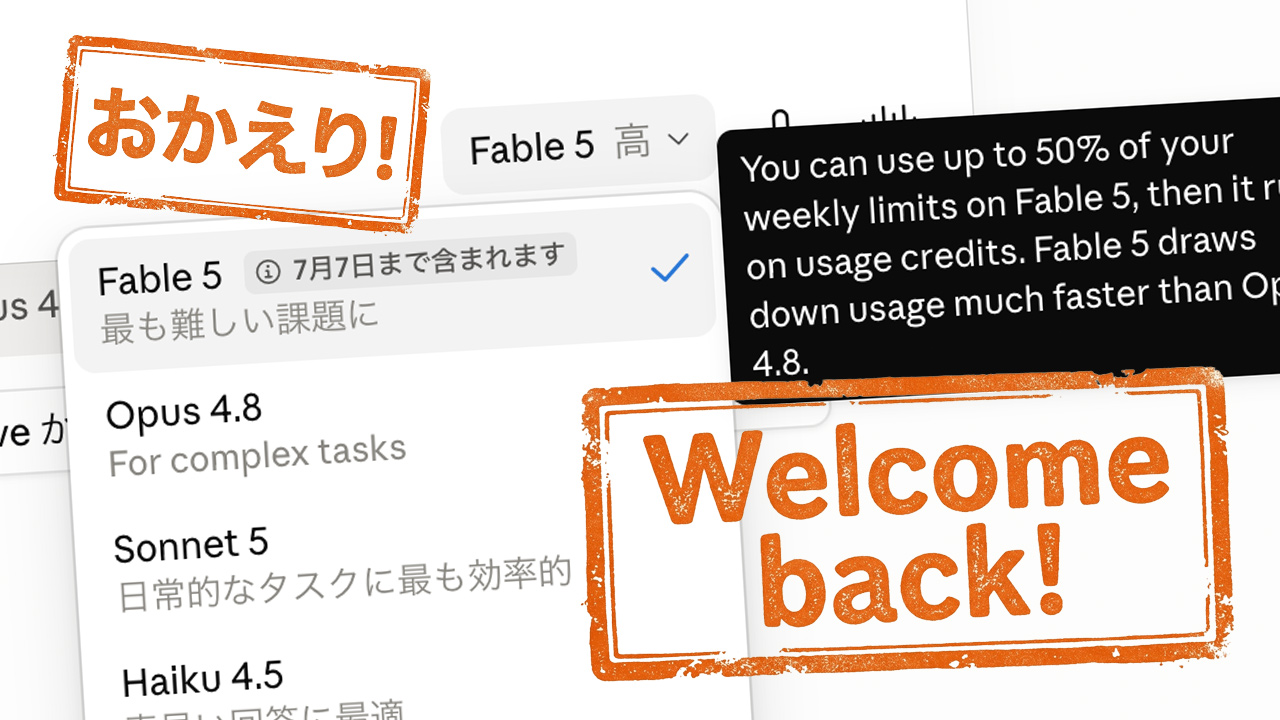
對於 Pro、Max、Team 及部分 Enterprise 方案,截至7月7日 Fable 5 可在每週用量上限的最多50%範圍內使用,之後將透過用量額度提供[1]。AWS、Google Cloud 及 Microsoft Foundry 上的存取也將分階段恢復[1]。Anthropic 另透露,正與 Amazon、Microsoft、Google 等 Glasswing 合作夥伴共同制定一套業界通用框架,用以評估 AI「越獄」(繞過模型安全機制的手法)的嚴重程度[1]。該提案擬從能力提升幅度、提升的適用廣度、武器化的難易度以及可發現性四項標準進行評分[1]。
總結
在因出口管制暫停後僅約三週,Claude Fable 5 便以更強的安全防護重新回歸。這一系列應對措施,作為在前沿 AI 模型的安全性與可用性之間取得平衡、以及政府與業界如何協作的案例,值得關注。



























