

NVIDIA 在官方博客上公开了 Vera 的设计理念与采用案例,并将其定位为面向 AI 智能体时代的全新 CPU 类别[1]。Vera 号称是「面向大规模环境的单线程性能最强 CPU」,88 个核心可同时以最高性能运行,在模拟智能体执行的负载测试中,单核性能达到 x86 的 1.8 倍。AI 搜索公司 Perplexity 也正在考虑将其部署到即将上线的生产系统中。
为什么智能体时代需要单线程性能
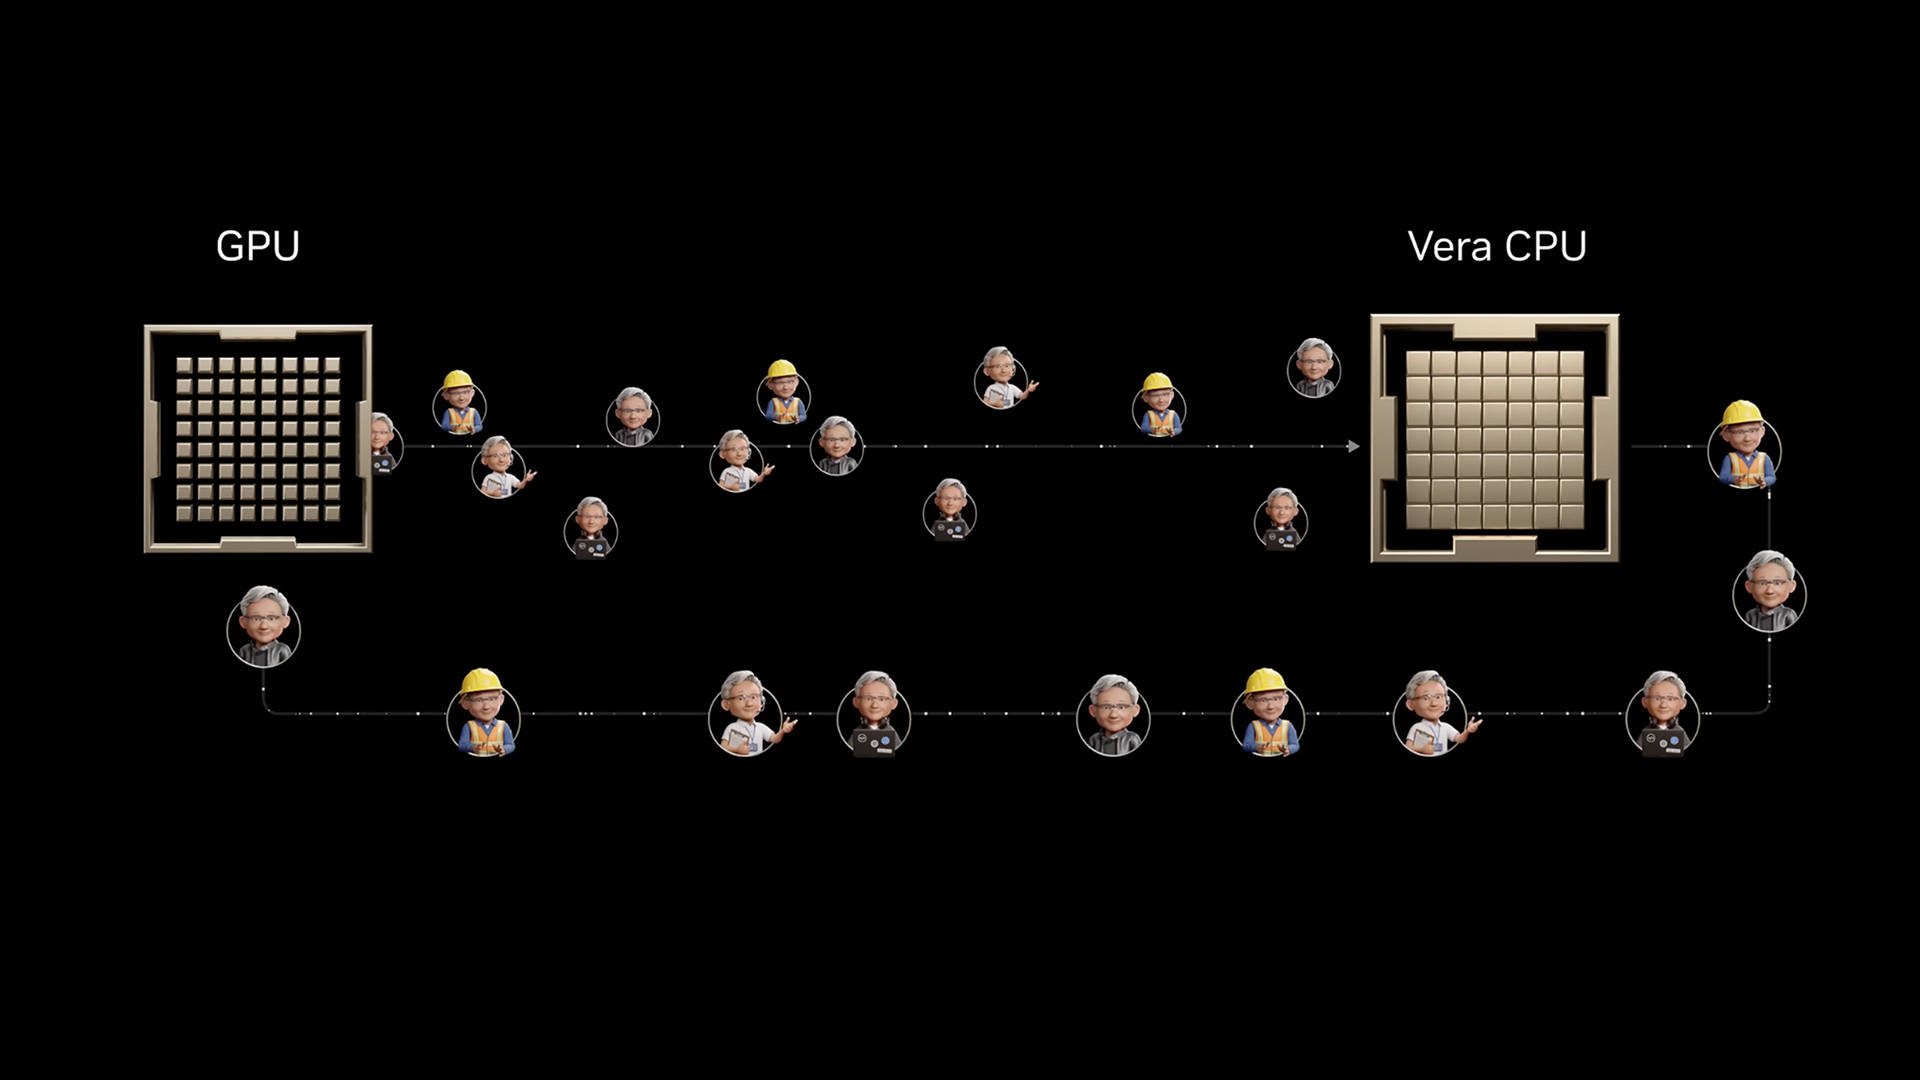
AI 智能体的运行方式是一个循环:模型思考下一步,CPU 执行工具调用、代码运行、数据处理等实际工作,结果再反馈给模型做出下一个判断。每一步都依赖上一步的结果,属于顺序处理,因此无论增加多少核心,单个循环的推进速度都不会变快。决定循环速度的,始终是单核处理性能[1]。
另一方面,NVIDIA 指出现有的数据中心 CPU 并未针对这类用途进行优化。云计算普及以来,CPU 厂商一直朝着降低「每个可出租核心的成本」方向演进:为了增加核心数量,用于让核心高速运行的高性能内存互连等硅片面积被压缩,而小芯片(chiplet)架构的普及又带来了各核心无法完整访问整颗芯片内存性能的「小芯片税」[1]。
从 AI 工厂(AI Factory)的角度看,CPU 的迟缓会直接转化为昂贵 GPU 的等待时间。智能体的工作完成得越快,GPU 的利用率和收益就越高,因此需要一颗所有核心都能毫不妥协地发挥单线程性能的 CPU——这正是 NVIDIA 的主张[1]。
Olympus 核心与 1.2TB/s 内存带宽
Vera 的核心是 NVIDIA 自主设计的 CPU 核心「Olympus」,每时钟周期指令数(IPC)比上一代 NVIDIA Grace 提升 50%。内存方面采用 LPDDR5X,以不到 40 瓦的内存功耗实现最高 1.2TB/s 的带宽;单片式(monolithic)计算裸片配合 3.4TB/s 的核间带宽,即使 88 个核心全部满载,数据供给也不会成为瓶颈。NVIDIA 表示这一核间带宽是其他数据中心 CPU 的 3 倍[1]。
结果是,在模拟智能体执行的高负载 CPU 工作负载中,Vera 展现了 x86 的 1.8 倍的持续单核性能。工具调用、代码执行、数据处理、结果验证等各个步骤的提速不断叠加,最终提升整个 AI 工厂的处理量[1]。
Perplexity 实测 1.5 倍,数据处理最高 6 倍
采用案例也十分具体。Perplexity 用日常运行的智能体任务对 Vera 进行了验证:克隆代码仓库并在沙箱中运行测试套件的真实编码工作流,比 x86 快约 1.5 倍完成;沙箱并发启动速度最高提升 1.9 倍。该公司目前正考虑在即将上线的生产系统中部署 Vera[1]。
在数据处理方面,合作伙伴的实测显示:与 Starburst 的大规模 SQL 分析提速 3 倍,与 Redpanda 的实时流处理延迟最多降至六分之一,对比对象均为主流 x86 服务器 CPU。Vera 同时也是 GPU 复合系统「NVIDIA Vera Rubin」中承载 GPU 的 CPU,并被用于存储处理器「BlueField-4 STX」,因此整个 AI 工厂可以在同一套架构和同一套工具链上运行,这一点也被着重强调[1]。
预告下一代 CPU「Rosa」与新核心「Rigel」
NVIDIA 还表明 CPU 路线图将持续推进。下一代 CPU「Rosa」将搭载全新设计的「Rigel」核心。Rigel 属于 Arm v9.2 世代,在保持与 Olympus 相同硅片面积的前提下,通过改进指令供给、扩大 L2 缓存以及更高效的内存处理,进一步提升单核性能[1]。
总结
NVIDIA 公开的 Vera 设计理念,标志着从核心数量竞赛转向「让所有核心都全速运行」。凭借高 IPC 的 Olympus 核心、1.2TB/s 内存带宽和 3.4TB/s 核间带宽,Vera 在智能体处理中实现了 x86 的 1.8 倍单核性能,并有 Perplexity 编码工作流 1.5 倍、SQL 分析 3 倍等实测数据支撑。在智能体成为主角的时代,数据中心评价 CPU 的标准本身或许正在改变。
来源:https://blogs.nvidia.com/blog/nvidia-vera-max-single-threaded-cpu-at-scale/



























