

在 Microsoft Build 大会上,英伟达与微软宣布扩大合作,把运行智能体 AI 所需的各个要素一站式整合起来[1]。英伟达创始人兼首席执行官黄仁勋通过直播从台北参加了萨提亚·纳德拉的主题演讲,展示了贯通 Windows 设备、Azure 云端到本地环境的统一技术栈[1]。本次合作的重点,是在 Microsoft Foundry 上提供英伟达的开放模型,以及把安全的运行环境集成进开发工具 GitHub Copilot[1]。
Microsoft Build 上展示的合作全貌
英伟达认为,智能体 AI 仅靠优秀的模型还不够,还需要高速的硬件、安全的运行环境(运行时)、响应迅速的数据层,以及为长时间推理(已训练的 AI 实际得出答案的处理过程)而调优的模型,四者齐备才能成立[1]。本次扩大合作的目标,是让开发者无论在 Windows 设备、Azure 云端还是本地,都能用上这 4 个要素[1]。
主题演讲提到的具体方向包括面向 Windows 的 RTX Spark 与 DGX Station for Windows、用 GPU 加速的 Microsoft Fabric、在 Microsoft Foundry 上提供英伟达开放模型、把 NVIDIA OpenShell 集成进 GitHub Copilot,以及下一代 AI 工厂[1]。其中,企业和开发者可以立即上手的云端建设推进得最为明显[1]。
英伟达的开放模型登陆 Microsoft Foundry
在 Microsoft Foundry 的智能体服务中,除了英伟达、Anthropic、OpenAI 的模型外,还能使用面向特定任务的“Hermes special agents”,企业可以在 Azure 上构建内置身份验证和治理(管理管控)的智能体[1]。Anthropic 的 Claude 已能在 Azure 上的英伟达 GB300 Blackwell Ultra 系统上原生运行,预计数周内向客户开放[1]。
英伟达将于本月在 Foundry 的托管算力上,提供面向编程、研究、业务处理等长时间运行智能体的全新开放推理模型“Nemotron 3 Ultra”[1]。同时还推出面向语音识别的“Nemotron 3.5 ASR”和用于安全判定的“Nemotron 3.5 Content Safety”[1]。开发者可以把 Nemotron 与前沿模型和本地模型组合使用,按每项处理优化成本与质量[1]。
开放模型的范围也扩展到物理 AI 和科学领域[1]。面向物理 AI 的全面开放模型“Cosmos 3”,以及可用于企业预测和风险分析的 AI 气象模型“Earth-2”,通过 Foundry 等渠道提供[1]。此外,还提供用于搭建生产级智能体的开源基础“NVIDIA Agent Toolkit”和“NemoClaw”蓝图(设计图),让智能体能把 cuDF、cuOpt、AI-Q、NeMo 等 CUDA-X 库作为专用技能调用[1]。
GitHub Copilot 获得安全运行环境“OpenShell”
随着智能体从编程辅助走向自主执行,就需要在不交出真实权限的前提下完成实际工作的机制[1]。英伟达把应对这一课题的运行环境“NVIDIA OpenShell”集成进了 GitHub Copilot[1]。
在 OpenShell 中,每个智能体都在隔离的容器(独立的执行区域)内运行,对外通信在到达文件、网络、凭据之前都会按策略逐一检查[1]。策略以代码形式编写,可在代码仓库中进行版本管理,并能在运行中更新[1]。OpenShell 采用 Apache 2.0 开源协议,不依赖特定模型,可适配本地、混合和云端等各类环境[1]。
用 GPU 为 Microsoft Fabric 数据仓库加速
由于智能体 AI 以数据为燃料运行,对数据的高速访问不可或缺[1]。英伟达的加速计算已集成进 Microsoft Fabric 数据仓库,微软内部基准测试显示,在要求高并发的处理中,SQL 执行相比基于 CPU 的基准最高快 6 倍,相比其他 3 家主要云数据仓库厂商最高快 7 倍[1]。
由此,企业的数据层能够跟上持续查询并推理数据的智能体[1]。英伟达表示,这是两家公司多年合作、从研究到生产一以贯之的成果[1]。
从云端到本地,直至 Windows 设备
合作也延伸到云端之外[1]。微软将让其本地平台“Azure Local”上的“Foundry Local”支持英伟达 RTX PRO 6000 Blackwell Server Edition[1]。与 Nemotron 开放模型组合后,企业可以在本地、混合,以及符合各国监管的主权(在本国境内完结)环境等数据所在之处运行高性能 AI 处理[1]。Azure Local 上的 Foundry Local 还新增支持多节点部署和推理基础“vLLM”[1]。
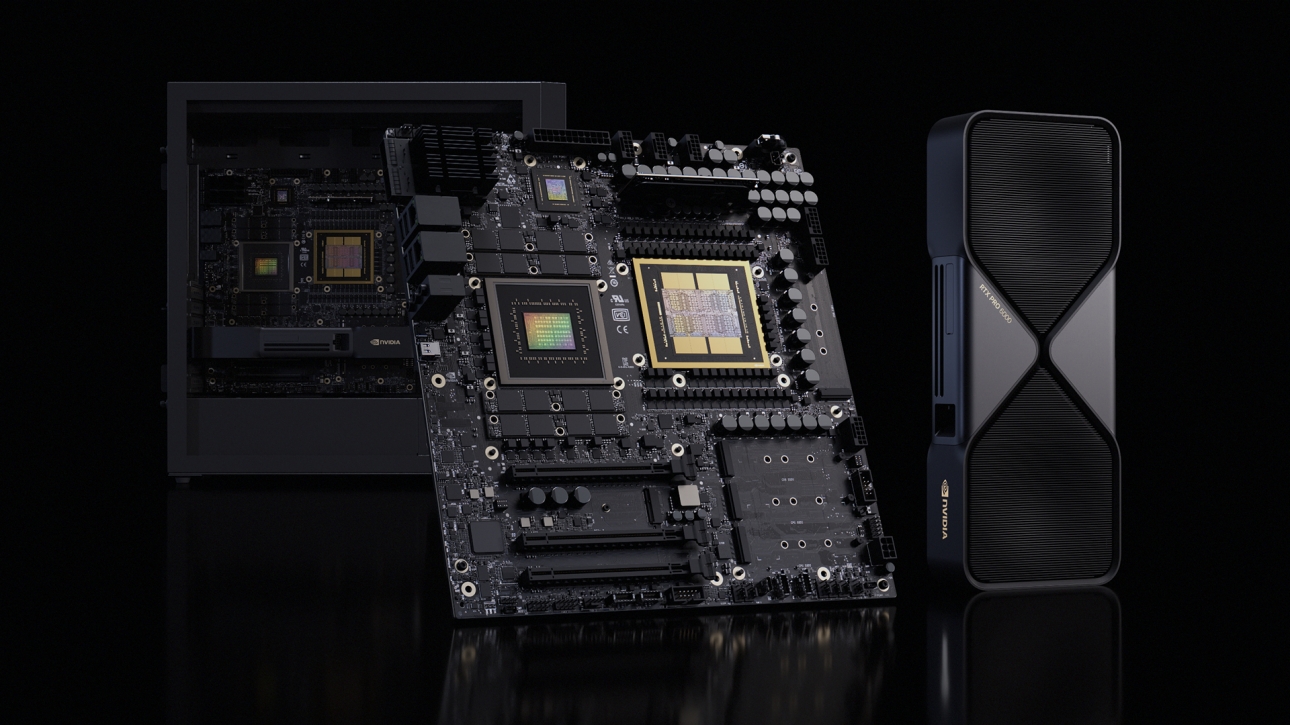
在 Windows 设备方面,面向个人智能体的专用 PC“RTX Spark”和桌边 AI 超级计算机“DGX Station for Windows”都运行前述的 OpenShell,可在本地安全地运行智能体[1]。在物理 AI 领域,微软为开发机器人、自动驾驶汽车等,将英伟达的开源物理 AI 工具集成进 Azure 和“Physical AI Toolchain”[1]。
大规模的底座也开始运转[1]。微软的 AI 工厂“Fairwater Wisconsin”提前投入运行,下一代平台“NVIDIA Vera Rubin”也正式投产[1]。据英伟达介绍,Vera Rubin 可以紧挨 Blackwell 追加部署,把每兆瓦的推理处理量最高提升 10 倍,并大幅降低智能体处理每个 token 的成本[1]。
总结
这次发布可以说是一项让智能体 AI“在哪里运行都行”的合作。借助 Microsoft Foundry 上的开放模型,以及集成进 GitHub Copilot 的 OpenShell,开发者无论在云端还是本地,都更容易构建和运营受到安全管理的智能体。再加上 Fabric 的加速和向 Azure Local 的扩展,英伟达与微软清晰地展现出方向:把模型、运行环境、数据和基础设施各层,从 Windows 到云端串成一条连续的技术栈。
来源:https://blogs.nvidia.com/blog/microsoft-build-windows-local-cloud-devices/



























