

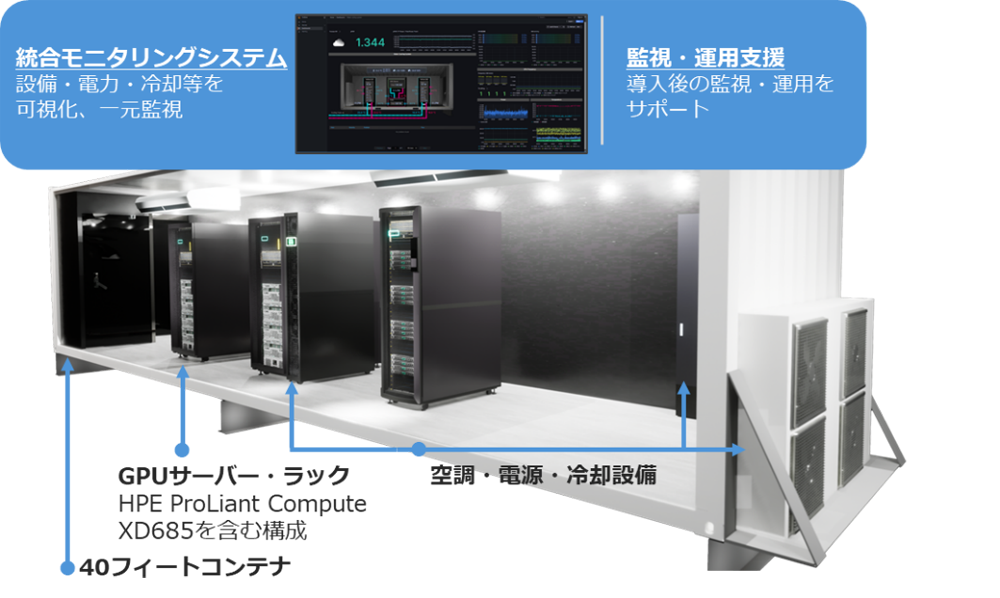
NTTPC 通信、Getworks、Fixstars 三家公司于 9 月 8 日开始提供「水冷 GPU 集装箱 DC-PKG」,将集装箱式数据中心、水冷 GPU 服务器、统一监控与运维支持打包为一体。目标客户是那些希望把 AI 基础设施放在自家场地,却缺乏冷却设施与运维力量的企业。
装在 40 英尺集装箱里的 AI 基础设施
方案的核心是一个 40 英尺集装箱。内部配置包括为水冷 GPU 降温的 CDU 冷水机组、吊顶空调与 InRow 空调,以及用于安防的监控摄像头等设施设备。
算力部分采用 NVIDIA 加速计算服务器,参考配置中列出了搭载 NVIDIA HGX B300 的 HPE ProLiant Compute XD685。防火墙、UTM 等安全设备与网络交换机同样包含在这套方案中。
另一个支柱是监控与运维支持。统一监控可以在一个界面上掌握从集装箱设施到 GPU 服务器的整体状态,并配合性能可视化与运维协助。其目的在于避免故障被发现得太晚、导致昂贵的 GPU 长时间闲置。
功耗持续上升,可供散热的场地却不够
三家公司给出的前提是一个正在发生的转变:企业的 AI 应用正从验证阶段走向正式运行。智能体 AI 与生成式 AI 推理被嵌入实际业务,而服务器性能提升的同时,绝对功耗也在不断增加,具备相应冷却能力的数据中心并不充足。
在此之上还叠加了几重因素:不愿把机密数据交到外部、网络条件受限、大容量数据的通信成本,以及远端设备的运维负担。这些因素共同推动企业把 AI 基础设施放到自家场地。
不过自建会遇到 3 道门槛:缺少面向水冷服务器的设计与施工经验、缺少能充分发挥 GPU 性能的专业人才、以及部署后持续增加的运维压力。三家公司认为,正是这些门槛让不少项目从评估拖到正式运行都迟迟无法推进。三家公司曾在 2025 年 12 月宣布,提升水冷 GPU 服务器运维效率的 PoC 取得成功,这次的方案正是把当时的验证结果落地为产品。
面向机密数据与制造业的具身智能
方案给出了两类典型用途。其一是机密数据的利用:即使在数据与网络要求严格的业务场景中,也能在不把信息带出组织的前提下开展 AI 分析与生成式 AI 应用。
其二是制造业与具身智能领域。举例包括利用设计数据与产线视频,把外观检测、异常检测等 AI 应用推进到正式运行阶段。工厂通常本身就拥有土地与供电设施,放置集装箱的前提条件比较容易满足。
初装费 3 亿日元起,交付最快 8 个月
价格以单独报价为主,但已公开参考数值。配置 1 台 GPU 服务器的小型方案,初装费 3 亿日元起,月费 75 万日元起(均为不含税价格,为 2026 年 8 月 31 日时点的估算)。标准配置的交付周期最快 8 个月,可能因场地条件与设备采购情况而延长。安装集装箱所需的建筑施工与供电施工不包含在方案内,需另行计费。
负责集装箱部分的 Getworks 自 2013 年发布第 1 台集装箱式数据中心以来,截至 2026 年 1 月底已有 300 台建设实绩,其中 20 英尺 270 台、40 英尺 30 台。该公司还有超过 3,000 台服务器、超过 1 万块 GPU 的安装与运维经验。负责软件优化的 Fixstars 则专注于 AI 模型训练与推理的加速。
三家公司接下来计划支持 NVIDIA Vera Rubin 平台等新一代服务器,并向分布式 AI 基础设施与边缘 AI 领域扩展。
总结
「水冷 GPU 集装箱 DC-PKG」的特点,在于把集装箱、水冷 GPU 服务器、统一监控与运维支持整合为一个可以放在自家场地的整体。1 台 GPU 服务器起步就要 3 亿日元并不便宜,但如果考虑到省去分别向多家供应商发包设计、建设与运维的麻烦,以及由此产生的协调时间,判断依据就不只是价格。对于手握无法交给公有云的数据、却又想推进到正式运行的企业来说,可选项又多了一个。



























