SAMSUNGが、米カリフォルニア州サンタクララで開催中のFuture of Memory and Storage(FMS)2026で、次世代の3次元メモリ構想をまとめて示しました。目玉はAIアクセラレーターの真上にHBMを積み上げる「zHBM」と、エッジAI向けの高速NAND「zNAND-O」という2つのコンセプトモデルです。あわせて400層を超える「V10 BV-NAND」も業界で初めて公開されました。
AIアクセラレーターの真上にHBMを積む「zHBM」
現在のHBMは、AIプロセッサの隣に並べて配置するのが当たり前でした。zHBMはこの前提を崩し、HBMをAIアクセラレーターの直上に垂直方向へ積み上げる構造を採ります。プロセッサとメモリの間でデータが移動する距離を物理的に縮めることで、帯域幅と電力効率の両方を引き上げる狙いです。
SAMSUNGが示した想定値はかなり強気です。zHBMを組み込んだ次世代インターフェース構成では、HBM5と比べて約8倍の性能を見込むとしています。さらに次世代のウェハー接合技術を組み合わせた場合、メモリ密度はHBM5の10倍超、エネルギー効率は3倍、熱抵抗は半分以下に下がるという説明です。大容量かつ広帯域の構成では発熱が動作の安定性を直接左右するため、熱抵抗の数字は帯域幅と同じくらい重要な指標になります。
面白いのは、顧客ごとの作り分けを前提にしている点です。メモリとAIアクセラレーターの間に挟まる層へ、顧客固有のIPを組み込めるようにするとしています。汎用部品としてのメモリではなく、アクセラレーターの設計に合わせて仕立てる部材へと性格が変わりつつある、という話でもあります。
エッジAI向けに用意される「zNAND-O」
もう1つのコンセプトモデルがzNAND-Oです。同社のV-NAND技術を土台にした高性能NANDで、現在は4層版と8層版の2種類が開発中とされています。
こちらが向いているのはデータセンターではなく、端末側で実時間の処理をこなすエッジAI環境です。実装面積あたりの効率、入出力性能、低遅延の3点を同時に狙う構成で、その場でデータを取り込みながら推論を回すような用途を想定しています。zHBMがAIの学習と大規模推論を支える側だとすれば、zNAND-Oは現場でAIを動かす側の部材という位置づけになります。
400層超の「V10 BV-NAND」は密度が58パーセント増
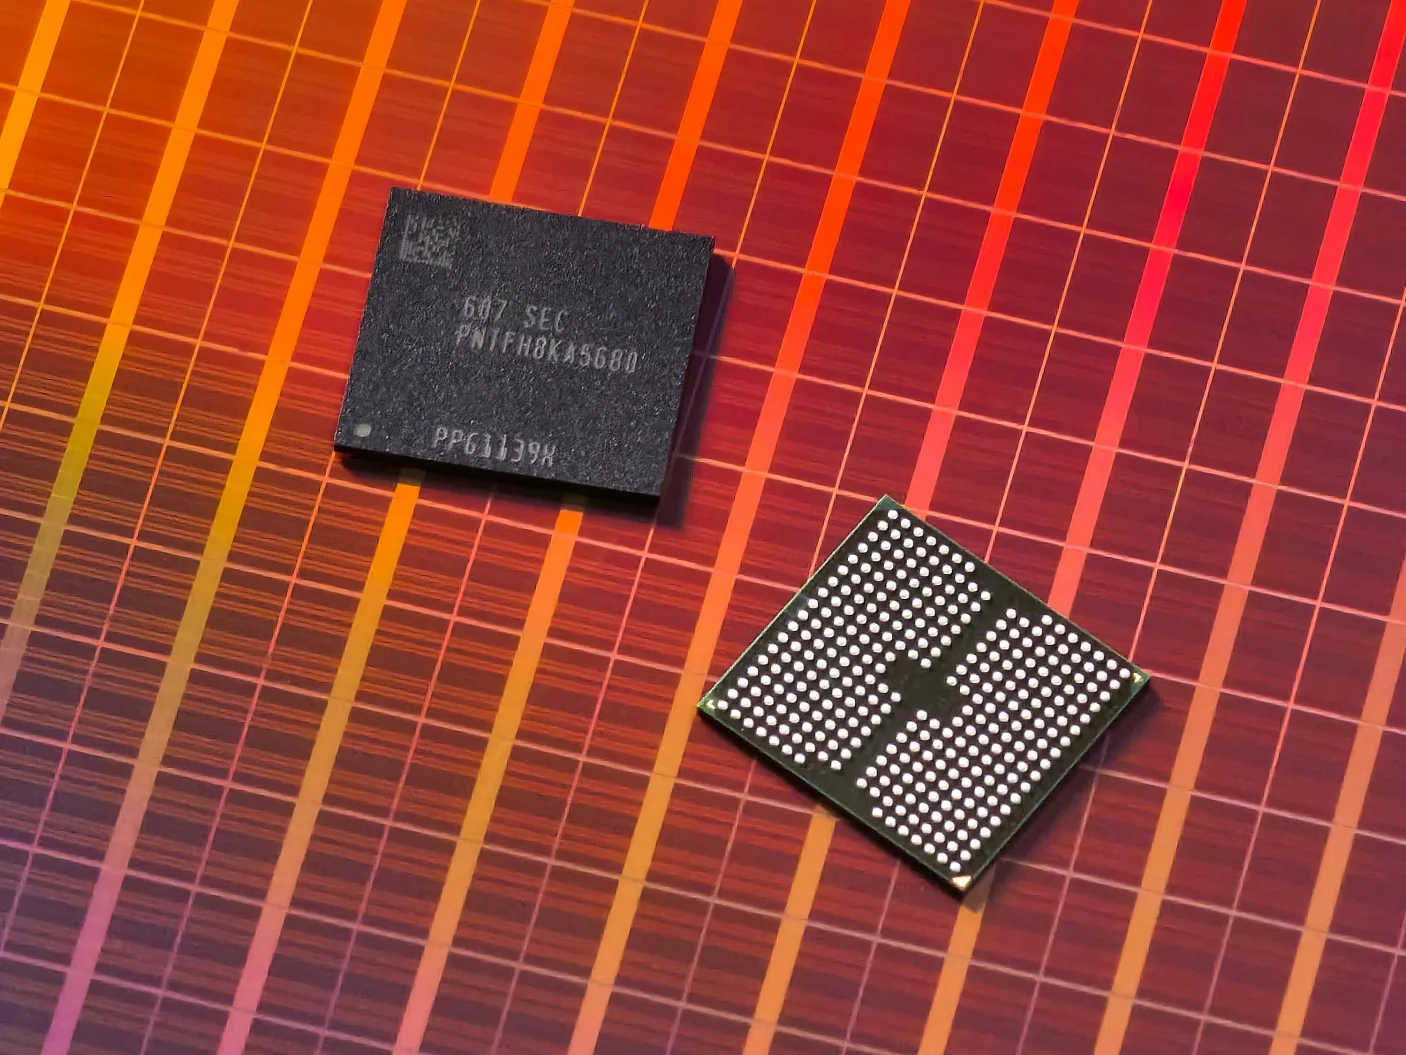
コンセプトモデルと違い、V10 BV-NANDは製品として姿を見せた技術です。新たなBonding V-NAND構造を採用し、400層を超える積層を実現しています。業界でこの構造が公開されたのは今回が初めてです。
鍵になっているのはウェハー接合技術で、メモリセルを積み上げる工程にこれを適用した結果、前世代のV9と比べてメモリ密度がおよそ58パーセント高まったとしています。層数が増えただけでなく、読み出し、書き込み、入出力の各性能も前世代を上回るとのことです。
SAMSUNGが最初のV-NANDを発表したのは2013年のFlash Memory Summitでした。それから13年を経て、積層方式そのものを接合技術で置き換える段階に入ったことになります。
HBM4EからLPDDR5X-PIMまで並べたロードマップ
会場ではコンセプトモデル以外にも、HBM4E、HBM5、LPDDR5X-PIM、そしてエンタープライズ向けSSDのPM1763やBM1773といった製品群が並びました。約30種類の技術を展示するブースは、AIクラウドサーバーを模した造りになっています。
HBMまわりでは、1c DRAMと4ナノメートルのベースダイを使ったHBM4の量産を2026年2月に業界で初めて開始し、続く5月にはHBM4Eのサンプル出荷にも一番乗りしたと説明しています。LPDDR5X-PIMは、メモリ内部で演算を行うPIM(Processing In Memory)をLPDDR系に持ち込んだもので、この組み合わせも業界初とされています。データを動かす回数そのものを減らして、転送と電力の両方を節約する考え方です。
基調講演はフラッシュ製品・技術部門を率いるJin-Yub Lee氏と、DRAM設計チームのプロジェクトリーダーであるKyungryun Kim氏が担当しました。メモリ、ファウンドリー、先端パッケージングを社内に抱える総合デバイスメーカーとして、設計から量産までを一括で引き受ける体制を前面に出しています。
まとめ
FMS 2026でSAMSUNGが示したのは、AIアクセラレーターの真上にHBMを積むzHBM、エッジAI向けのzNAND-O、そして400層超のV10 BV-NANDという3本柱でした。いずれもメモリを平面的に並べる発想から離れ、縦方向にどう積み、どう接合するかへ主戦場が移っていることを示しています。HBM5の8倍という数字が実機でどこまで再現されるかは今後の課題ですが、AIインフラの性能をメモリ側から押し上げる競争は当面続きそうです。