

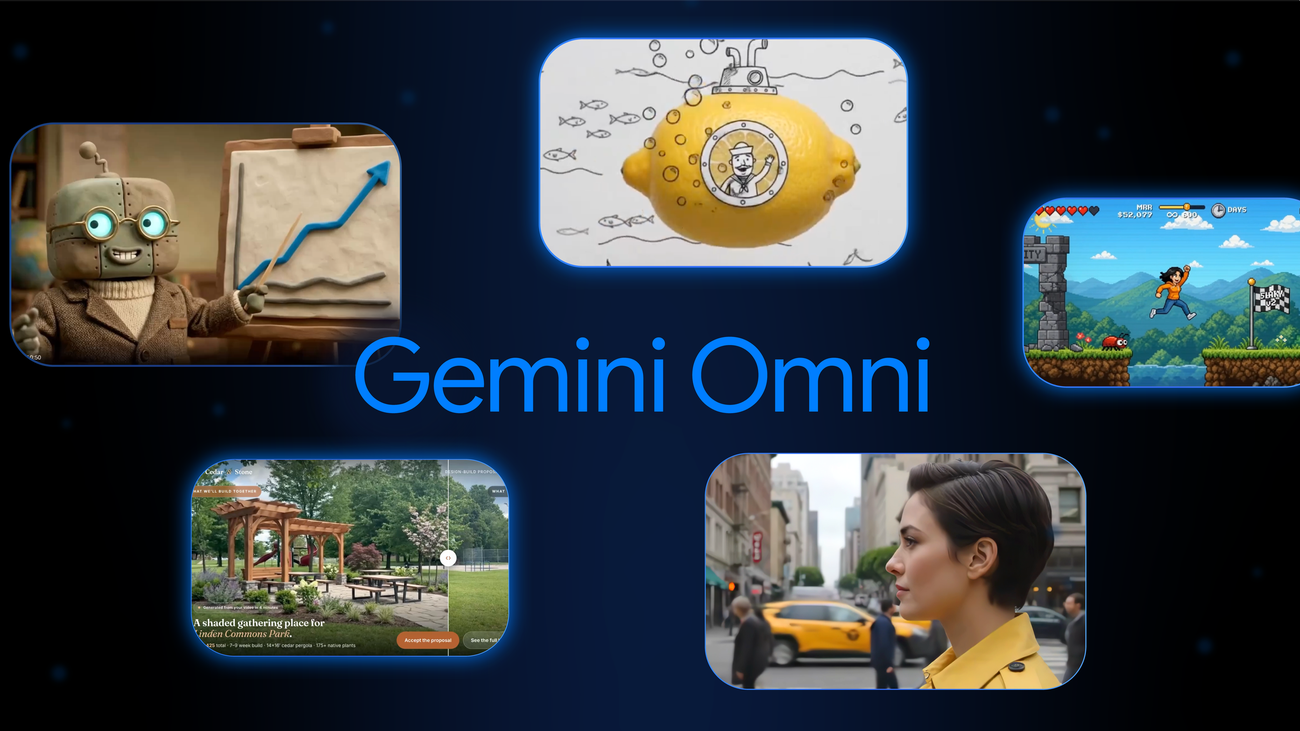
Googleが、動画生成AI「Gemini Omni」で開発者が作った作例を5件、公式ブログにまとめました[1]。1つの場面を約20通りのアングルで撮り直したもの、音声だけで昼を夜に変えて雪を降らせたもの、手描きの落書きを動きの指示として使ったものなど、いずれも会話や簡単な入力だけで動画を組み立てています。開発者向けの提供が始まって約1か月、実際にどこまで動くのかが見えてきました。
1つの場面を約20通りのアングルで撮り直す
最初の作例は、カメラワークの差し替えです。開発者のLeon Lin氏は、街中に立つ女性を写した1本の動画から、約20通りの視点を作り出しました[1]。近景と遠景、正面と横顔、俯瞰と煽りといった具合に、あらゆる角度から同じ人物を捉えています。寄っていくショットもあれば、固定のままのショットもあります。
背景も歩道、横断歩道、街路へと切り替わり、歩行者や自動車、路面電車、建物が入れ替わります。撮影のやり直しなしにアングルだけを差し替えられる点は、絵コンテ段階での検討や、SNS向けに同じ素材から複数パターンを出す場面で効いてきます。
音声指示だけで昼を夜に変え、雪を降らせる
2つ目は、場面そのものを作り替える使い方です。開発者のCarlos Santana氏は、屋外で撮った動画に対して音声だけで指示を出し、照明を昼から夜へ切り替え、曇り空と雨音を足し、葉を紅葉させ、地面を雪で覆いました[1]。
天候や季節は、実写では撮り直しが最も難しい要素です。Googleは、動画内で起きている出来事を編集したり、別の物体に差し替えたりしても、Omniが場面全体のつながりを保つと説明しています。1つの要素だけを変えたつもりが画面全体の破綻につながる、という生成AI特有の弱点をどこまで抑え込めるかが、この機能の実用性を左右します。
落書きを「動きの指示書」として使う
3つ目は、動画編集ツール「Google Flow」上のOmniを使った作例です。手描きのスケッチを実写調の動画に変換でき、落書きの線が個々の要素の動き方を指示する役割を果たします[1]。描き込んだ線を最終的な出力に残すかどうかも選べます。
開発者のPan氏は、この仕組みで身近な物体を次々に変身させました。レモンは海に浮かぶ潜水艦になり、エスプレッソのカップは人を乗せて空を行く熱気球になります。唐辛子2本は眠っている竜になり、驚くと炎を吐きます。マッチはロケットに、はさみは獲物を探すサメに変わります。
文章で動きを説明するより、線を1本引いたほうが速い場面は確かにあります。プロンプトに頼らず、絵として意図を渡せる入力方法が用意されたことは、非エンジニアの利用も想定した設計だと言えます。
1本の動画の中で実写からアニメ、クレイアニメへ
4つ目は、映像のスタイルを丸ごと入れ替える使い方です。参照素材を渡すか、自然言語で仕上がりを説明すると、Omniがそれを1本のクリップとしてまとめます[1]。
開発者のJerrod Lew氏は、Google Flow上のOmniで、街を歩く女性の動画を4種類のアニメーションスタイルで描き分けました。元のクリップは実写からアニメ、クレイアニメへと途切れずに変化し、その間も女性が前へ歩き続ける動きは崩れません。スタイル変換で人物の動作が不自然に途切れないかどうかは、この種のモデルの精度を測るわかりやすい指標になります。
提案資料やダッシュボード説明を動画にする
5つ目は、制作用途から一歩離れた業務向けの作例です。Hyperagentのチームは、Omniで3種類のコンセプトを動画にしました[1]。何もない公園の動画に植栽を重ねてビフォーアフター形式の設計提案にしたもの、業務ダッシュボードを解説するアニメーションの教授を登場させてデータを擬人化したもの、キャラクターがタスクを片付けていく動画でToDoリストをゲーム的に見せたものです。
静止画とスライドで説明していた提案や社内資料を、そのまま動画に置き換える発想です。撮影も外注も挟まずに動く提案書を作れるなら、費用対効果の面で採用されやすい領域と言えます。
提供先と現時点の制約
Gemini Omniは、Geminiアプリ、Google Flow、Google AI Studio、Gemini API、Gemini Enterprise Agent Platformで利用できます[1]。開発者向けの提供が始まったのは2026年6月30日で、モデル名はgemini-omni-flash-previewです[2]。
価格は動画出力1秒あたり0.10ドル(約16円)で、Veo 3.1 Fastと同水準に設定されています[2]。ただし制約も残っており、現時点で生成できる動画は10秒までです。音声リファレンスのアップロードとシーン延長はGemini APIでは未対応で、3秒までの動画リファレンスはAPIの仕様上は受け付けるものの、モデル側が正しく処理できない状態にあります。場面転換やパン操作をまたいだキャラクターの一貫性にも限界があると明記されています[2]。
生成物にはSynthIDによる電子透かしが入り、GeminiアプリやChrome、検索からAI生成コンテンツかどうかを確認できます[2]。
※1ドル159円換算(2026年8月11日時点)
まとめ
Googleが公開した5つの作例は、アングル変更、天候と季節の差し替え、落書きによる動き指示、スタイル変換、業務資料の動画化と、方向性がきれいに分かれています。共通しているのは、いずれも撮り直しや専門ツールを前提にしていない点です。一方で10秒という尺の上限や、場面転換時の一貫性といった制約は残っています。作例の派手さと現時点の仕様の差を踏まえたうえで、どの工程に組み込むかを見極める段階と言えそうです。
出典[1]:https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni-builders/



























