

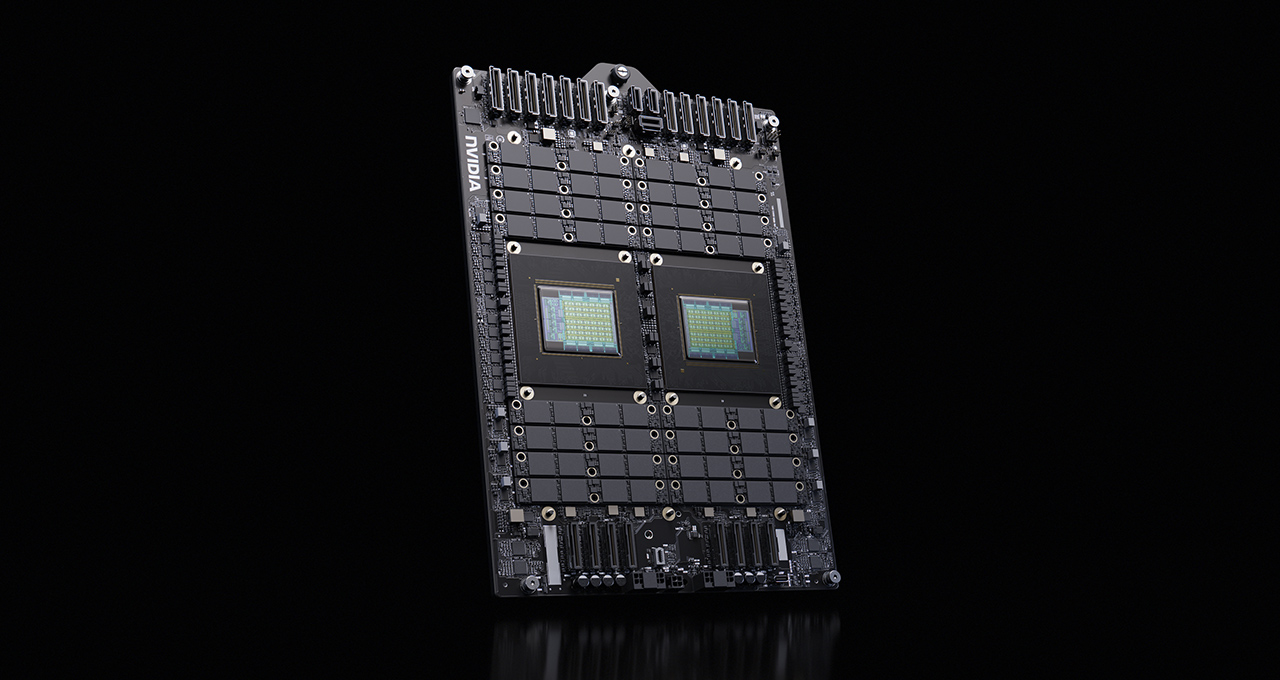
NVIDIA 表示,已将自研的服务器级 CPU「Vera」投入用于设计下一代 CPU 与 GPU 的 EDA(电子设计自动化)流程。公司与以芯片设计工具著称的 Cadence、Synopsys 合作优化相关应用,并称在部分验证环节实现了最高 1.5 倍的提速[1]。其目标是形成「用自家芯片打造下一代自家芯片」的循环。
即便在 GPU 主导的设计现场,仍有依赖 CPU 的环节
现代芯片设计越是追求更先进的 CPU、GPU 与 AI 系统,复杂度就越高。在进入制造之前很久,工程师就要花上数年验证行为、找出边角案例,并通过数千次迭代打磨设计[1]。
其中,仿真、验证与实现环节处于半导体开发的核心。尽管 GPU 与 AI 已经加速了许多设计场景,但逻辑仿真、形式验证以及部分数字实现,至今仍高度依赖 CPU 的性能——包括单核速度、高效的内存结构和整体吞吐量[1]。
因此,CPU 架构会直接影响设计团队验证设计、尝试替代方案并走向 tapeout(将设计数据交付制造)的速度。即便在 GPU 话题更受关注的 AI 时代设计现场,也仍有一些环节考验着 CPU 的底层实力。
借助 Cadence 与 Synopsys 的工具实现最高 1.5 倍
NVIDIA 的初期测试聚焦于主流 EDA 应用[1]。
其一是 Cadence 的形式验证平台「Jasper」,它利用智能证明技术与机器学习,在设计周期的早期发现并修复缺陷,从而提升验证效率[1]。其二是 Synopsys 的「VCS」,这是一款高性能功能验证方案,用于在制造前对复杂芯片设计进行仿真与验证。测试中两款工具都使用了相同的核心数[1]。
结果显示,两者在所选工作负载上都实现了最高 1.5 倍的性能提升[1]。NVIDIA 表示,除了基准测试数字之外,还与两家公司在应用性能分析、软件优化与系统级调优方面密切合作,以在更广泛的流程中提升生产力[1]。不过,这些都是 NVIDIA 自家测试给出的数值,具体的对比条件与设置尚未公开,无法保证在其他环境中同样重现,需要留意。
将 Vera CPU 铺开到整个设计流程
此次投入的 Vera CPU,将 88 个自研「Olympus」核心与高效的 LPDDR5X 内存子系统,以及第二代「NVIDIA Scalable Coherent Fabric」组合在一起[1]。它面向负载沉重的设计应用,力求提供强劲的单核性能、宽阔的内存带宽和稳定的低延迟。Vera 最初于 2026 年 3 月作为面向 AI 工厂的 CPU 推出,如今 NVIDIA 又把它的用武之地扩展到了自家的设计现场[1]。
这些特性在「对延迟敏感的任务」与「横跨计算集群的大规模回归测试」混合的工作负载中尤为见效[1]。执行更快,单次验证耗时就会缩短;吞吐量更高,工程师就能在同样的开发周期内评估更多设计方案、完成更多验证。在设计迭代次数直接决定产品成熟度的领域,这些差距累积起来就会拉开明显差别。
用自家芯片打造下一代自家芯片的循环
在确定处理器的架构与微架构后,工程师会以 RTL(寄存器传输级)描述其大部分行为。随后,逻辑仿真、形式验证、回归测试与数字实现相互配合,把设计落实为可制造的硅片[1]。
由于这些环节彼此关联,验证吞吐量提升后,就更容易在早期发现问题,减少后段代价高昂的返工[1]。NVIDIA 之所以把 Vera 铺开到整个设计流程,背后是「为每类任务分配最合适算力」的思路。在 EDA 中,GPU 与 AI 加速了大量算法,而关键的仿真、验证与实现则交由高性能 CPU 承担,两者协同以加快整个设计周期[1]。
NVIDIA 表示,用自家 CPU 设计下一代 CPU 与 GPU,能在硅片设计、软件优化与系统工程之间形成持续的反馈循环[1]。展望未来,公司计划在 Vera 的基础上,发展出搭载「Rigel」核心的下一代「Rosa CPU」[1]。相关进展也将在 2026 年 7 月 26 日至 29 日于美国加州长滩举行的国际设计自动化会议「DAC 2026」上介绍[2]。
总结
NVIDIA 把自研 Vera CPU 投入用于设计下一代 CPU 与 GPU 的 EDA 流程,借助 Cadence 与 Synopsys 的验证工具实现了最高 1.5 倍的提速。拥有 88 个 Olympus 核心的 Vera,负责 CPU 性能吃重的形式验证与仿真,与 GPU、AI 分工协作。其目标是形成用自家芯片打造下一代芯片的循环,下一步则是基于 Rigel 核心的「Rosa CPU」。所展示的性能数值均来自厂商,仍需等待第三方验证。



























