

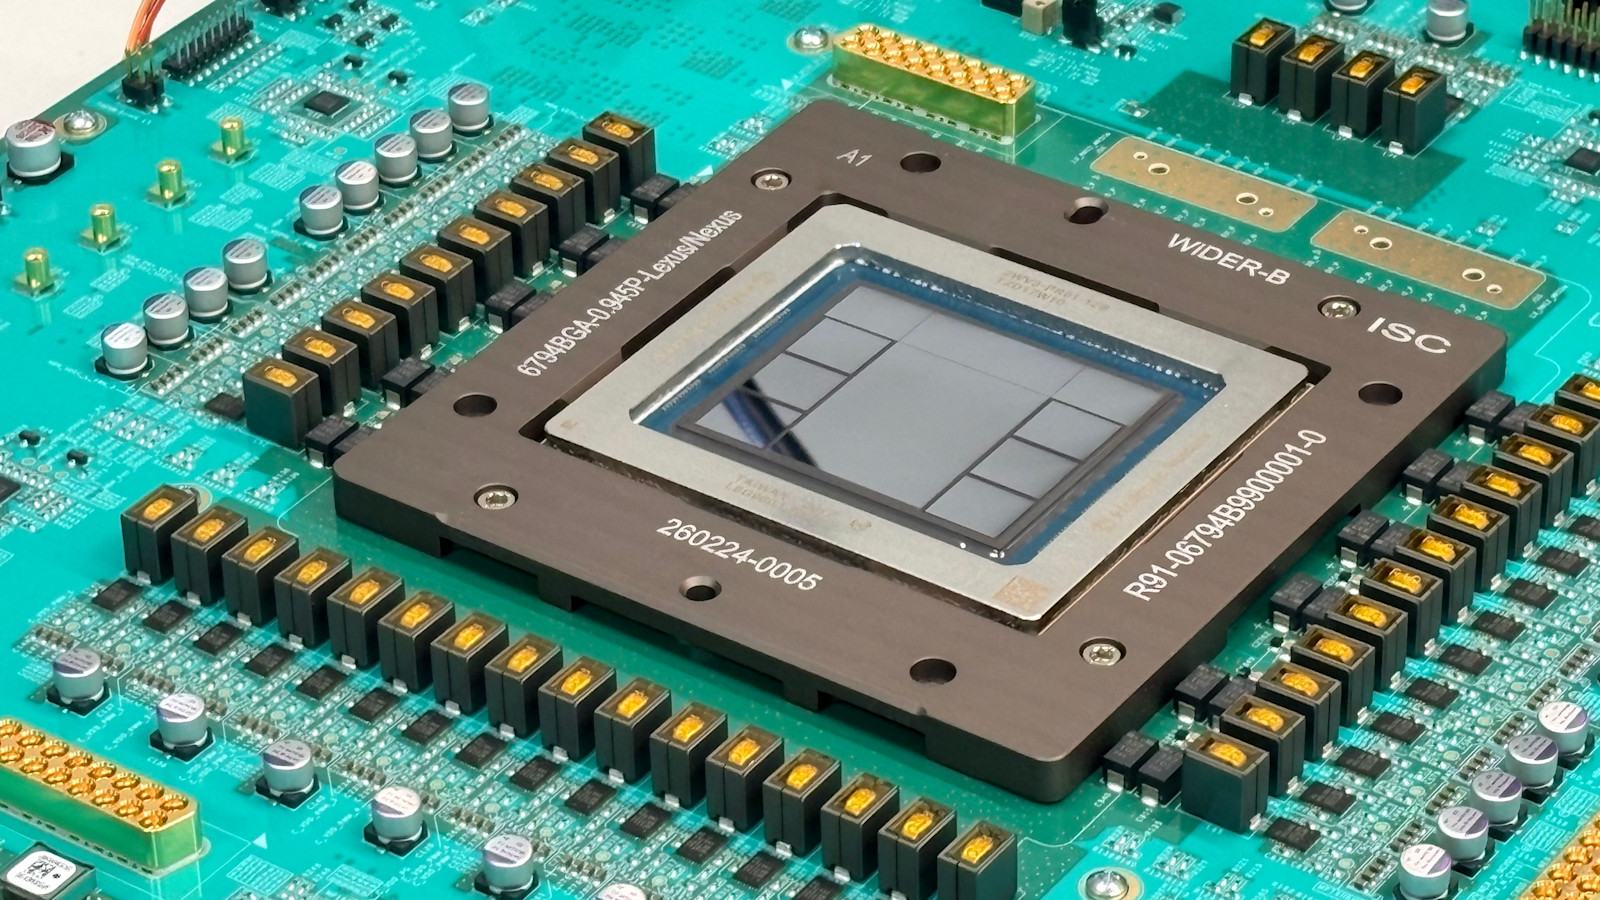
OpenAI 公布了自研首款定制推理芯片 Jalapeño 的首批测试结果[1]。在公开基准测试中与现有商用系统对比,该芯片在单位功耗完成的 AI 工作量上高出 1.5 至 1.9 倍,端到端延迟则低 1.7 至 3.6 倍。吞吐量与低延迟通常此消彼长,但 OpenAI 表示,单一架构同时兼顾了两者,无需在其中取舍。
在公开基准上实测三款模型
测试使用的是 SemiAnalysis 公开的推理基准 InferenceX,它衡量的是处理一次 AI 请求的完整流程。OpenAI 在从高吞吐服务到高交互、低延迟使用的整个测试运行区间内,将 Jalapeño 与市面上主流的商用 AI 系统进行了对比[1]。
参与测试的模型有 3 款:GPT-OSS 120B、DeepSeek R1 670B 和 Kimi K2.5 1T,均为公开模型,既包含 OpenAI 内部开发的成果,也包含外部开发的模型。在这 3 款模型上,Jalapeño 在每瓦性能与延迟的组合上均占优,处于帕累托前沿(不牺牲一项指标就无法改善另一项的临界线)之上[1]。
具体数字方面,峰值吞吐时每瓦完成的工作量提升 1.5 至 1.9 倍,端到端延迟缩短 1.7 至 3.6 倍。若只看交互性较强的负载,性能差距扩大到 2.1 至 4.1 倍。在测试中规模最大的 Kimi K2.5 1T 上,每瓦峰值性能约为 1.5 倍,端到端延迟约缩短 3.4 倍[1]。
OpenAI 还提到,在内部前沿模型上的测试中优势进一步扩大,意味着负载规模越大、要求越高,该架构的收益越明显。不过这部分属于公开基准之外的内部测量,外界无法复现。
额定 700 瓦,实测持续功耗在 550 瓦以内
在比较口径上,OpenAI 主张按单位功耗而非按单颗芯片来衡量。公布的数据依照各加速器公开的芯片功耗值做了归一化处理。Jalapeño 本身额定 700 瓦,但在所测负载下的持续功耗保持在 550 瓦及以下[1]。
需要留意的是,这些仍是 OpenAI 自行实施并发布的测量结果。所用基准本身公开,提高了可验证性,但作为对比对象的主流商用 AI 系统具体是哪些产品并未点名,解读这些数字时应保留这一分寸。
芯片、内存与网络一体化设计
Jalapeño 的出发点是一个问题:如果一款硬件的主要任务就是运行当下与未来的语言模型,尤其是交互式智能体,那么它应该被设计成什么样[1]。
语言模型推理会在两个性质不同的阶段之间往复。处理提示词的预填充阶段以算力为主导,逐个 token 生成回复的解码阶段则更受内存带宽制约。此外,数据每次在核心与芯片之间移动都会带来延迟,等待期间运算单元处于闲置状态。只擅长其中一个阶段的系统,最终会在等待数据时失去优势。
因此,Jalapeño 的设计方向是把数据移动与通信延迟压到最低。包括生成回复时使用的 KV 缓存在内,模型状态可以被显式放置并保留在本地,系统再按推理的不同阶段调动算力、内存与网络的合适组合。网络也被视为架构的组成部分,其较大的域可以让整个负载留在一个互联系统内,从而使一次完整请求自始至终保持快速与高效[1]。
设计与编程环节都有 AI 参与
开发周期之短同样值得注意。从初始设计到流片仅用 9 个月,其间 OpenAI 的模型被用于探索实现方案、缩短设计、测量与验证的循环。AI 还参与了芯片算术电路的优化,使团队得以在既定进度内把更多算力塞进芯片[1]。
文中还写到,Jalapeño 被设计成对人和 AI 都清晰、可预测的编程目标。工程师用本地张量、显式通信和可预测的同步来描述任务,AI 则负责优化这些任务在系统中如何映射、放置、调度与协同。
一个实例是:原本不在量产计划内的 3 款开放权重模型,团队借助 Codex 与 GPT-Astra 在 2 个月内将其性能推到较高水平。在选定的 GPT-OSS 注意力处理和混合专家(按需调用多个专门子模型的结构)模块上,AI 生成的实现比资深工程师编写的实现快 1.5 至 1.8 倍[1]。该数字仅针对选定模块,并非整个模型的性能。
年内进入自有基础设施,NVIDIA 芯片仍会继续使用
Jalapeño 是 2026 年 6 月 24 日与 Broadcom 共同开发并发布的芯片。从设计到制造流片用时 9 个月,板卡、机架与系统层面则有 Celestica 参与[2]。
部署方面,计划在年内开始投入 OpenAI 自有的算力基础设施。路线图以多代演进为前提,第 2 代研发已深入推进,第 3 代也在成形之中[1]。当前阶段仍在进行量产品质验证、软件成熟化、大规模运营准备以及在更多模型上的性能验证。
这并不意味着全面转向自研芯片。OpenAI 明确表示,在训练与推理两方面都将继续广泛部署 NVIDIA 等合作伙伴的加速器[1]。面对持续增长的需求,需要从一切可用来源积累算力,这是现实所在。
总结
OpenAI 公布了自研首款推理芯片 Jalapeño 的初期实测,在公开基准 InferenceX 上给出每瓦性能提升 1.5 至 1.9 倍、端到端延迟缩短 1.7 至 3.6 倍的结果。其解释是,针对预填充与解码性质不同的语言模型推理,将芯片、网络乃至机架级系统一体化设计带来了这一收益。年内即将开始部署到自有基础设施,但数据来自 OpenAI 自身测量,且未公布对比对象的具体信息。第 2 代之后的推进节奏,以及是否会有第三方复现,将是接下来的看点。
来源[1]:https://openai.com/index/jalapeno-first-results
来源[2]:https://openai.com/index/openai-broadcom-jalapeno-inference-chip/



























