

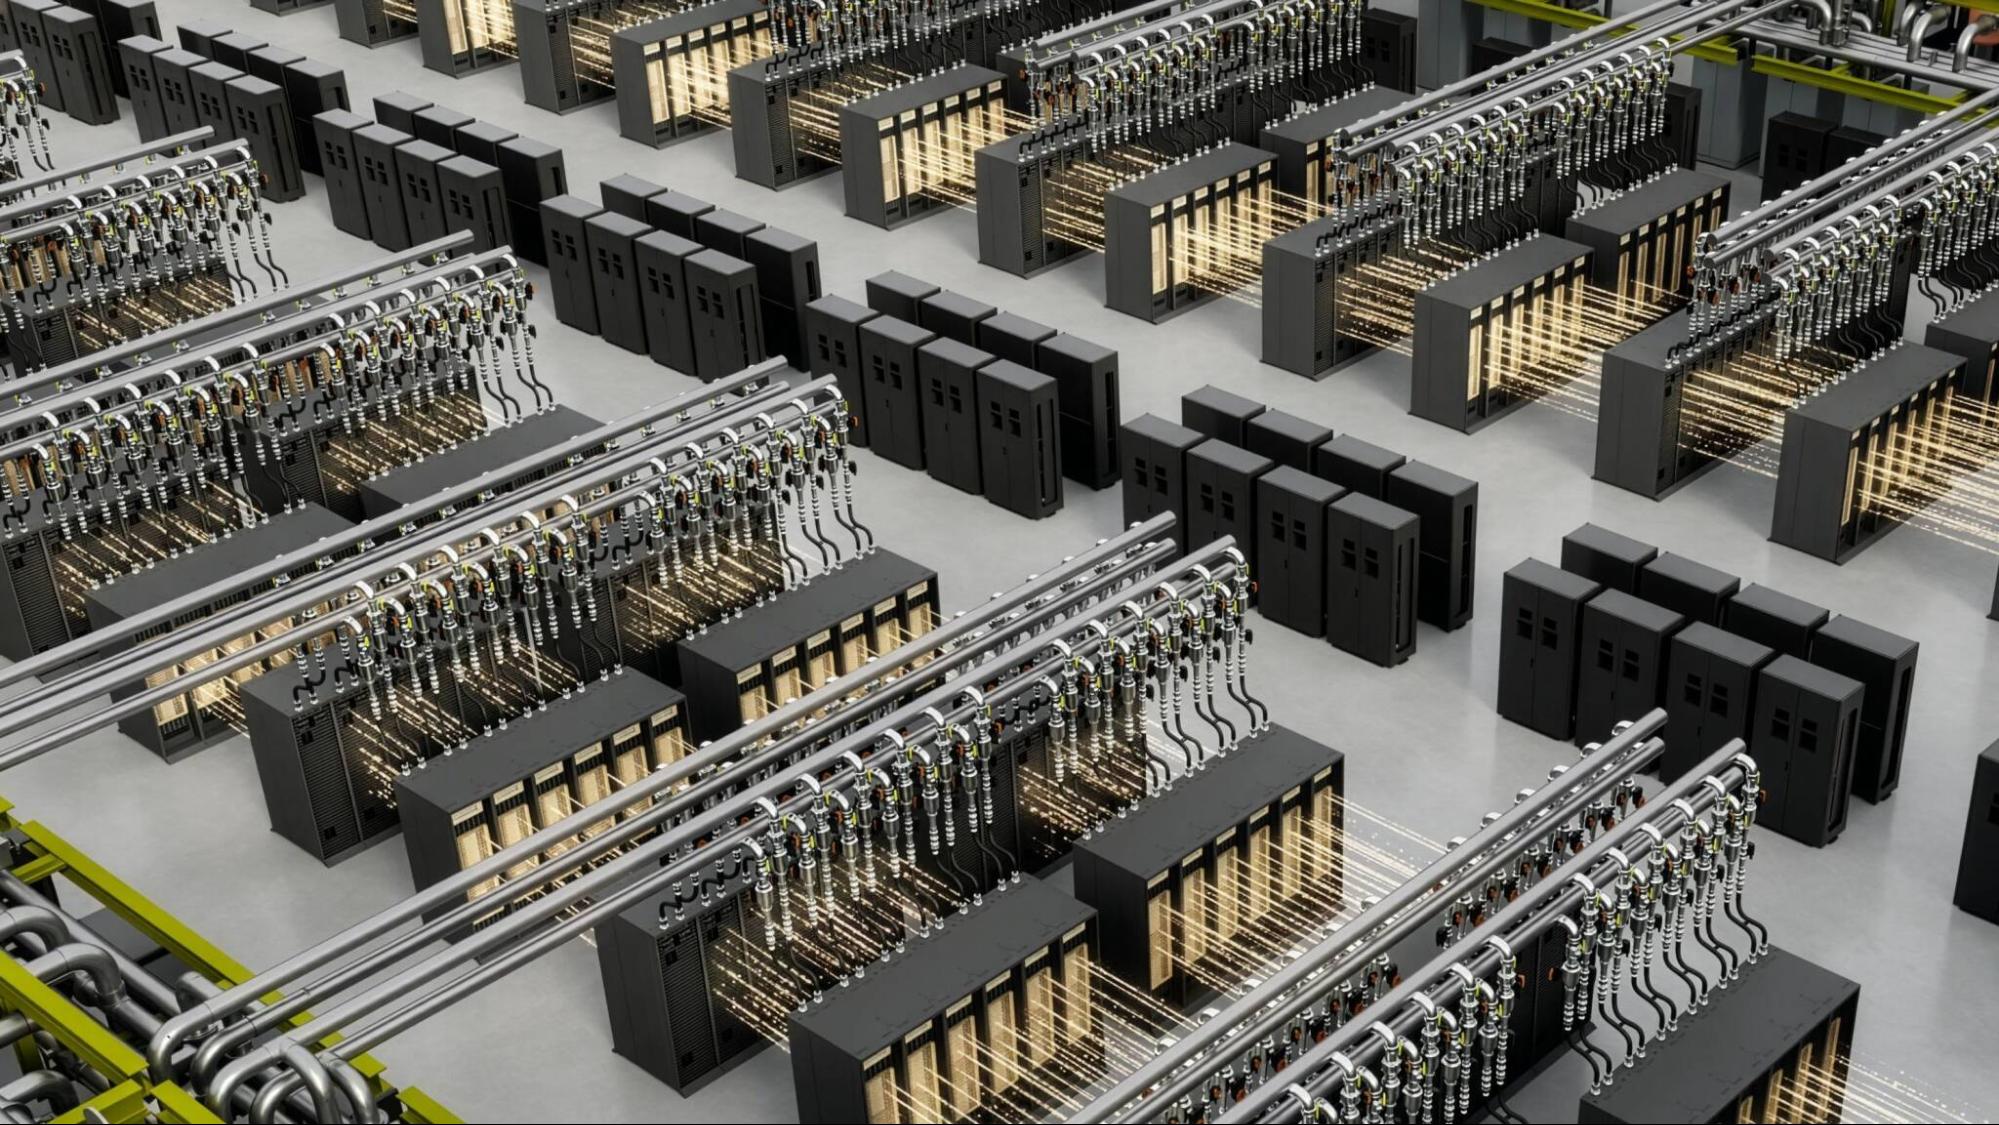
英伟达在官方博客中提出,在电力约束日益收紧的 AI 时代,「每瓦性能」(性能/瓦)才是决定 AI 工厂盈利能力的最重要指标[1]。其核心逻辑是,在固定的电力预算内能生成多少 token,直接决定了收入与利润。英伟达表示,在最新一代主流开放模型上,Blackwell 世代的 GB300 NVL72 实现了较上一代 Hopper 最高 25 倍的每瓦性能。在实际生产环境中,Anthropic、OpenAI 等前沿 AI 公司也已采用 Blackwell 进行推理。
为何「每瓦性能」是最关键指标
对 AI 基础设施而言,电力是无法回避的约束。英伟达解释称,在固定电力预算内能生成的 token 数量决定了 AI 工厂的收入和利润率。仅凭 token 单价或芯片的理论峰值无法衡量真实效率,而每瓦性能只能通过真实运行结果获得、难以人为操纵,因此成为 AI 工厂的根基[1]。
随着自主运行的智能体(agentic)AI 推动 token 需求进一步走高,各机构如今做出的基础设施决策,将在受电力制约的世界中区分出「能扩张」与「无法扩张」的一方。当前几乎所有前沿模型都采用将多个专家模型组合的 MoE(Mixture-of-Experts)架构,而要在机架规模上高效运行,就必须对从芯片到软件的每一层进行一体化协同设计[1]。
Blackwell 实现的最高 25 倍效率提升
据英伟达介绍,在最新一代主流开放模型上,GB300 NVL72 可实现较 Hopper 世代最高 25 倍的每瓦性能。不过该公司指出,这一数值只是 Blackwell 目前所处的起点,改进仍在持续[1]。
由于面向低延迟的工作负载与面向吞吐量、成本的工作负载最优运行点各不相同,英伟达并未用单一数值,而是以每个模型的效率曲线(帕累托曲线)来呈现性能,并提供 DynoSim 等工具,让团队在投入任何一个 GPU 小时进行验证之前就能找到最优点[1]。
这一效率是芯片到软件一体化「协同设计」的成果。决定机架规模性能的 NVLink Switch 在 Vera Rubin 平台上已进入第 6 代,其 SHARP 可在交换机内部完成网络内计算,为 GPU 分担负载。软件方面,NVIDIA Dynamo、TensorRT LLM、SGLang 与 vLLM 叠加了 NVFP4 量化、拆分式服务(disaggregated serving)、大规模专家并行等优化,而且仅靠软件改进效率也在持续提升。在 DeepSeek V4 模型上,每瓦性能在短短一个月内提升了最高 5 倍[1]。
「只有六成可用」的问题与 DSX MaxLPS
英伟达指出,在 AI 工厂中,由于冷却和机架层面的损耗,从电网取得的电力真正用于 AI 处理的可能仅约 60%[1]。
弥补这一差距的,是 DSX 平台中的电力与效率控制软件 DSX MaxLPS。它可在 GPU 与机架之间实时调配电力,并结合温水液冷与电力最优分配等手段,使运营方能在相同电力预算下多运行最高 40% 的 GPU[1]。
生产环境的实绩与采用案例
英伟达强调,要在 AI 工厂规模上稳定运行所需的可靠性并非一朝一夕可得。机架规模系统会出现单节点部署中不会遇到的故障形态,因此生产环境中的运行经验本身就是一种优势。其 Blackwell NVL72 在多样的模型与用途中持续展现出稳定性能与机架级可靠性,正因如此,Anthropic、OpenAI 等前沿 AI 公司才将其用于推理[1]。
具体部署也在扩大。CoreWeave 在 GB300 NVL72 上运行 Kimi K2.6 模型,结合 NVFP4 量化与投机解码技术 EAGLE3 来提升推理性能。Perplexity 在 GB200 NVL72 上运行 Qwen3 235B 以及经过后训练的 Qwen3.5-397B-A17B,每天处理数百万次查询。Fireworks AI 在 Blackwell 上运行 GLM 5.2 模型,支撑 Cursor、Factory AI 等客户的生产环境。这些积累下来的生产经验,为下一代 NVIDIA Vera Rubin 带来了先发优势[1]。
总结
英伟达提出的,是把 AI 基础设施的评价标准从「绝对性能」转向「每瓦性能」。Blackwell 世代的 GB300 NVL72 展现出较 Hopper 最高 25 倍的每瓦性能,DSX MaxLPS 则能在相同电力预算下多运行最高 40% 的 GPU。随着 Anthropic、OpenAI、CoreWeave、Perplexity 等在生产环境中的采用不断扩大,在电力成为最大约束的时代,基础设施的优劣或将直接左右 AI 服务本身的竞争力。
来源:https://blogs.nvidia.com/blog/performance-per-watt-ai-infrastructure-efficiency/



























