

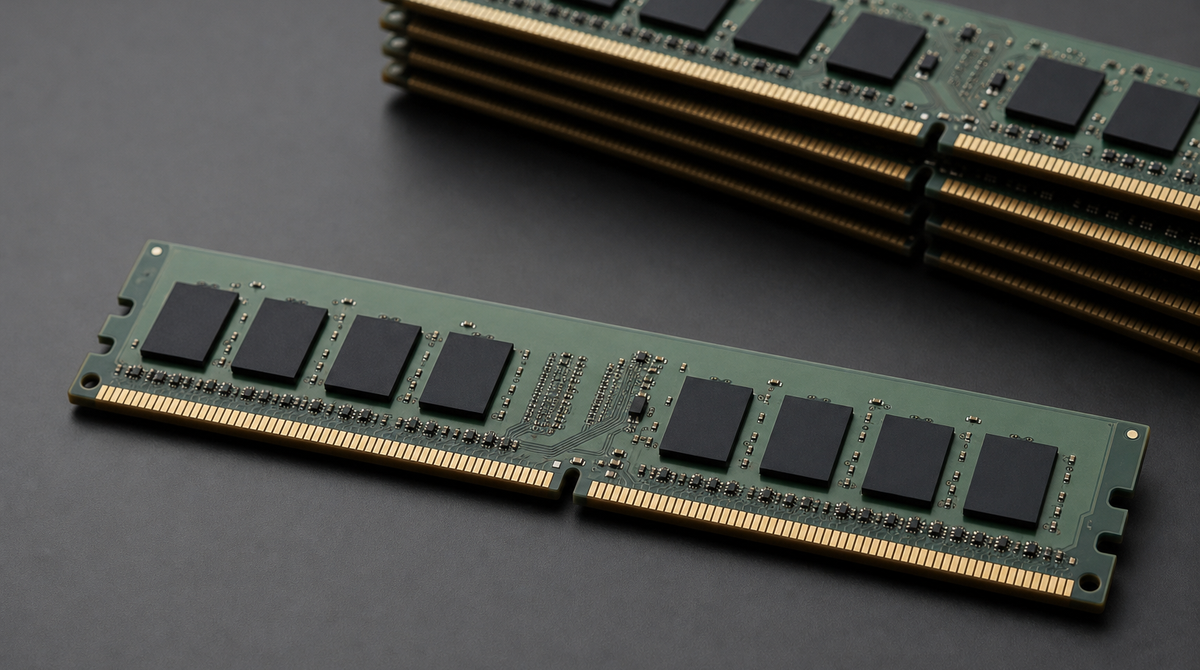
Meta 透露,它正把从退役服务器上拆下的旧一代 DDR4 内存,装进最新的 DDR5 专用机器中重复使用。为新旧两代内存充当桥梁的,是该公司自研的 CXL 专用芯片 Vistara。在内存价格于全球范围上涨的背景下,Meta 表示这一做法可将 AI 推理服务器的数量最多削减 25%,作为一种不必增购硬件即可压低成本的思路而受到关注。
在内存高涨之际浮现的“重复利用”思路
进入 2026 年,AI 的旺盛需求挤压了内存供给,推高了 DRAM 价格。与其一味增购新内存、任由费用膨胀,Meta 转换思路,选择把退役服务器里残留的 DDR4 转用到最新机器上。
通常,把世代不同的 DDR4 与 DDR5 混装在同一台机器里,会引发兼容性问题和很大的延迟代价。Meta 表示,它用自研的 CXL 2.0 ASIC “Vistara” 越过了这道门槛。CXL(Compute Express Link)是一种借助 PCIe 线路把 CPU 与内存等部件高速相连的标准,适合用于内存的扩展与共享。此次成果是在本周举行的计算机体系结构国际会议 ISCA 2026 上公开的技术文档中披露的。
让新旧内存共存的 Vistara 机制
Vistara 的关键,在于它不强行把较慢的 DDR4 与较快的 DDR5 等同看待。在软件层面,Meta 把通过 CXL 接入的 DDR4 当作“没有 CPU 的独立 NUMA 节点”,与直连处理器的 DDR5 节点区分开来管理。所谓 NUMA,是指从 CPU 角度看内存的“远近”(访问速度)存在差异的一种构成方式。
有了这种切分,就能把频繁使用的数据放在高速的 DDR5 上,而把很少被触及的“冷”数据交给较慢的 DDR4 池。理论上,这样就能在不明显损害性能的前提下,用上原本闲置的内存。为了让公开并不支持 DDR4 的平台也能带动这些旧 DIMM,Meta 还改动了 Linux 的 CXL 驱动,并称相关代码要么已并入主线,要么即将被加入。
Vistara 自身的规格也颇为具体。它以符合 CXL 2.0/1.1 的 PCIe Gen5 x16 接口,把 DDR4 内存桥接到主机处理器,并由自研的 RISC-V 处理器负责控制。每颗芯片内置 2 组独立的 72 位 DDR4 通道,最高支持 3,200 MT/s 的速度,若采用 64GB 的 DIMM,则最高可对应 256GB 的容量。
服务器构成与削减效果
搭载这项技术的新型服务器名为“MemServer”,采用 AMD 的 Epyc Turin,具备 158 核心、316 线程的规模。Turin 在规格上仅支持 DDR5,但通过 Vistara,也能接入 DDR4。
每台服务器的内存合计 1TB,其中 CPU 直连的 DDR5-6400 为 768GB,经由 CXL 接入的 DDR4-2400 为 256GB。据 Meta 称,这一方式把 AI 推理服务器的数量最多削减 25%,并将作业重启和内存碎片化带来的额外开销降低了 33%。
不过,这些削减比例是 Meta 自行公布的数值。实际效果会因所处理的模型与负载条件而变化,因此仍需结合第三方的验证一并来看。
也有企业在攻克同一难题
在让新旧内存共存这件事上,并非只有 Meta。韩国的无晶圆厂半导体企业 Panmnesia 也开发了自研的 CXL 控制器,以及支持路径控制的 CXL 交换结构,并于 6 月 29 日在 ISCA 2026 上发表了研究。该公司已向部分客户送样支持 PCIe 6.4/CXL 3.2 的“Fusion Switch”,并表示还在开发对应最新 CXL 4.0 功能的 PCIe 7.0/CXL 4.0 组合 IP 控制器。由此可见,以 CXL 为核心、减轻内存采购负担的做法正在整个行业扩散。
总结
Meta 借助 Vistara 芯片与操作系统层面的管理,把沉睡在退役服务器中的 DDR4 重新唤醒,在抑制内存成本的同时又控制了对性能的影响。在内存短缺持续的 AI 时代,通过 CXL 复用既有资产,正逐渐成为左右硬件经济性的一个现实手段。



























