

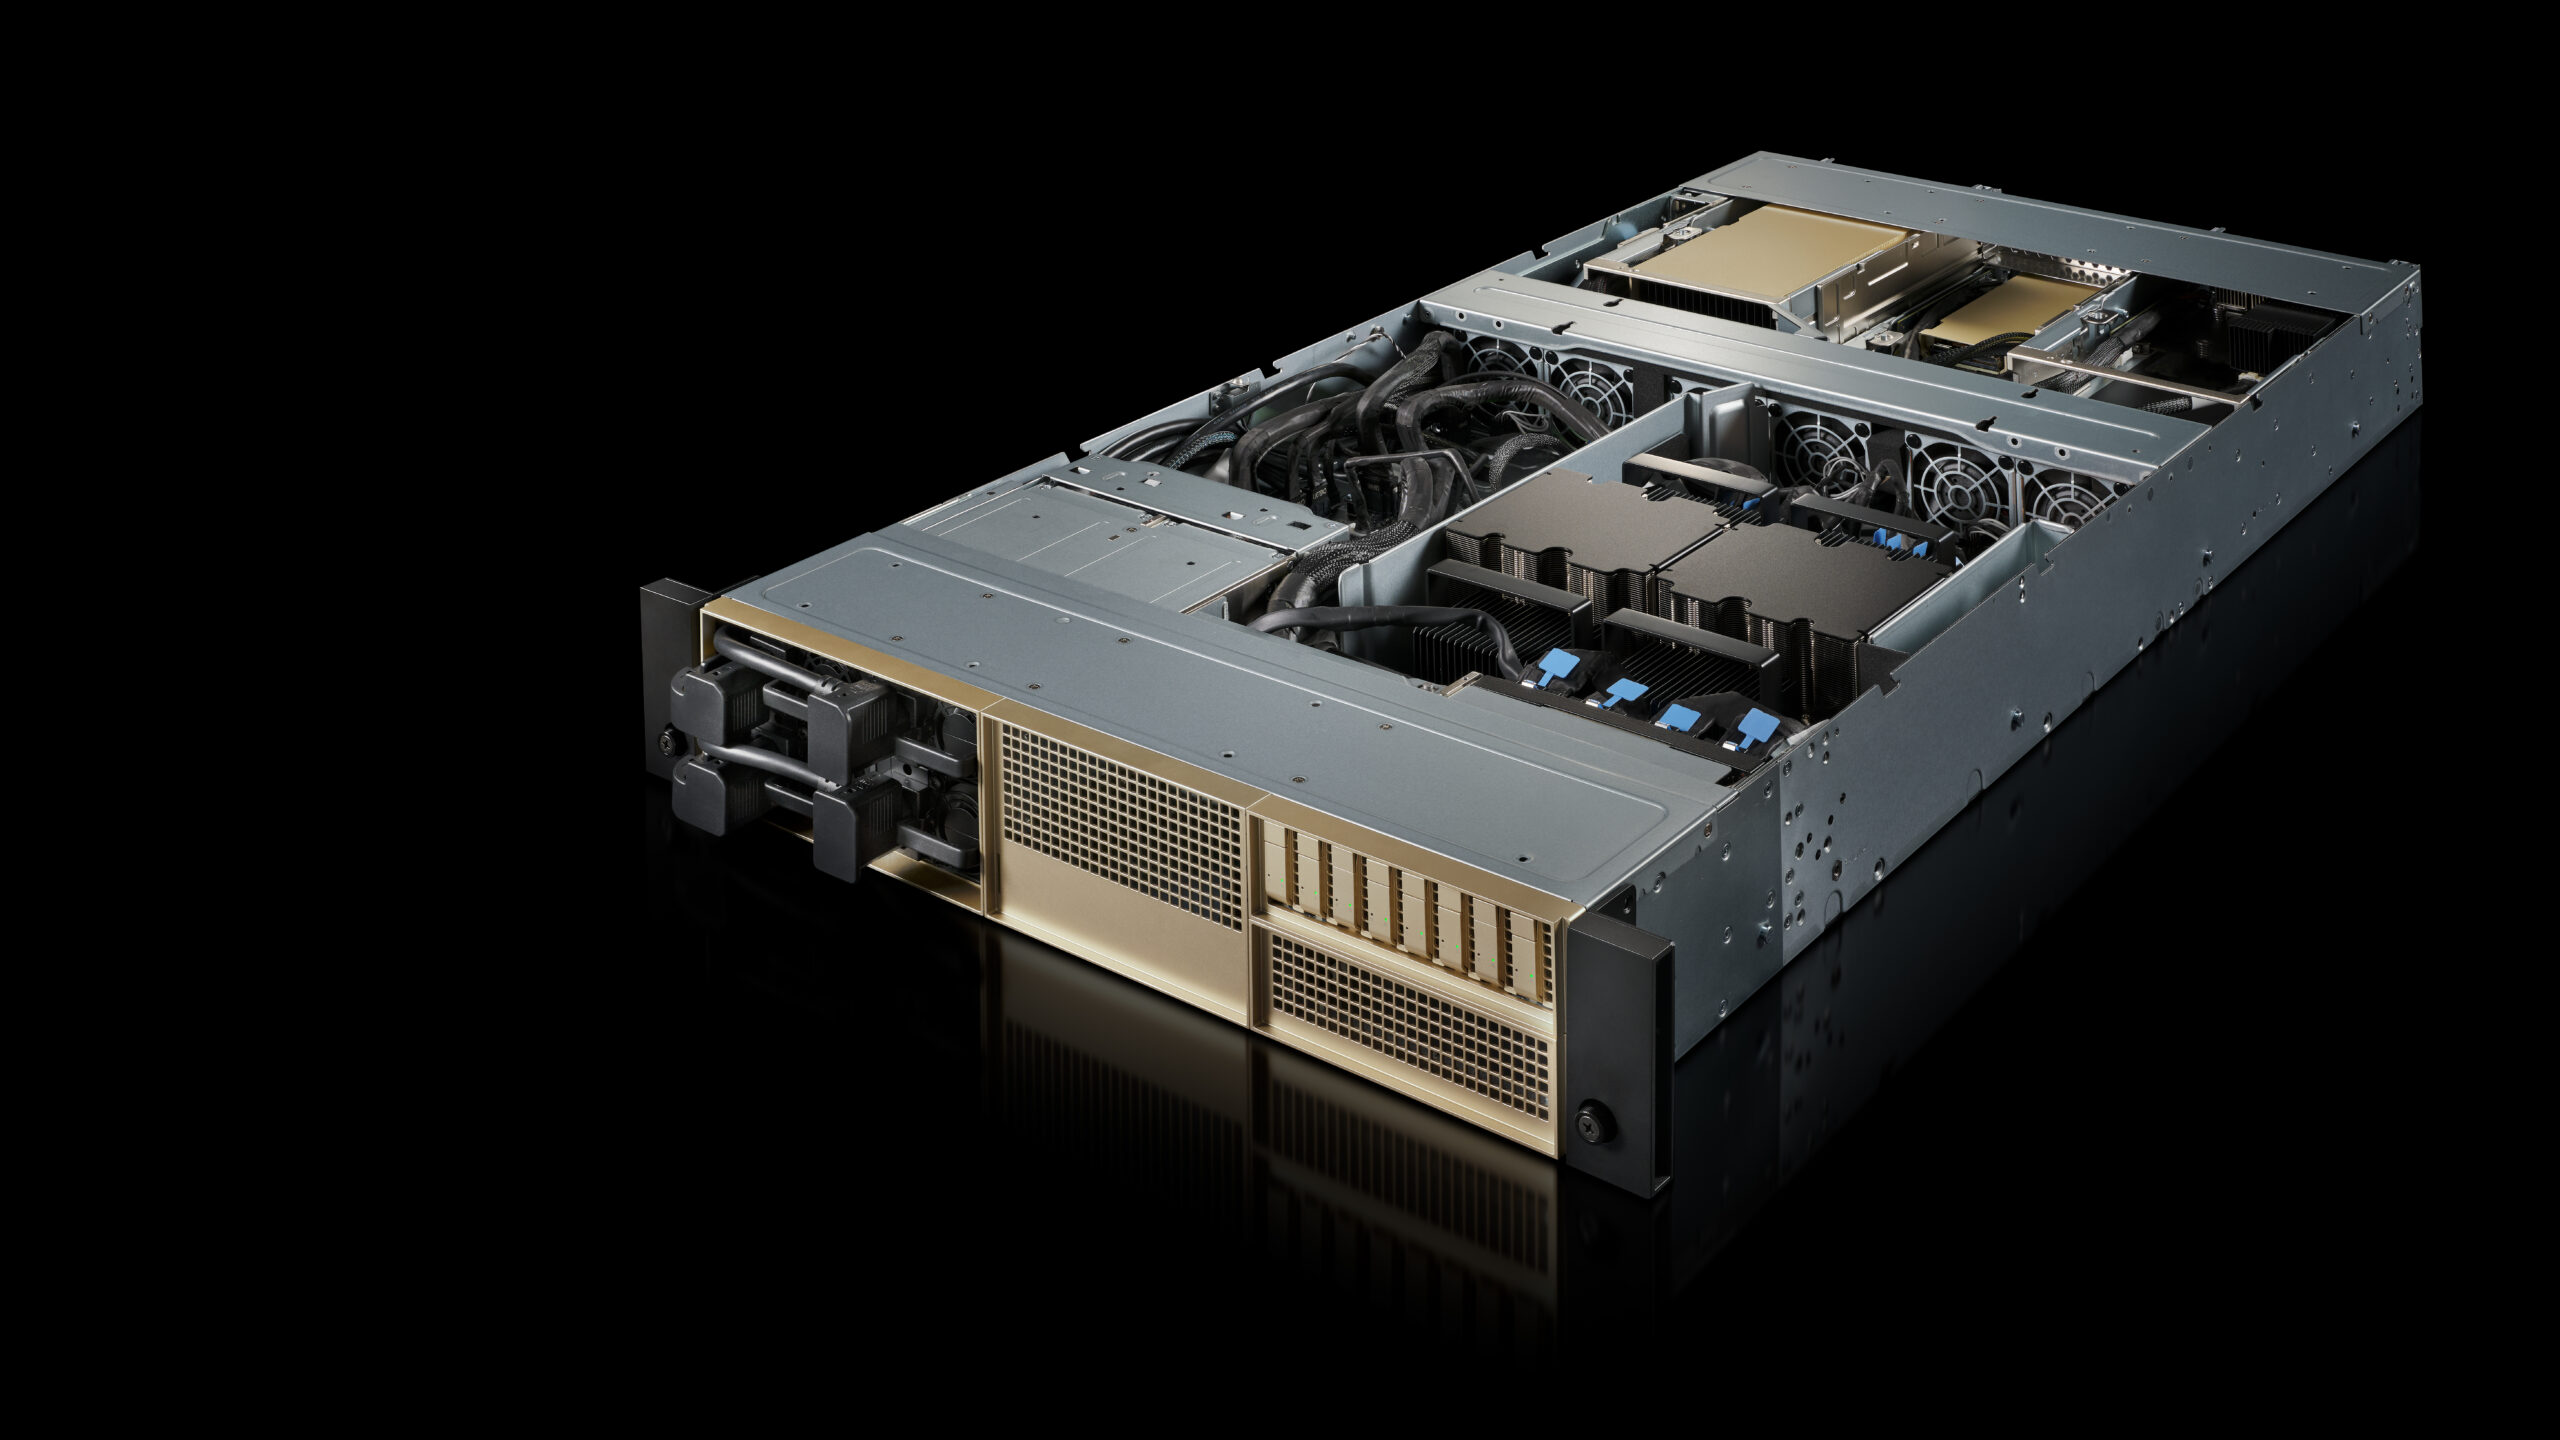
NVIDIAは、独自設計のデータセンター向けCPU「Vera」の初めての公開ベンチマーク結果を明らかにしました[1]。ベンチマークサイトのPhoronixによる測定では、88個の独自コアと毎秒1.2テラバイトのメモリ帯域幅を備え、前世代「Grace」から幾何平均で1.6倍という大きな世代向上を示しています[1]。エージェント型AIの広がりでCPUに求められる要件が変わるなか、IntelやAMDのx86プロセッサに対する有力な対抗馬として注目を集めています[1]。
エージェント型AI時代の新しいCPU要件
NVIDIAは、エージェント型AI(自律的に手順を組み立てて作業を進めるAI)の普及によって、AIファクトリー(AI処理に特化した大規模データセンター)が必要とするCPUの条件が変わってきたと説明しています[1]。具体的には、高速なコア、巨大なメモリ帯域幅、そしてすべてのコアを稼働させても性能を維持し続ける力の3点です[1]。
Veraの中核を担うのが、NVIDIAが独自に設計した「Olympus」CPUコアです[1]。Armv9.2命令セットアーキテクチャ(CPUの基本的な命令体系)に完全対応しており、分岐の多いプログラム実行、隔離環境でのコード実行、データ処理、処理全体の調整といった、エージェント型AIを支える逐次的なCPU処理に向けて設計されています[1]。1枚の半導体ダイにまとめた構造や、第2世代の「NVIDIA Scalable Coherency Fabric」と呼ぶ内部接続によって、88個すべてのコアにデータを滞りなく行き渡らせる狙いです[1]。
Phoronixは、TDP(熱設計電力)が450ワットで、メモリ消費電力が30ワット未満という1ソケット構成のVeraを測定しました[1]。その結果、コードのコンパイル、ファイル圧縮、動画のトランスコード、PythonやJavaの実行、データベース管理など幅広い処理で、この電力枠に収まりながら高い性能を発揮したとしています[1]。これらはAIエージェントやAIファクトリーが日常的に回している、CPU負荷の高い作業そのものです[1]。
メモリ性能で示した「圧倒的な優位」
Veraは第2世代のLPDDR5X(省電力タイプのメモリ規格)を採用し、従来のDDR5メモリに比べてビットあたりの消費電力を大幅に下げています[1]。これにより、従来型CPUがメモリに100ワット超を費やすのに対し、Veraは30ワット未満で最大2倍となる毎秒1.2テラバイトの帯域幅を実現したとされます[1]。
メモリ帯域幅の定番テストである「STREAM TRIAD」では、Veraが定格ピーク性能の90パーセントを維持し、Phoronixがこれまで測定したCPUのなかで最も高い達成率を記録しました[1]。コアあたりのメモリ帯域幅も、従来のx86 CPUの4倍を超えたといいます[1]。Phoronixの創設者で主筆のマイケル・ララベル氏は「VeraはLPDDR5Xメモリにより、現行のIntel XeonやAMD EPYCを上回る圧倒的なメモリ性能上の優位を見せていた」と評価しています[1]。
ピーク性能だけが指標ではありません。AIファクトリーは多数の隔離環境やツール呼び出し、データ処理を同時に走らせます[1]。別の検証では、AIインフラ企業のPrime Intellectが、並列で動かす処理を増やしてもVeraが高い帯域幅と低く安定したメモリ遅延を保ったと報告しており、エージェント型AIに求められる予測可能な性能を裏づけています[1]。
前世代比1.6倍、x86最上位機にも差をつける
世代間の伸びも大きく、前世代の「Grace」CPUと比べて、Phoronixの測定でVeraは幾何平均で1.6倍の性能向上を示しました[1]。ララベル氏は「GraceからVeraへの差は、プロセッサで通常見られる世代間の性能向上に対する私の予想を一貫して上回っていた」と述べ、独自設計のOlympusコアを備えたVeraが、これまでのArm系や非x86のプロセッサでは見たことのない競争力を持つと評しています[1]。
測定対象のなかでVeraは首位に立ち、最新世代の128コアx86プロセッサと比べて全体で1.5倍の性能優位を示しました[1]。実際の開発作業でも差は表れており、1ソケット構成のVeraは標準的なLinuxカーネルをわずか20秒でコンパイルし、Phoronixがそのテストで測定したなかで最速の結果を出しています[1]。コアあたりで見ると、128コア機の2倍の速さでカーネルをコンパイルしたといいます[1]。ララベル氏は「幾何平均でみると、VeraはAMD EPYC 9575F(5.0ギガヘルツの高クロック品)より10パーセント高い性能を出した」とも記しています[1]。
提供は2026年後半、パートナー各社から
NVIDIAは技術カンファレンス「GTC」で、AIネイティブ企業やスーパーコンピューティング拠点、クラウド事業者、インフラ提供企業にまたがる幅広いエコシステムがVeraに対応すると発表していました[1]。すでに主要なAI企業やクラウド事業者へ初期のVera CPUを出荷しており、2026年後半のパートナー提供開始に向けた重要な節目だとしています[1]。
提供形態は、デュアルソケットとシングルソケットの両構成が用意され、空冷と液冷の選択肢も揃います[1]。標準的な企業向けデータセンターから、高密度なエージェント型AIインフラまで、幅広い導入を想定した構成です[1]。
まとめ
NVIDIAの独自CPU「Vera」は、Phoronixによる初の公開ベンチマークで、前世代Graceから幾何平均1.6倍、128コアのx86最新機に対して1.5倍という性能優位を示しました。88個のOlympusコアと毎秒1.2テラバイトのメモリ帯域幅を、450ワットという電力枠に収めた点が特徴です。提供開始は2026年後半を予定しており、IntelやAMDが主導してきたサーバーCPU市場にArm系の有力な選択肢が加わるかどうかが、今後の焦点といえます。



























