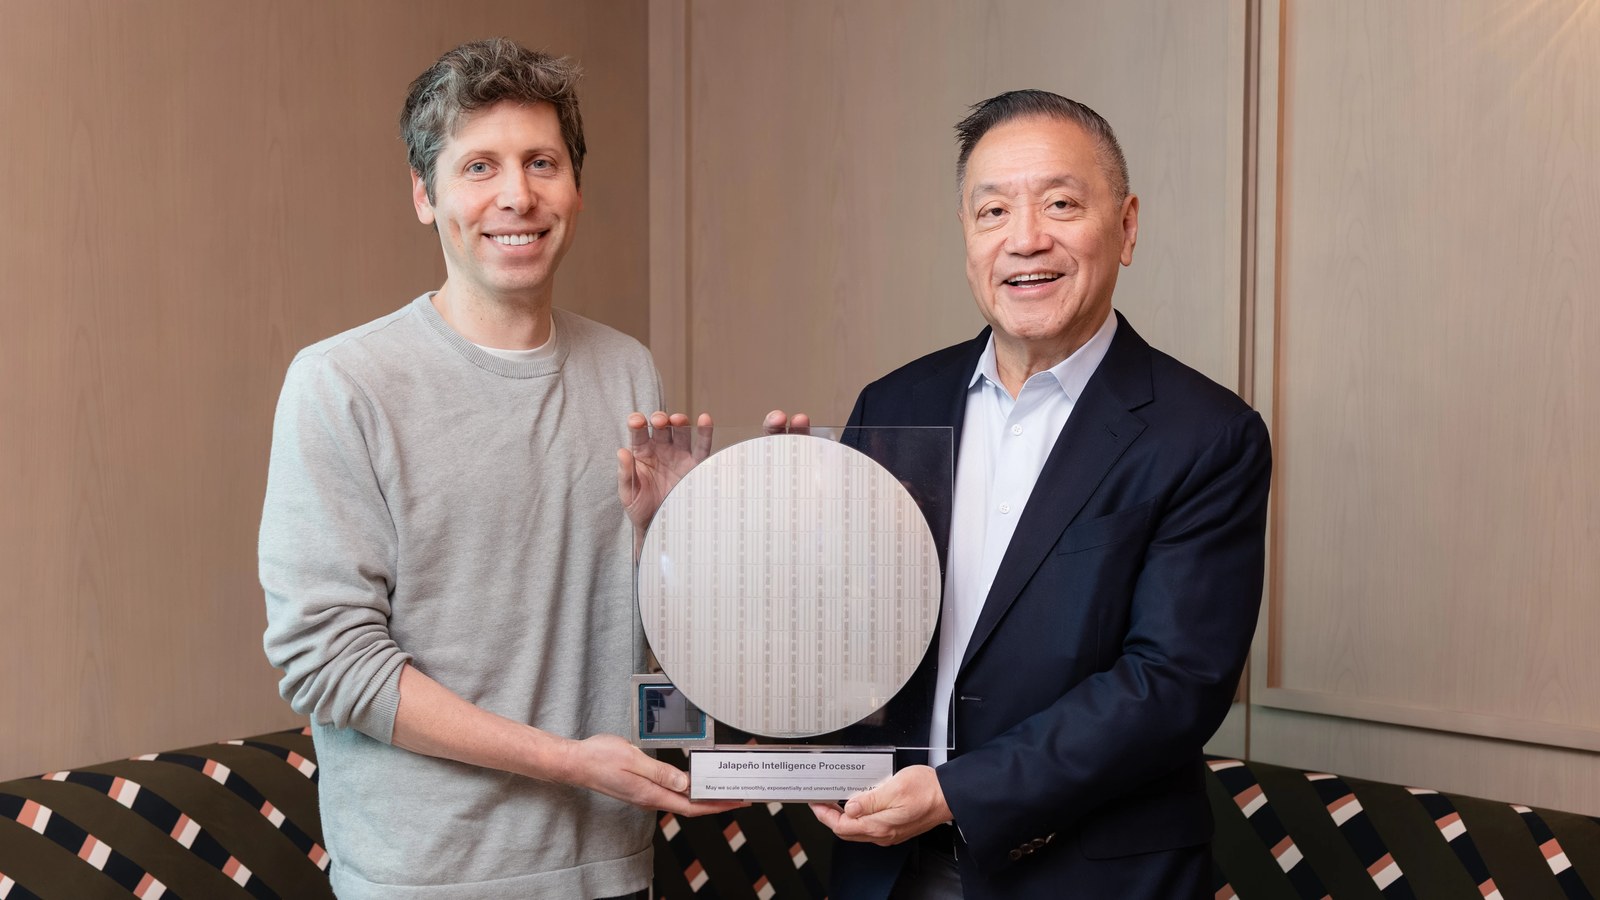
OpenAI 联合半导体大厂博通(Broadcom)发布了首款自研 AI 芯片「Jalapeño」[1]。这是一款专为 ChatGPT 等服务中回答用户提问的「推理」处理而打造的专用芯片,两家公司称从设计到制造仅用 9 个月[1][2]。早期测试显示,其每瓦性能有望大幅超越当前最先进水平,并计划于 2026 年底开始在数据中心大规模部署[1]。
「Jalapeño」是怎样一款芯片
Jalapeño 是 OpenAI 称之为「Intelligence Processor(智能处理器)」的自研 AI 加速器(专门用于加速 AI 计算的芯片)[1]。这里所说的推理,指训练完成的 AI 模型针对用户问题组织答案的过程,ChatGPT 生成文本便属于这一环节[3]。
其特点在于,它并非由现有 GPU 改造而来,而是为大语言模型(LLM)的推理从零设计[1]。OpenAI 基于自身对模型、内核与服务系统的理解来确定芯片架构,力求减少数据搬运、平衡算力、内存与网络资源,从而逼近理论峰值的实际性能[1]。该芯片在博通高层将其交给 OpenAI 首席执行官 Sam Altman 与总裁 Greg Brockman 时正式亮相[1]。
9 个月开发与性能预期
OpenAI 表示,从设计启动到制造流片(tape-out,即确定量产设计)仅用 9 个月,并将其定位为高性能半导体领域最快的 ASIC(专用集成电路)开发周期之一[1][2]。设计与优化的一部分动用了 OpenAI 自家的 AI 模型,称由 AI 协助芯片设计可缩短开发周期[1]。
性能方面,放置在实验室的工程样片已在面向量产的频率与功耗下运行实际的机器学习任务[1]。据称其上正在运行包括「GPT-5.3-Codex-Spark」在内的模型[1]。作为早期测试结果,该公司称每瓦性能有望大幅超越当前最先进水平[1]。不过最终性能仍在测量中,详尽的技术报告计划在数月内公布,目前的数字仅为 OpenAI 一方的说法[1]。
制造方面由博通负责硅实现与网络技术(包括名为 Tomahawk 的通信芯片),Celestica 则负责电路板、机架与整体系统的组装[1][2]。
支撑 ChatGPT 的「全栈」战略
OpenAI 将此次的芯片定位为「全栈」战略的一环——连模型与产品之下的基础设施也由自家设计[1]。通过让从芯片架构到内核、内存、网络、任务调度乃至部署机制都围绕同一目标进行优化,以更快、更省、更稳定地运行自家模型[1]。
推理是 AI 触达用户的接点,该公司认为成本、速度与可靠性的改善会直接转化为 ChatGPT 回答更快、开发者使用 API 的费用更低[1]。Jalapeño 被视为跨越多代的算力平台的第一步,将以 2026 年底的初期部署为起点,与包括微软在内的数据中心合作伙伴一道,以吉瓦级规模逐步扩展[1][2]。
对英伟达独大格局的一记冲击
主流媒体将此次发布解读为缓解对 AI 半导体份额遥遥领先的英伟达依赖的举措[3]。在谷歌、亚马逊等大厂纷纷推进自研芯片之际,OpenAI 也凭借拥有自家专用半导体,加入了使算力采购多元化、压低成本的潮流[3]。不过,Jalapeño 实现量产并在真实运行中证明实力尚需时日,公布的性能优势能否在现场重现,还有待今后验证[1][3]。
总结
OpenAI 与博通发布的「Jalapeño」是该公司首款专为 LLM 推理打造的自研 AI 芯片。从设计到制造仅用 9 个月,号称每瓦性能超越当前最先进水平,但最终性能仍在测量,详尽报告尚需数月。博通与 Celestica 支撑生产,并计划自 2026 年底起与微软等伙伴以吉瓦级规模部署。它是 OpenAI 自行设计基础设施这一全栈战略的象征,能在多大程度上撼动英伟达独大的 AI 半导体格局,将是今后的看点。
来源:https://openai.com/index/openai-broadcom-jalapeno-inference-chip