NVIDIAは、ロボットや自動運転車などの物理AI(フィジカルAI)向けに、新しい世界基盤モデル「Cosmos 3」を発表しました[1]。COMPUTEX で開かれた NVIDIA GTC Taipei で公開されたもので、テキスト・動画・画像・環境音・行動を1つのモデルで扱い、現実世界の文脈をふまえた学習用データを生成できる点が特徴です[1]。
「Cosmos 3」とは ― 行動データまで生成する世界基盤モデル
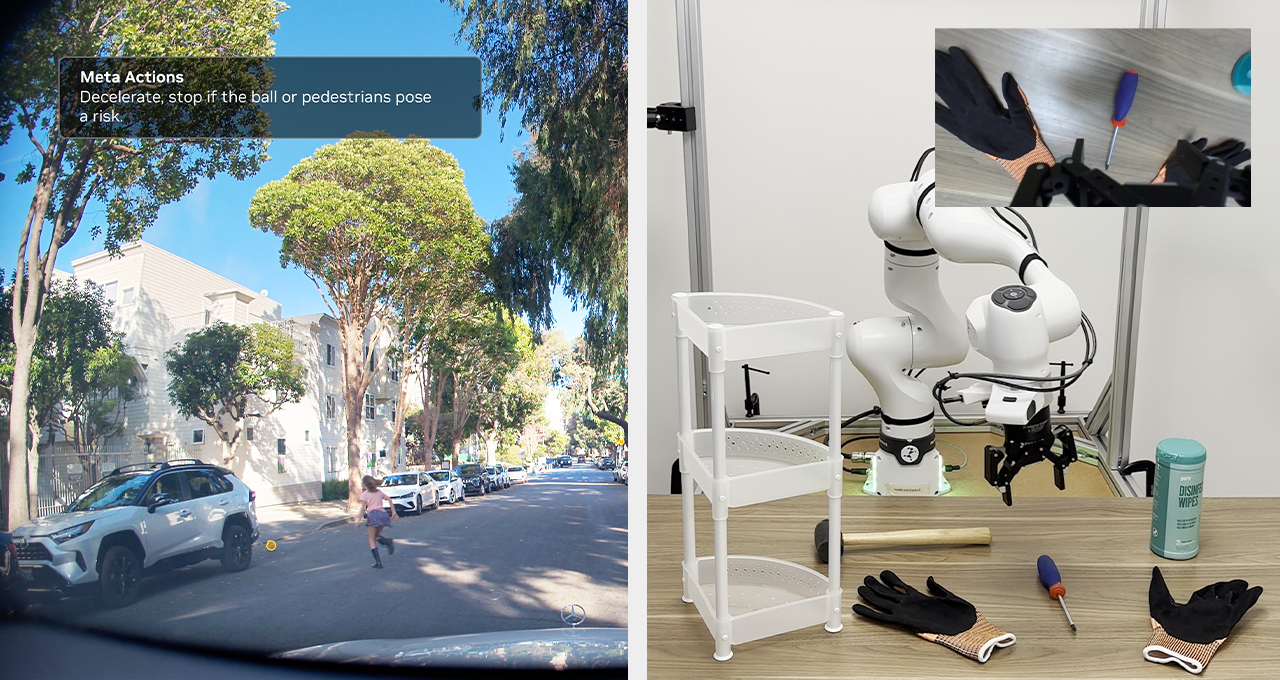
現実世界は常に動いています。ロボットや自動運転車(AV)、スマート空間といった物理AIが自律的に動くには、目の前で何が起きているかや、その原因だけでなく、「次に何が起きそうか」までを理解する必要があります[1]。倉庫では見たことのない物体の配置に出くわし、路上では駐車車両の間から歩行者が飛び出すこともあります。工場の安全システムは、フォークリフトの存在を検知するだけでなく、それがどこへ向かうのかを予測しなければなりません[1]。こうした場面を現実で集めて再現するのは時間も費用もかかり、大規模に繰り返すこと自体が難しいケースもあります[1]。
Cosmos 3 は、この課題に取り組むために作られた世界基盤モデルです[1]。多様なデータで学習した汎用モデルで、シーンや動き、ロボットの動作がどう関係するかを幅広く理解します[1]。さらに「行動生成」をネイティブに備えたオムニモデルで、関節の角度やグリッパー(把持部)の位置、軌道の座標といった数値的な行動データを直接出力できます[1]。ロボットが学習するには、シーンの画像や動画だけでは足りません。たとえば物をつかんで置く作業では、手を伸ばし、握り、運び、置くという一連の動作を導く行動の信号が要ります[1]。開発者は Cosmos 3 を微調整(ファインチューニング)し、特定の機体構成やカメラ配置、作業空間、タスクに合わせて専用化できます[1]。
推論ブロックと生成ブロックの2段構え
Cosmos 3 は、複数のトランスフォーマーを組み合わせる「mixture-of-transformers」と呼ぶアーキテクチャを採用しています[1]。まず推論ブロックがシーンで何が起きているかを解釈し、その文脈を生成ブロックが受け取って、物理的に筋の通った出力を作ります[1]。出力は合成動画から、ロボットのタスク用データまで多岐にわたります[1]。
つまり Cosmos 3 は、知覚(perception)・予測(prediction)・行動(action)を1つのモデルで支える設計です[1]。シーンの中でどの物体が動いているか、経路がどこで交差しそうか、次にどんな状態になりそうかを推論し、詳細な説明文や予測されるシーンの変化、状況のバリエーションを生成できます[1]。
ロボット・自動運転・スマートシティでの活用
NVIDIA の GEAR チームは、Cosmos 3 を使ってビデオ行動モデルを開発しています[1]。ゲームやシミュレーション、現実世界のロボット環境をまたいで、身体を持つエージェントが推論し、動き、行動する方法を学べるようにする取り組みです[1]。
ヒューマノイドなどを手がける Agile Robots は、Thor 3 や FR3 といった機体で産業向けの作業を自律的かつ正確にこなすことを目指しています[1]。同社は Cosmos 3 を使って行動条件付きのロボットデータを生成し、多様なタスクの軌道を大規模に作り出してポリシー(制御方針)開発に役立てています[1]。NVIDIA によれば、Cosmos 3 Nano を事後学習させたポリシーは、言語で指示するタスクをシミュレーションで評価する「RoboLab」や、実機の DROID ロボットでポリシーを比較する「RoboArena」で首位に立っているとしています[1]。
スマートシティや産業向けソリューションを開発する Linker Vision は、Cosmos の視覚言語推論機能を活用しています[1]。数千に及ぶカメラ映像をリアルタイムで解析し、空間的な状況を理解して有用な知見を引き出し、原因の分析までを行うといいます[1]。NVIDIA は、Cosmos 3 がスマートインフラのシーン理解を測る「VANTAGE-Bench」や、交通異常の推論を測る「TAR challenge」でトップのオープン視覚言語モデルだとしています[1]。
衝突や、めったに起きない長い裾野(ロングテール)のケースは、ヒューマノイドやアームロボット、手術支援ロボットを現実に備えさせるうえで重要ですが、安全に・繰り返し・大規模に集めるのは困難です[1]。Cosmos 3 は動画基盤モデルとして、物理的に妥当な動画シーケンスを生成し、現実世界が時間とともにどう変化するかを学ばせることができます[1]。
ベンチマークと入手方法 ― オープンモデルとして公開
NVIDIA によれば、Cosmos 3 の各バリアントは Artificial Analysis のオープンウェイト系ランキングで首位につけており、「Physics-IQ」「R-Bench」「PAI-Bench」など世界生成に関する複数のベンチマークでもトップだとしています[1]。
開発者は build.nvidia.com 上で Cosmos 3 を試し、Hugging Face からオープンモデルをダウンロードできます[1]。GitHub 上のリソースを使ってモデルをカスタマイズしたり合成データを生成したりでき、NVIDIA NIM マイクロサービスでの展開にも対応します[1]。ライセンスは Linux Foundation の「OpenMDW 1.1」を採用し、重みやアーキテクチャ、ドキュメント、データセット、ベンチマーク、コードといった素材を、モデル中心の単一ライセンスのもとで学習・改変・再配布・展開できます[1]。発表は、NVIDIA 創業者兼 CEO のジェンスン・フアン(Jensen Huang)氏による GTC Taipei の基調講演に合わせて行われました[1]。
まとめ
Cosmos 3 は、知覚・予測・行動を1つにまとめ、行動データまで生成できる物理AI向けの世界基盤モデルです[1]。ロボットや自動運転、スマートシティといった「現実に働きかけるAI」が抱える学習データ不足という共通課題に対し、合成データと未来予測で答えようとする点が新しいといえます。オープンモデルとして公開され、すぐに試せる導線が整っていることもあり、物理AI開発の裾野を広げる動きとして注目されます。
出典:https://blogs.nvidia.com/blog/cosmos-3-physical-ai-open-world-foundation-model/